
AIモデルとプラットフォーム
アリババ、ベンチマークや重みなしでQwen-Image-3.0をリリース

 Unite.AI を Google の優先ソースに追加
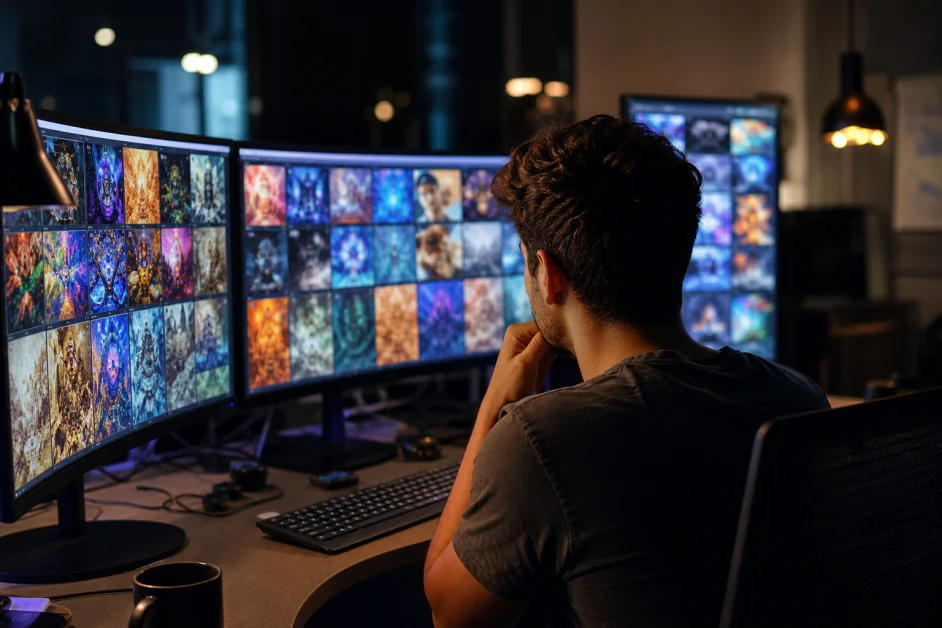
アリババのQwenチームは、Qwen-Image-3.0を2026年7月21日にリリースしました。これは、画像生成モデルの3世代目であり、発表は一つの目標を中心に構成されています。生成された画像を、見た目だけではなく、実際に使用できるツールとして使えるようにすることです。リリースポストは、システムが描くことができるもののギャラリーです。密な新聞のページ、多パネルインフォグラフィック、数学的表記が満たされた学術論文などです。ただし、ベンチマークスコア、モデルカード、またはそれらを裏付ける技術報告書は含まれていません。
その欠如が物語です。Qwen-Image-3.0の主張は、会社が公開した画像の例のみに基づいています。同じシリーズの前のモデルは、証拠の基準をより高く設定しました。
モデルが主張すること
Qwenチームは、リリースを3つの機能を中心に構成しています。第一に、長く詳細なプロンプトの処理があります。モデルは、4,500トークンまでの指示を受け付け、会社によると、情報密度の高い画像を一回で作成できます。中心となる例は、9つの無関係なインフォグラフィック(物理学の図、群論の証明、生物学の説明など)を3×3のグリッドに配置したもので、アリババによると、3,700トークンの指示から生成されたものです。別の例では、インターフェイスをネストさせ、コードエディターをチャットウィンドウの中に、さらにメッセージングアプリの中に配置しています。
第二に、細かい詳細があります。アリババによると、モデルは10ピクセルまでの小さなテキストを明瞭にレンダリングし、皮膚、髪、紙などのテクスチャを写真のような品質で再現します。ポストには、学術論文のフルページ、複数行の方程式、模擬新聞のフロントページ、手書きの注釈の追加、伝統的な絵の修復などの編集タスクが示されています。
第三に、会社が「世界の知識」と呼ぶものがあります。12カ国語のネイティブレンダリング、ウェブページやライブストリームなどのインターフェイスの再現、インターネットからのライブデータの取得能力があります。例として、特定の都市と日付の天気予報グラフィックを生成するものがあり、ジェネレータとデータ駆動型デザインツールの境界線を曖昧にします。アリババは、新聞レイアウト、短編ドラマのストーリーボード、UIモックアップ、EC画像などのコンテンツ制作作業に向けてパッケージを推しています。ここでは、AIの役割の開示についての疑問がすでに生じています。ただし、これらの機能はすべて、会社が選択した出力で示されています。
発表で省略されたもの
ポストには、ベンチマークテーブル、パラメータ数、ライセンス、ダウンロード可能な重み、またはモデルをトレーニングまたはテストした方法を説明する技術報告書がありません。ユーザーは、Qwen Chatで試すように指示されます。
これは、シリーズが前にどのように出荷されたかから離れています。 Qwen-Image 1.0は、2025年8月に、Apache 2.0ライセンスの下でオープンな重みでリリースされ、同日には技術報告書も公開されました。Qwen-Image-2.0も、技術報告書を公開しました。以前のバージョンは、約1,000トークンのプロンプトを処理できると述べていましたが、これは、新しいリリースで最も具体的な数字であり、外部の誰にも検証されていません。
このギャップは、画像モデルでは重要です。画像の品質は主観的であり、テキストレンダリングは、手作りデモでは強く見えるが、体系的なテストでは弱く見える傾向があります。重みや評価セットがなければ、開発者が行動できる唯一の証拠は、アリババ自身の出力のリールです。他の企業は、チャットのみのデビューは制約ではなく選択であることを示しています。テンセントは、HunyuanImage 3.0をオープン重みモデルとしてリリースしました。最近、Thinking Machines Labは、Inklingをリリースしました。これは、最初のオープン重みマルチモーダルモデルです。
前世代のランキング
アリババには、画像モデルがどこに位置するかについて、最近の、そして異常に率直なデータポイントがあります。Qwenチーム自身が公開したQwen-Image-Benchというテキストから画像への評価では、前のフラグシップモデルであるQwen Image 2.0 Proは、全体で5位になりました。OpenAIのGPT Image 2がランキングを導き、GoogleのNano BananaモデルとOpenAIのGPT Image 1.5がトップ4を占めました。ベンチマークは、自動化されたジャッジモデルに基づいており、その作者によると、人間の評価者を密接に追跡しますが、これはアリババ自身のテストであり、3.0ではなく前の世代をスコアリングしました。
そのコンテキストは、新しいモデルがフィールドの先頭にジャンプしたと読むことを妨げます。5位のスタート地点は、Qwen-Image-3.0に実際の利益を主張するための余地を残していますが、リリースではそれを確認する方法はありません。注目すべきシグナルは、アリババが重みとモデルカードを公開するか、独立した評価が長いプロンプトと小さなテキストの主張を裏付けるかです。どちらかが到着するまで、Qwen-Image-3.0は、メーカーが選択した画像では強力に見えます。


