
Andersonの視点
AIは写真の撮影年を人の年齢から推測できる

 Unite.AI を Google の優先ソースに追加
新たな研究により、AIは人の顔から年齢を推定し、既知の生年と組み合わせることで、写真が撮影された年を推測できることが示された。この手法は、現在のシーンベースの手法を上回る。
写真の撮影年を推測することは、かつて髪型や服装の流行が猛烈な速さで変化していたため、今よりかなり容易だった。さまざまな議論を呼ぶ理由から、この視覚的スタイルの移り変わりは約30年前に止まった。そのため、髪型や衣服だけを見て、その視覚的な手掛かりから年を当てることは、もはやそれほど簡単ではない。
また、しばらくの間は、フィルムの色再現性や粒子の特性から写真や映画の年代を特定することもできた。法医学の専門家である必要はない。古い映画を十分に見ていれば、音楽、自動車、ファッション、話題などの文化的な手掛かりとフィルムの種類や質感が、見る人の中で次第に結び付いていくからだ。

フィルムの改良が皮膚の色や照明スタイルの範囲を拡大した様子を示す図。 ソース (私の記事)
写真が白黒であるかどうかも、年代を特定するための追加の「基準」だったが、今世紀初頭にデジタル写真が普及すると、その手掛かりは意味を失った。
MyHeritageのサブスクリプションに含まれるPhotoDaterなど、複数の商用・実験的システムが、こうした基準やその他の多様な基準を用いて写真の年代を推定しようとしている。

MyHeritageのPhotoDaterサービスの写真年齢推測の例。 ソース
スマートフォンなど、その時代に特有の技術的な手掛かりがなければ、過去15~25年に撮影された写真の年代を知る最善の方法は、写っている人物(有名人や知人など)を知っていて、その人の年齢を推定できることだ。そこから、おおよその撮影年を導き出せる。
顔の年齢を参考とする
コンピュータビジョン分野およびその他の分野(たとえば、法医学、資料処理、ジャーナリズム、データセットアーキテクチャなど)では、写真の撮影年を決定する能力は、興味深いデジタルおよびアナログのコレクションの多くに適切な注釈やメタデータがなく、過去の誤った推測による不正確なメタデータさえ含まれているため、重要な目標となっている。
したがって、AIシステムが写真を人間と同じようにレビューし、過去のコレクションを振り返りながら「ああ、こんな時代だったね」とコメントできるようにすることは、役に立つことだろう。問題は、通常必要となる手掛かりがない場合に、何をよりどころにできるかという点だ。
チェコ共和国の新しい研究論文は、このアプローチへの最初の足掛かりを提示している。AIベースの年齢認識システムと、共通の人物データベースに接続された顔認識システムを組み合わせる手法だ。この研究では、チェコの俳優や映画制作者を収録したIMDB型のデータベースを使用した。

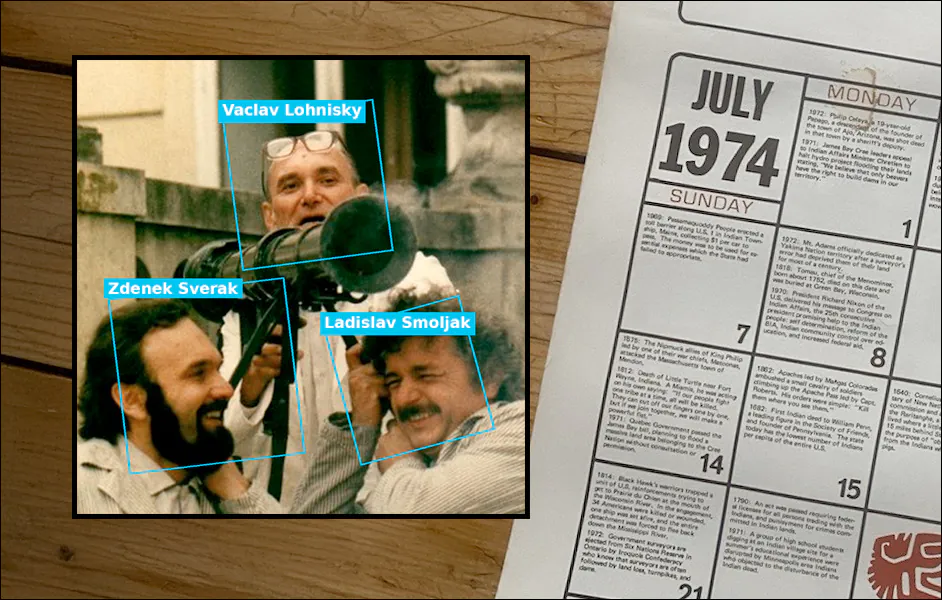
1974年の映画「Joachim, Put It in the Machine」の静止画。モデルは写真内の既知人物を検出し、顔年齢推定器(右列)で年齢を推定し、その値を各人物の生年に加えて、考えられる撮影日の確率分布を生成する。 ソース
システムは写真内の既知の人物を検出し、事前学習済みモデルで顔年齢を推定し、その年齢を記録された生年に加えることで、写真の撮影年として有力な候補を生成する。複数の顔がある場合は、それぞれの年代推定を統合して最終予測を得る。
この方法は、チェコ・スロバキア映画データベース(CSFD)から選定した画像で検証された。著者らによれば、同じデータで学習したシーンベースのモデル(顔ではなく背景要素や視覚的文脈に依存する静的モデル)よりも、一貫して高い精度を示した。
この方式には、幅広い人物に関する情報を持つ中央データベースが必要である。この研究ではIMDB型のチェコ映画データベースを使ったが、確認済みの生年と、日付が確定した出来事を収録する同様のコレクションであれば、同種の結果を得られる可能性がある。
論文では次のように述べられている。
「私たちのデータセットは、1枚の画像内に複数の人物を注釈した点で独自性があり、複数顔の情報を統合する研究を可能にします。最新の顔認識・年齢推定モデルによる視覚的証拠と、経歴に基づく時間的事前分布を形式的に組み合わせ、写真の撮影年を推論する確率的枠組みを提案します。」
「実験では、複数の顔から得た証拠を統合することで性能が一貫して向上し、特に識別可能な人物が複数写る画像において、強力なシーンベースのベースラインを大幅に上回りました。」
この新しい論文はPhoto Dating by Facial Age Aggregationと題され、プラハのチェコ工科大学の研究者2名によるものだ。コードとデータは後日公開される予定である。
方法
撮影年を推定するため、著者らの新しいシステムは、検出された顔ごとに、前述の既知人物データベースを使って誰である可能性があるかを推測する。同じ人物が1枚の写真に複数回現れることはないため、考えられる人物の組み合わせをすべて検討し、既知の生年と見た目の年齢を照合する。
その後、それらの年齢が整合する最も可能性の高い年を逆算する。

左:システムは、既知の経歴を基に、認識された人物が最も活躍していた時期のタイムラインを構築する。右:これを顔年齢の推定値と組み合わせ、画像が撮影された時期の最終推定を生成する。
膨大な数の人物組み合わせを扱うため、システムは各顔が独立しており、その外見は人物の身元と写真の日付だけに依存すると仮定する。
まず、NISTのcvut-002モデルを使って、検出した各顔の年齢を推定する。このモデルはViT-B/16アーキテクチャを基盤とし、非公開データセットで学習されている。著者らによれば、NISTのFace Analysis Technology Evaluation(FATE)データベースで高い順位にある。
人物の生年が分かれば、推定年齢を生年に加えるだけで、推定年齢を有力な撮影年へ変換し、考えられる撮影年の確率分布を得られる。検出した顔が既知の人物とどの程度一致するかを評価するため、システムは埋め込みをArcFace空間で比較する。

ArcFaceは、2015年に発表されたInsightFaceモデルの中心的なアーキテクチャであり、顔の評価分野で影響力のあるプロジェクトとなった。 ソース
各人物は、参照用ポートレートから作成した平均埋め込みで表現される。テスト顔と人物の類似度は、ポートレート群がその平均の周囲にどれほど密に集まるかをモデル化するフォン・ミーゼス–フィッシャー分布で測定する。共有の集中度パラメータがクラスタへの確信度を制御し、人物のポートレートに対する一個抜き法で推定される。
モデルは、認識された人物が写真に現れる時期を推定するため、5種類の事前分布を定義する。一様、10年、映画、画像、そして最も強い選択肢と弱い選択肢を混合し、事前分布の強さへの感度を検証する凸結合事前分布である。
確信を持って識別できない顔を扱うため、モデルには情報を持たない分布を用いる「不明」の身元が用意されている。顔の尤度は埋め込み空間で平坦で、時間的事前分布も全期間で平坦だ。これにより、不確かな顔が最終的な年代推定を偏らせることなく無視される。

既知と未知の顔が同じ画像に現れるオープンセット条件でのフルモデルの性能。未知の人物が増えると平均絶対誤差(MAE)は増えるが、タイムラインの基準となる既知人物が増えるほど一貫して改善する。各正方形の大きさはサンプル数を示し、低誤差の構成がデータセット分布でも多いことを表す。
データとテスト
著者らは前述のCSFDデータセットを使い、CSFD-1.6Mと名付けた新しいコレクションを構築した。複数人物が写るシーンから作られ、各顔には身元と年が付与されている。この構造は、文脈の中で顔同士がどう関係するかをモデルに学習させるために必要だった。1画像につき1人しかラベル付けしないIMDB-WIKIのような単一顔データセットでは対応できない。
チェコ・スロバキア映画データベースの公開年を使って各写真の撮影時期を推定し、画像内の各人物を、生年とポートレートを掲載した公開プロフィールに対応付けた。
続いてArcFaceで顔埋め込みを作成し、人物ごとの平均埋め込みを計算して、画像内の各顔を既知の人物のいずれかに対応付けた。
その後、埋め込みの類似度を比較するハンガリアン法で顔を人物に割り当てた。SCRFD-10GEで検出した顔の数が既知人物の数と一致しない場合には調整も加えた。

CSFD-1.6Mデータセットの統計。スクレイピングされた画像、検出された顔、アイデンティティのマッチ、最終的な注釈付きサンプル、および利用可能なアイデンティティプールを示す。
類似度が低すぎる場合や、推定年齢が既知の年齢から大きく外れる場合は対応付けを棄却した。高齢者にはより大きな許容幅を設け、顔を画質やサイズで除外することはなかった。
著者らは、最も近い比較対象であるIMDB-WIKIより、独自に整備したデータセットが優れていると述べる。
「私たちのデータセットは大幅に大きいだけでなく、決定的に重要な点として、モデルに必要な複数人物のシーンで構成されています。ウェブから収集したデータセットからラベルノイズを完全に排除することはできませんが、私たちの注釈パイプラインは、データベースが提供する画像と人物プロフィールの明示的な対応を利用し、より質の高い人物割り当てを目指しています。」
評価では、性能向上の要因を明らかにするため、年代推定システムの複数の版を比較した。1つは画像内の人物を完全に把握していると仮定し、人物認識の不確実性を除いて性能の上限を示すモデルである。フルモデルは人物の身元と日付を同時に推定し、複数の人物割り当て候補を重み付けしたうえで最終的な年を導く。
シンプルなバージョンは、最も可能性の高いアイデンティティ構成を選択し、代替を考慮せずに、ほぼ同等の有効性を示した。
一方、最も基本的な基準は、各顔を独立して割り当て、年齢ベースの撮影年推測を組み合わせたが、アイデンティティが集合的に意味をなすかどうかを考慮しなかった。
顔を使うこと自体の効果を検証するため、写真全体のシーンから直接日付を推定する別モデルも学習した。このシーンベースのモデルは、人物や年齢に頼らず画像全体の時代特有の視覚パターンを学べるため、現在の画像年代推定で最も強力な代替手法に相当する。
メトリックとデータ
実験の中心的な指標は、予測年と既知の正解年の間の平均絶対誤差(MAE)だった。
データは5分割し、同じ映画の画像は必ず1つの区画にまとめた。3区画を学習、1区画を検証、1区画をテストに使用し、この5分割ローテーションで過学習を防いだ。
顔ベースのモデルは、このデータセットで訓練されていないため、分割は必要なく、代わりに、完全なCSFD-1.6Mセットで評価された。
シーンモデルは、Adamオプティマイザを用いて200エポック学習し、画像を384×384のクロップにリサイズした。
結果
結果のセクションは、複数のパフォーマンス指標にわたって分割されており、単一の傑出しているテストや中心的なテストはない。しかし、ここでは最も関連性の高い結果を提示する。
最も重要な結果は単一の数値ではなく、一貫した傾向である。顔情報を統合するモデル、特にフル版とTop-1版は、既知人物が2人以上いる場合に強力なシーンベースラインを一貫して上回った。シーンモデルはデータセット上で直接学習されているにもかかわらずであり、人物の身元に結び付いた顔による年代推定が、画像全体のシーン解釈より堅牢な信号になるという中心的主張を裏付ける。
時間的事前分布の効果を評価するため、著者らはフルモデルの複数構成を比較した。最も高い性能を示したのは10年事前分布で、時間的事前分布を使わないナイーブモデルと、年に選好を設けない一様事前分布の両方を大幅に上回った。

顔の数が増加するにつれて、すべての方法のパフォーマンスが低下するが、時系列的先行分布を使用するモデルは影響が少ない。シーンとナイーブの基準は平坦または低下するが、情報先行分布を使用するフルモデルは低い誤差を維持する。
写真の年代推定以外でもCSFD-1.6Mの価値を示すため、このデータセットを顔年齢推定という広範な課題の事前学習資源として検証した。標準評価プロトコルに従い、ResNet101モデルをCSFD-1.6Mで事前学習し、IMDB-WIKIおよびImageNetで事前学習したモデルと比較した。その後、5つの代表的ベンチマーク、AgeDB、AFAD、MORPH、UTKFace、CLAP2016で微調整・評価した。

5つの年齢推測ベンチマークでの平均絶対誤差(±標準偏差)。ImageNet、IMDB-WIKI、CSFD-1.6Mで事前訓練したモデルを比較する。低い値はより良いパフォーマンスを示す。CSFD-1.6Mはすべてのベンチマークで最も強い結果をもたらす。
5つすべてのデータセットで、CSFD-1.6Mによる事前学習が最も低い誤差率を達成し、他の2つの事前学習元を明確な差で上回った。この差はAFADとCLAP2016で特に大きく、全ベンチマークで一貫していた。
やや断片的な原論文の結果セクションには、アブレーション研究も詳しく記載されているため、残りの結果についてはそちらを参照されたい。
結論
この新しい論文は、一般の読者にはすぐに難解になってしまうものの、コンピュータビジョン文献で最も興味深く重要なテーマの1つを扱っている。とりわけ、一定の基準を捉えにくい人類学や文化研究と巧みに交差する点が重要だ。
* 音楽の進化も同様に、変化の速度を落としてきた。
2025年11月10日初版。


