
एआई की मूल बातें
फ़ेडरेटेड लर्निंग क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
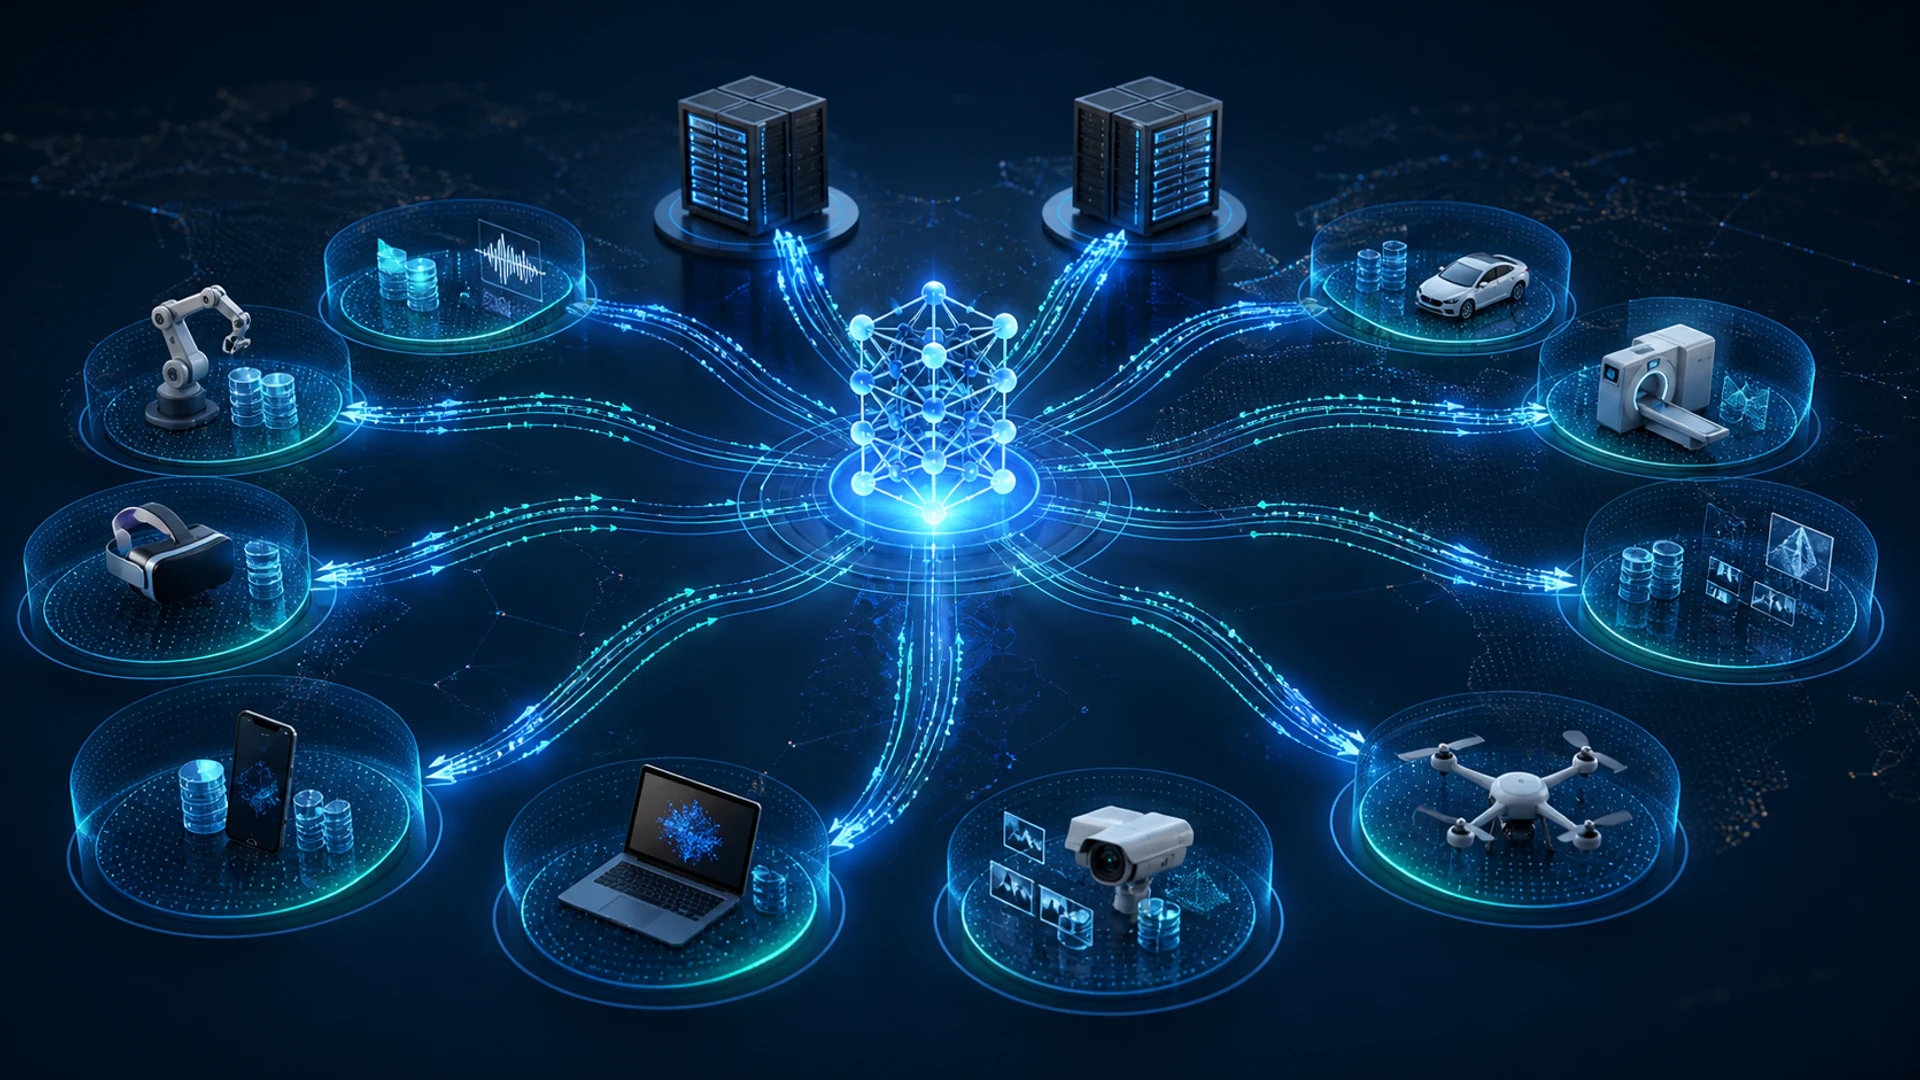
फ़ेडरेटेड लर्निंग कई उपकरणों या संगठनों में एक साझा मॉडल को प्रशिक्षित करती है जबकि प्रत्येक प्रतिभागी का कच्चा प्रशिक्षण डेटा स्थानीय रहता है। एक समन्वयक मॉडल पैरामीटर वितरित करता है, क्लाइंट अपने रिकॉर्ड पर अपडेट की गणना करते हैं, और एक एग्रीगेशन चरण उन अपडेट को मिलाता है।
रिकॉर्ड को स्थानीय रखना उपयोगी है, लेकिन यह गोपनीयता या सुरक्षा के समान नहीं है। मॉडल अपडेट जानकारी लीक कर सकते हैं, समझौता किए गए क्लाइंट प्रशिक्षण को विषाक्त कर सकते हैं, और समन्वयक को अभी भी प्रमाणीकरण, ट्रांसपोर्ट सुरक्षा, एक्सेस नियंत्रण और एक परिभाषित भरोसे का मॉडल चाहिए।
मुख्य बिंदु
- फ़ेडरेटेड लर्निंग गणना को वितरित डेटा की ओर ले जाता है; यह कच्चे डेटासेट को एक केंद्रीय प्रशिक्षक के पास नहीं ले जाता।
- क्रॉस-डिवाइस सिस्टम कई अस्थायी उपकरणों को शामिल करते हैं, जबकि क्रॉस-साइलो सिस्टम कम, अधिक स्थिर संगठनों को शामिल करते हैं।
- सुरक्षित एग्रीगेशन और डिफ़रेंशियल प्राइवेसी विभिन्न जोखिमों को संबोधित करते हैं और इन्हें संयोजित किया जा सकता है।
- नॉन-IID डेटा, सीमित बैंडविड्थ, अविश्वसनीय भागीदारी और दुर्भावनापूर्ण अपडेट मुख्य डिजाइन प्रतिबंध हैं।
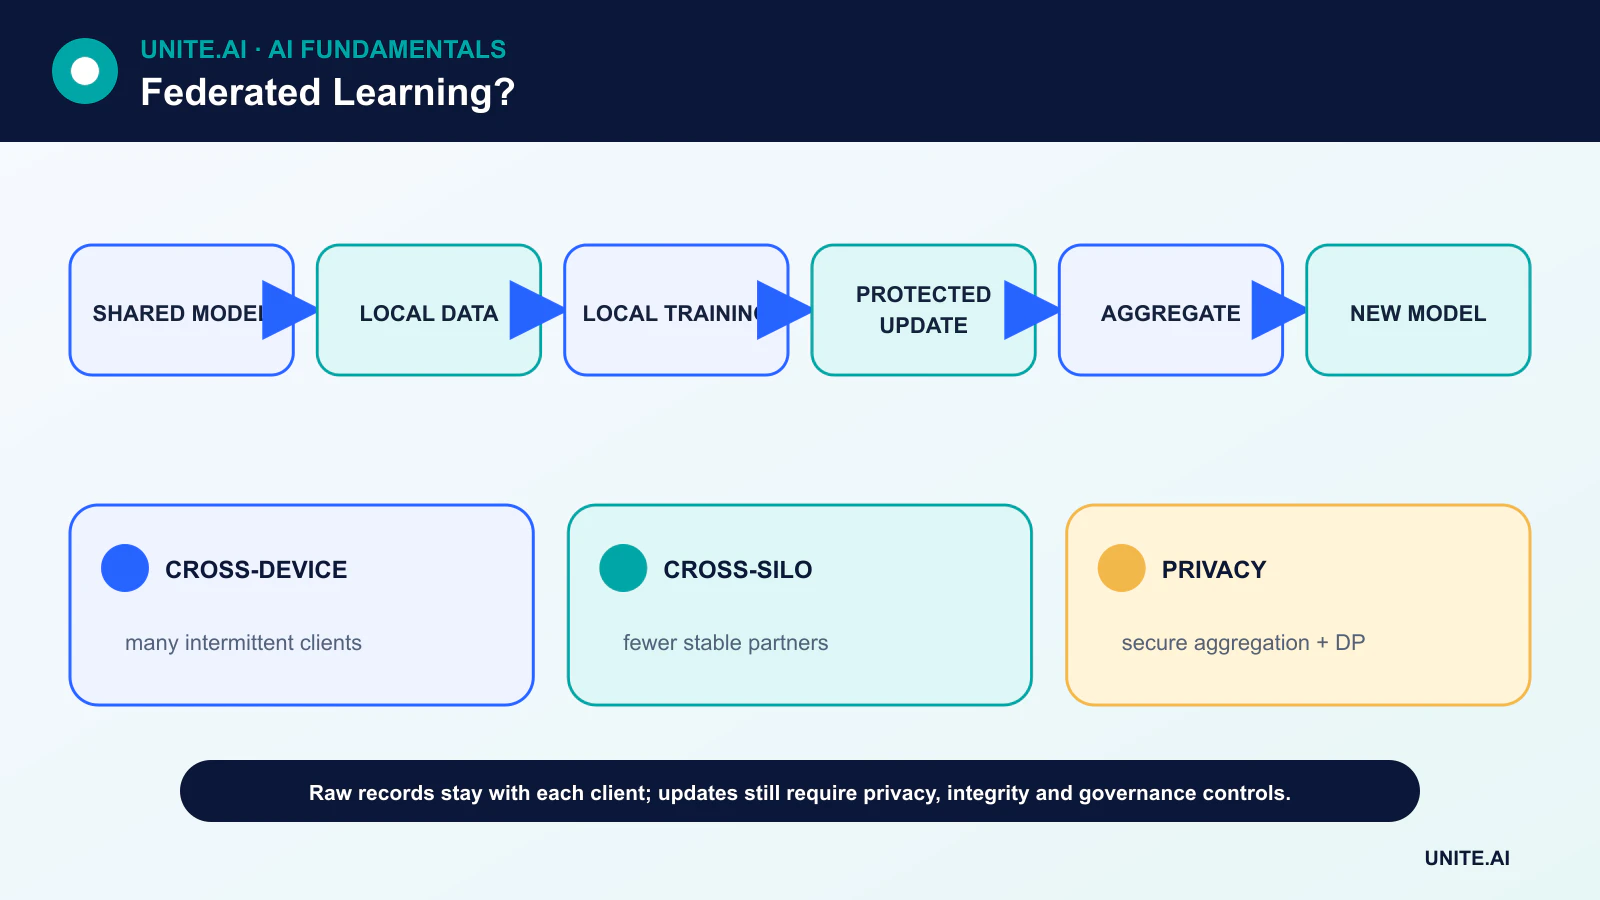
फ़ेडरेटेड एवरेजिंग जीवनचक्र
एक सामान्य राउंड तब शुरू होता है जब समन्वयक योग्य क्लाइंट्स का चयन करता है और वर्तमान मॉडल भेजता है। प्रत्येक क्लाइंट सीमित चरणों के लिए स्थानीय रूप से प्रशिक्षित करता है, जिससे एक पैरामीटर या ग्रेडिएंट अपडेट बनता है। समन्वयक योग्य अपडेट्स को एग्रीगेट करता है—आमतौर पर स्थानीय उदाहरण गिनती के आधार पर वज़न के साथ—और नया साझा मॉडल प्रकाशित करता है।
प्रत्येक राउंड में केवल एक भाग क्लाइंट्स भाग ले सकते हैं। प्रोटोकॉल को ड्रॉप हुई कनेक्शन, संस्करण असंगतियों और ऐसे उपकरणों को सहन करना चाहिए जो चार्जिंग, व्यस्त या ऑफ़लाइन होने पर प्रशिक्षण नहीं कर सकते। संचार गणना पर हावी हो सकता है, इसलिए अपडेट संपीड़न और कम राउंड ट्रिप्स अक्सर कच्ची एक्सेलेरेटर गति से अधिक महत्वपूर्ण होते हैं।
क्रॉस-डिवाइस बनाम क्रॉस-साइलो
क्रॉस-डिवाइस फ़ेडरेटेड लर्निंग में कई व्यक्तियों के स्वामित्व वाले फ़ोन, सेंसर या ब्राउज़र शामिल हो सकते हैं। क्लाइंट्स की संख्या अधिक, भरोसा कम और अस्थायी रूप से उपलब्ध होते हैं। क्रॉस-साइलो फ़ेडरेटेड लर्निंग आमतौर पर अस्पतालों, बैंकों या व्यावसायिक इकाइयों के छोटे समूह को स्थिर बुनियादी ढांचा और अनुबंधीय गवर्नेंस के साथ जोड़ती है।
इन दो सेटिंग्स को अलग-अलग पहचान, ऑडिट और विफलता धारणाओं की आवश्यकता होती है। एक क्रॉस-साइलो प्रोजेक्ट साझा स्कीमा और वैलिडेशन प्रक्रिया पर बातचीत कर सकता है; एक क्रॉस-डिवाइस सेवा को लाखों सॉफ़्टवेयर संस्करणों और अत्यधिक असमान स्थानीय डेटासेट्स को संभालना पड़ सकता है।
सुरक्षित एग्रीगेशन, डिफ़रेंशियल प्राइवेसी और एन्क्रिप्शन
सुरक्षित एग्रीगेशन एक क्रिप्टोग्राफ़िक प्रोटोकॉल है जो सर्वर को प्रत्येक क्लाइंट के अपडेट को पढ़े बिना एग्रीगेट पुनः प्राप्त करने देता है। डिफ़रेंशियल प्राइवेसी क्लिपिंग योगदान और कैलिब्रेटेड शोर जोड़कर यह सीमित करता है कि जारी परिणाम किसी एक रिकॉर्ड या प्रतिभागी पर कितना निर्भर कर सकता है।
इनमें से कोई भी तंत्र सभी जोखिमों को नहीं दूर करता। सुरक्षित एग्रीगेशन एग्रीगेट को निरापद नहीं बनाता, और डिफ़रेंशियल प्राइवेसी एक सटीकता‑गोपनीयता ट्रेड‑ऑफ़ लगाता है जिसे स्पष्ट प्राइवेसी बजट के साथ ध्यान में रखना चाहिए। एन्क्रिप्शन ट्रांसिट या स्टोरेज में डेटा की सुरक्षा करता है; यह स्वयं मॉडल से निष्कर्ष निकालने को नहीं रोकता।
नॉन‑IID डेटा और मॉडल गुणवत्ता
क्लाइंट डेटा शायद ही कभी स्वतंत्र और समान रूप से वितरित होते हैं। एक कीबोर्ड मॉडल प्रत्येक व्यक्ति की शब्दावली देखता है; अस्पताल विभिन्न जनसंख्या की सेवा करते हैं; कारखाने विभिन्न उपकरणों का उपयोग करते हैं। ये अंतर अभिसरण को धीमा कर सकते हैं और छोटे क्लाइंट समूहों के लिए खराब प्रदर्शन को छिपा सकते हैं।
मूल्यांकन में वैश्विक मीट्रिक, प्रति‑क्लाइंट या कोहोर्ट वितरण, कैलिब्रेशन और फेल्योर विश्लेषण शामिल होना चाहिए। एक केंद्रीय टेस्ट सेट सुविधाजनक हो सकता है लेकिन पर्याप्त नहीं है। यह फ़ेडरेटेड लर्निंग को मशीन‑लर्निंग डेटा गुणवत्ता और संरचित और असंरचित डेटा गवर्नेंस से जोड़ता है।
खतरे और संचालन नियंत्रण
दुर्भावनापूर्ण क्लाइंट विषाक्त अपडेट जमा कर सकते हैं, सिबिल क्लाइंट एग्रीगेशन को विकृत कर सकते हैं, और समझौता किए गए सर्वर लक्ष्यित मॉडल वितरित कर सकते हैं। रक्षा उपायों में प्रमाणित नामांकन, विसंगति पहचान, मजबूत एग्रीगेशन, अपडेट वैलिडेशन, दर सीमाएँ और जहाँ संभव हो पुनरुत्पादक सॉफ़्टवेयर एटेस्टेशन शामिल हैं।
फ़ेडरेटेड लर्निंग एक व्यापक साइबर सुरक्षा कार्यक्रम के भीतर आती है। टीमों को दस्तावेज़ करना चाहिए कि समन्वयक को कौन नियंत्रित करता है, कौन‑से मेटाडाटा एकत्रित होते हैं, प्रतिभागी कैसे बाहर निकल सकते हैं, मॉडल कैसे रोल बैक होते हैं और गोपनीयता या गुणवत्ता परीक्षण विफल होने पर क्या होता है।
फ़ेडरेटेड ऑप्टिमाइज़ेशन और डेटा विषमता
फ़ेडरेटेड लर्निंग मॉडल या अपडेट टास्क को भाग लेने वाले क्लाइंट्स को भेजती है, स्थानीय रूप से प्रशिक्षित करती है, और कच्चे उदाहरणों को केंद्रीकृत किए बिना अपडेट्स को एग्रीगेट करती है। फ़ेडरेटेड एवरेजिंग में, चयनित क्लाइंट्स कई स्थानीय ऑप्टिमाइज़ेशन चरण चलाते हैं और सर्वर वज़नित औसत गणना करता है, आमतौर पर उदाहरण गिनती के आधार पर। संचार राउंड, स्थानीय इपॉक्स, चयन, और लर्निंग रेट बैंडविड्थ को अभिसरण के विरुद्ध संतुलित करते हैं। क्रॉस-डिवाइस सेटिंग्स में कई अविश्वसनीय फ़ोन या सेंसर शामिल होते हैं; क्रॉस-साइलो सेटिंग्स में कम संगठनों के पास अधिक मजबूत कंप्यूट, पहचान और गवर्नेंस होते हैं।
क्लाइंट डेटा आमतौर पर गैर‑स्वतंत्र और असमान होता है: उपयोगकर्ता व्यवहार, लेबल वितरण, मात्रा और उपलब्धता में भिन्न होते हैं। स्थानीय प्रशिक्षण असंगत दिशाओं में विचलित हो सकता है, जिससे साधारण औसत अस्थिर या सक्रिय उच्च‑वॉल्यूम क्लाइंट्स की ओर पक्षपाती हो जाता है। एल्गोरिदम प्रोक्सिमल टर्म्स, अनुकूली सर्वर ऑप्टिमाइज़ेशन, क्लस्टरिंग, पर्सनलाइज़ेशन, या कंट्रोल वैरिएट्स का उपयोग कर सकते हैं। मूल्यांकन में वैश्विक और क्लाइंट‑स्तर का प्रदर्शन, टेल क्लाइंट्स, भागीदारी आवृत्ति, अभिसरण, संचार, और ऊर्जा रिपोर्ट करनी चाहिए। एक अच्छा औसत यह छिपा सकता है कि छोटे या दुर्लभ क्लाइंट जनसंख्या को खराब मॉडल मिलता है।
गोपनीयता, सुरक्षा, और सिस्टम इंजीनियरिंग
डेटा को स्थानीय रखना स्वयं में गोपनीयता की गारंटी नहीं देता। ग्रेडिएंट्स और अपडेट्स सदस्यता या विशेषताओं को लीक कर सकते हैं, जबकि अंतिम मॉडल उदाहरणों को याद रख सकता है। सुरक्षित एग्रीगेशन व्यक्तिगत अपडेट्स को सर्वर से छुपाता है, और डिफ़रेंशियल प्राइवेसी क्लिपिंग और शोर जोड़कर सूचना योगदान को सीमित करता है, लेकिन दोनों उपयोगिता और संचालन जटिलता को बदलते हैं। खतरा मॉडल, गोपनीयता इकाई, बजट, और विश्वसनीय घटकों को स्पष्ट करें। ट्रांसिट में एन्क्रिप्शन आवश्यक है लेकिन यह दुर्भावनापूर्ण क्लाइंट, विषाक्त अपडेट, समझौता किए गए समन्वयक, या निष्कर्षण हमले को नहीं रोकता।
रक्षा उपायों में प्रमाणित क्लाइंट्स, मजबूत एग्रीगेशन, विसंगति जांच, अपडेट सीमाएँ, कुछ डिज़ाइनों में सुरक्षित एन्क्लेव्स, और साफ़ डेटा के विरुद्ध वैलिडेशन शामिल हैं। सिबिल हमलावर कई क्लाइंट बना सकते हैं; बैकडोर औसत करने के बाद भी जीवित रह सकते हैं; संदिग्ध अपडेट को हटाने से वैध दुर्लभ व्यवहार भी बाहर हो सकता है। क्लाइंट कोड का संस्करण, बाधित राउंड का समर्थन, रिप्ले रोकना, और स्ट्रैगलर्स व उपकरण सीमाओं के लिए डिज़ाइन करना चाहिए। सहमति, रखरखाव, क्षेत्रीय नियम, और हटाना अभी भी स्थानीय डेटा और निकाले गए अपडेट्स पर लागू होते हैं।
डिप्लॉयमेंट और गवर्नेंस उदाहरण
एक मोबाइल कीबोर्ड स्थानीय रूप से अगले शब्द सुधारों को प्रशिक्षित कर सकता है, लेकिन रोलआउट को उपकरण क्षमता और सहमति के आधार पर योग्य जनसंख्या का उपयोग करना चाहिए, क्लिप्ड संरक्षित अपडेट एकत्र करना चाहिए, और एक स्थिर बेसलाइन से तुलना करनी चाहिए। रिलीज़ से पहले भाषा और बोली प्रदर्शन, बैटरी, डेटा उपयोग, और स्मरण जोखिम को वैध करना चाहिए। क्लाइंट्स को हस्ताक्षरित प्रशिक्षण टास्क और मॉडल अपडेट की आवश्यकता होती है; सर्वर को ऑडिटेबल राउंड कॉन्फ़िगरेशन और रोलबैक चाहिए। फ़ेडरेटेड लर्निंग प्रतिबंधों के तहत वितरित लर्निंग के लिए एक आर्किटेक्चर है, न कि प्रतिनिधिक डेटा, गोपनीयता इंजीनियरिंग, या जवाबदेही का विकल्प।
व्यावहारिक उदाहरण: अस्पतालों में फ़ेडरेटेड लर्निंग
अस्पताल स्कैन को एकत्र किए बिना एक साझा इमेज‑क्वालिटी मॉडल प्रशिक्षित करते हैं। एक सामान्य प्रोटोकॉल डिवाइस मेटाडाटा, लेबल, प्री‑प्रोसेसिंग, क्लाइंट पात्रता, स्थानीय इपॉक्स, क्लिपिंग, और सुरक्षित एग्रीगेशन को परिभाषित करता है। साइटें रोगी डेटा रखती हैं और संरक्षित अपडेट जमा करती हैं, जबकि समन्वयक प्रत्येक राउंड को स्थानीय होल्ड‑आउट सेट्स पर मूल्यांकन करता है। परिणाम साइट‑स्तर और टेल प्रदर्शन रिपोर्ट करते हैं, न कि केवल वॉल्यूम‑वेटेड औसत, क्योंकि छोटे अस्पताल और डिवाइस प्रकार अन्यथा अनदेखे रह सकते हैं।
खतरा मॉडल में दुर्भावनापूर्ण अपडेट्स, सदस्यता लीक, समझौता किए गए क्लाइंट्स, और समन्वयक एक्सेस शामिल हैं। डिफ़रेंशियल प्राइवेसी को एक दस्तावेज़ित बजट और परीक्षण उपयोगिता के साथ कॉन्फ़िगर किया जाता है। मॉडल और टास्क पैकेज साइन किए जाते हैं; साइटें वापस ले सकती हैं और अपडेट ऑडिटेबल होते हैं। एक विषाक्त या अस्थिर राउंड स्वचालित रूप से डिप्लॉय किए गए मॉडल को प्रतिस्थापित नहीं करता। प्रोजेक्ट स्थानीय बेसलाइन और क्लिनिकल रिव्यू रखता है, और यह फ़ेडरेटेड आर्किटेक्चर को व्यापक सहमति, सुरक्षा, और गवर्नेंस दायित्वों के भीतर एक गोपनीयता नियंत्रण के रूप में मानता है।
कार्यान्वयन प्रमाण और संचालन तत्परता
एक उत्पादन निर्णय को सफल प्रदर्शन से अधिक चाहिए। लक्षित उपयोगकर्ताओं, संचालन पर्यावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक, और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादक बेसलाइन और एक संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपस्थित इनपुट, वितरण परिवर्तन, निर्भरता आउटेज, दुरुपयोग, और सबसे अधिक सेवा‑हीन समूहों या पर्यावरणों का परीक्षण करें। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता, और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुनरुत्पादित कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक, और रिटायरमेंट के लिए अधिकार निर्धारित करें। चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित फॉलबैक रखें, और जानबूझकर इंजेक्टेड विफलताओं के साथ मॉनिटरिंग को सत्यापित करें। संचालन टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड, और अनावश्यक संवेदनशील डेटा एकत्र किए बिना पुष्टि किए गए परिणाम दिखाने चाहिए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर डिप्लॉयमेंट के बाद वास्तविक दुनिया के प्रमाण की समीक्षा करें बजाय यह मानने के कि ऑफ़लाइन प्रदर्शन बना रहेगा। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियां, हार्डवेयर, या लक्ष्य बदलें, पुनर्मूल्यांकन करें। एक बनाए रखा सिस्टम को दस्तावेज़ित पुनर्प्राप्ति, घटना सीखना, हटाना और रखरखाव प्रक्रियाओं, और एक स्पष्ट बिंदु चाहिए जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या फ़ेडरेटेड लर्निंग यह गारंटी देती है कि निजी डेटा लीक नहीं हो सकता?
नहीं। यह कच्चे डेटा की गति को कम करता है, लेकिन अपडेट और अंतिम मॉडल अभी भी जानकारी प्रकट कर सकते हैं। गोपनीयता के लिए एक खतरा मॉडल और अतिरिक्त तकनीकी तथा संगठनात्मक नियंत्रण आवश्यक हैं।
केंद्रीकृत प्रशिक्षण कब सरल होता है?
जब डेटा को वैध और सुरक्षित रूप से केंद्रीकृत किया जा सकता है, तो केंद्रीकृत प्रशिक्षण अक्सर डिबग, पुनरुत्पादन और मॉनिटर करने में आसान होता है। फ़ेडरेटेड लर्निंग तभी उचित है जब वितरण वास्तविक आवश्यकता हो, न कि केवल ब्रांडिंग लक्ष्य।
प्राथमिक संदर्भ












