
विचार नेता
तीन गोपनीयता संरक्षण मशीन लर्निंग तकनीकें जो इस दशक के सबसे महत्वपूर्ण मुद्दे का समाधान कर रही हैं

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
अमोग तारकर, मशीन लर्निंग और एआई रिसर्चर, परसिस्टेंट सिस्टम्स द्वारा
(PERSISTENT.BO )डेटा गोपनीयता, विभिन्न क्षेत्रों में विशेषज्ञों के अनुसार, इस दशक का सबसे महत्वपूर्ण मुद्दा होगा। यह विशेष रूप से मशीन लर्निंग (एमएल) के लिए सच है, जहां एल्गोरिदम को विभिन्न स्रोतों से डेटा की बड़ी मात्रा में खिलाया जा रहा है।
पारंपरिक रूप से, एमएल मॉडलिंग तकनीकों ने एकल डेटा केंद्र में विभिन्न स्रोतों से डेटा को केंद्रित करने पर भरोसा किया है। आखिरकार, एमएल मॉडल तब सबसे शक्तिशाली होते हैं जब उनके पास बड़ी मात्रा में डेटा तक पहुंच होती है। हालांकि, इस तकनीक के साथ कई गोपनीयता चुनौतियां आती हैं। विभिन्न स्रोतों से विविध डेटा को एकत्र करना आज कानूनी चिंताओं जैसे हिप्पा, जीडीपीआर और सीसीपीए के कारण कम व्यावहारिक है। इसके अलावा, डेटा को केंद्रित करने से डेटा के दुरुपयोग और सुरक्षा खतरों के लिए दायरा और स्तर बढ़ जाता है, जो डेटा लीक के रूप में होता है।
इन चुनौतियों का सामना करने के लिए, गोपनीयता संरक्षण मशीन लर्निंग (पीपीएमएल) के कई स्तंभ विकसित किए गए हैं, जिनमें विशिष्ट तकनीकें हैं जो गोपनीयता जोखिम को कम करती हैं और सुनिश्चित करती हैं कि डेटा काफी हद तक सुरक्षित रहता है। यहाँ कुछ सबसे महत्वपूर्ण हैं:
1. फेडरेटेड लर्निंग
फेडरेटेड लर्निंग एक एमएल प्रशिक्षण तकनीक है जो डेटा एकत्रीकरण समस्या को उल्टा कर देती है। एकल एमएल मॉडल बनाने के लिए डेटा एकत्र करने के बजाय, फेडरेटेड लर्निंग स्वयं एमएल मॉडल को एकत्र करती है। यह सुनिश्चित करता है कि डेटा कभी भी अपने स्रोत स्थान से बाहर नहीं जाता है, और यह कई पक्षों को संवेदनशील डेटा को सीधे साझा किए बिना एक सामान्य एमएल मॉडल बनाने और सहयोग करने की अनुमति देता है।
यह इस तरह काम करता है। आप एक आधार एमएल मॉडल से शुरू करते हैं जिसे फिर प्रत्येक क्लाइंट नोड के साथ साझा किया जाता है। ये नोड्स फिर अपने स्वयं के डेटा का उपयोग करके इस मॉडल पर स्थानीय प्रशिक्षण चलाते हैं। मॉडल अद्यतनों को समन्वयक नोड के साथ आवधिक रूप से साझा किया जाता है, जो इन अद्यतनों को संसाधित करता है और उन्हें एक नए वैश्विक मॉडल को प्राप्त करने के लिए एक साथ जोड़ता है। इस तरह, आप विविध डेटासेट से अंतर्दृष्टि प्राप्त करते हैं बिना इन डेटासेट को साझा किए।

स्रोत: परसिस्टेंट सिस्टम्स
स्वास्थ्य सेवा के संदर्भ में, यह एक अविश्वसनीय रूप से शक्तिशाली और गोपनीयता-सचेत उपकरण है जो रोगी डेटा को सुरक्षित रखते हुए शोधकर्ताओं को भीड़ की बुद्धिमत्ता प्रदान करता है। डेटा को एकत्र नहीं करने से, फेडरेटेड लर्निंग एक अतिरिक्त सुरक्षा परत बनाता है। हालांकि, मॉडल और मॉडल अद्यतन स्वयं एक सुरक्षा जोखिम प्रस्तुत करते हैं यदि उन्हें असुरक्षित छोड़ दिया जाए।
2. डिफरेंशियल गोपनीयता
एमएल मॉडल अक्सर सदस्यता अनुमान हमलों के लक्ष्य होते हैं। मान लें कि आपने अपने स्वास्थ्य डेटा को एक अस्पताल के साथ साझा करने के लिए दिया था ताकि एक कैंसर वैक्सीन विकसित करने में मदद मिल सके। अस्पताल आपके डेटा को सुरक्षित रखता है, लेकिन फेडरेटेड लर्निंग का उपयोग करके एक सार्वजनिक रूप से उपलब्ध एमएल मॉडल को प्रशिक्षित करता है। कुछ महीनों बाद, हैकर सदस्यता अनुमान हमले का उपयोग करके यह निर्धारित करते हैं कि क्या आपका डेटा मॉडल के प्रशिक्षण में उपयोग किया गया था या नहीं। वे फिर बीमा कंपनी को जानकारी देते हैं, जो आपके कैंसर के जोखिम के आधार पर आपकी प्रीमियम बढ़ा सकती है।
डिफरेंशियल गोपनीयता सुनिश्चित करती है कि एमएल मॉडल पर दुश्मन हमले विशिष्ट डेटा बिंदुओं की पहचान नहीं कर पाएंगे जो प्रशिक्षण के दौरान उपयोग किए गए थे, जिससे मशीन लर्निंग में संवेदनशील प्रशिक्षण डेटा के पर्दाफाश के जोखिम को कम किया जा सके। यह प्रशिक्षण मॉडल के दौरान डेटा या मशीन लर्निंग मॉडल पैरामीटर में “सांख्यिकीय शोर” लागू करके किया जाता है, जिससे हमलों को चलाना और यह निर्धारित करना मुश्किल हो जाता है कि क्या एक विशिष्ट व्यक्ति का डेटा मॉडल के प्रशिक्षण में उपयोग किया गया था।
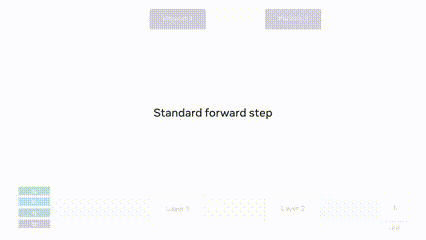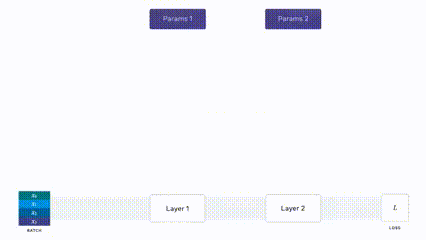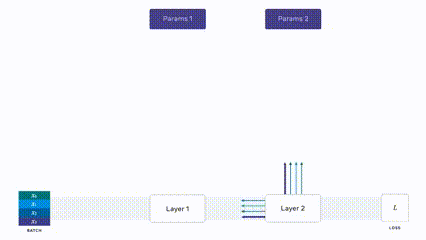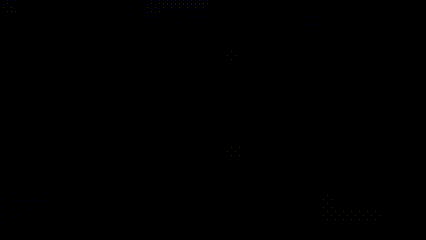
उदाहरण के लिए, फेसबुक ने हाल ही में ओपकस जारी किया, जो एक उच्च-गति पुस्तकालय है जो एक डिफरेंशियल गोपनीयता-आधारित मशीन लर्निंग प्रशिक्षण अल्गोरिथ्म का उपयोग करके पायटॉर्च मॉडल को प्रशिक्षित करने के लिए है। नीचे दिया गया जीआईएफ दिखाता है कि यह डेटा को मास्क करने के लिए शोर का उपयोग कैसे करता है।
स्रोत: फेसबुक का ओपकस ब्लॉग
यह शोर एक पैरामीटर द्वारा शासित होता है जिसे एप्सिलोन कहा जाता है। यदि एप्सिलोन मान कम है, तो मॉडल में डेटा गोपनीयता परिपूर्ण है लेकिन उपयोगिता और सटीकता खराब है। इसके विपरीत, यदि आपके पास एक उच्च एप्सिलोन मान है, तो आपकी डेटा गोपनीयता कम हो जाएगी जबकि आपकी सटीकता बढ़ जाएगी। चाल यह है कि दोनों के लिए अनुकूलन करने के लिए एक संतुलन बनाना है।
3. होमोमॉर्फिक एन्क्रिप्शन
मानक एन्क्रिप्शन आमतौर पर मशीन लर्निंग के साथ असंगत होता है क्योंकि एक बार डेटा एन्क्रिप्ट हो जाने के बाद, यह एमएल अल्गोरिथ्म द्वारा और अधिक समझा नहीं जा सकता है। हालांकि, होमोमॉर्फिक एन्क्रिप्शन एक विशेष एन्क्रिप्शन योजना है जो हमें कुछ प्रकार की गणना जारी रखने की अनुमति देती है।

स्रोत: ओपनमाइंडेड
इसकी शक्ति यह है कि प्रशिक्षण पूरी तरह से एन्क्रिप्टेड स्थान में हो सकता है। यह न केवल डेटा मालिकों की रक्षा करता है, बल्कि मॉडल मालिकों की भी रक्षा करता है। मॉडल मालिक एन्क्रिप्टेड डेटा पर अनुमान लगा सकता है बिना इसे देखे या दुरुपयोग किए।
जब इसे फेडरेटेड लर्निंग में लागू किया जाता है, तो मॉडल अद्यतनों का संलयन सुरक्षित रूप से हो सकता है क्योंकि वे पूरी तरह से एन्क्रिप्टेड वातावरण में हो रहे हैं, जिससे सदस्यता अनुमान हमलों के जोखिम में काफी कमी आती है।
गोपनीयता का दशक
जैसे ही हम 2021 में प्रवेश करते हैं, गोपनीयता संरक्षण मशीन लर्निंग एक उभरता हुआ क्षेत्र है जिसमें उल्लेखनीय रूप से सक्रिय अनुसंधान है। यदि पिछला दशक डेटा को अनसिलोइंग के बारे में था, तो यह दशक एमएल मॉडल को अनसिलोइंग के बारे में होगा जबकि फेडरेटेड लर्निंग, डिफरेंशियल गोपनीयता और होमोमॉर्फिक एन्क्रिप्शन के माध्यम से अंतर्निहित डेटा की गोपनीयता की रक्षा करता है। ये एक नई और आशाजनक तरीके से मशीन लर्निंग समाधानों को आगे बढ़ाने के लिए गोपनीयता-सचेत तरीके से पेश करते हैं।


