
AI:n perusteet
Mikä on metaoppiminen?

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Meta-oppiminen kouluttaa järjestelmää tehtäväjakauman yli, jotta se voi sopeutua uuteen, siihen liittyvään tehtävään rajoitetun datan tai laskennan avulla. Sitä tiivistetään usein “oppiminen oppimaan”, mutta tekninen tavoite on tarkempi: optimoida oppija niin, että aikaisempien tehtävien kokemus parantaa sopeutumista myöhempään.
Meta-oppiminen limittyy few-shot learning ja transfer learning kanssa, mutta termejä ei voi käyttää toistensa sijasta. Few-shot kuvaa kohdedatan määrää; transfer kuvaa uudelleenkäyttöä; meta-oppiminen tekee sopeutumisesta tehtävien välillä eksplisiittisesti osan koulutusta.
Keskeiset havainnot
- Meta-koulutus käyttää monia tehtäviä, ei pelkästään monia itsenäisiä esimerkkejä.
- N‑tiekäs K‑kertaista jaksoa sisältää N luokkaa ja K merkattua tukiesimerkkiä per luokka.
- Gradienttipohjaiset, metriikkapohjaiset, muistipohjaiset ja opitut optimointimenetelmät sopeutuvat eri tavoin.
- Suorituskyky riippuu vahvasti siitä, muistuttavatko meta‑koulutustehtävät kohdetehtävää.
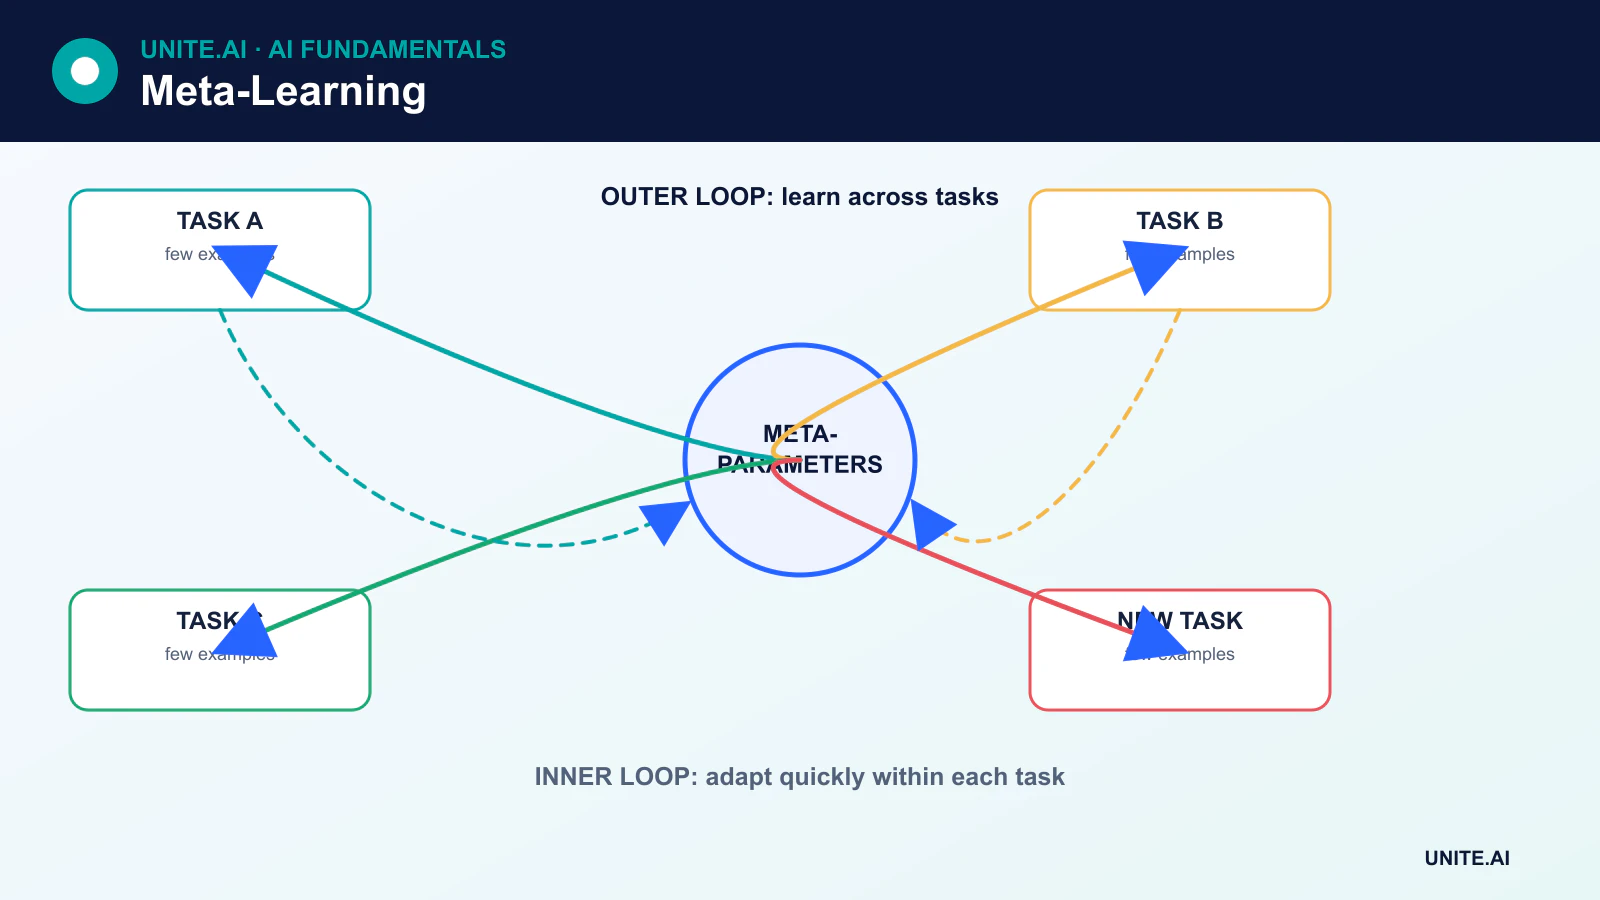
Tehtävät, tukijoukot ja kyselyjoukot
A meta-oppimisen datasetti on järjestetty tehtäviin. Few-shot‑luokittelussa jakso voi olla 5‑tiekäs 1‑kerta: viisi luokkaa, yksi merkattu tukiesimerkki per luokka, sekä lisäkyselyesimerkit, joilla arvioidaan sopeutumista. 5‑tiekäs 5‑kerta -tehtävässä on viisi tukiesimerkkiä kullekin viidelle luokalle – ei viittä esimerkkiä yhteensä.
Meta‑koulutuksen aikana oppija sopeutuu toistuvasti tukijoukolle ja sitä arvioidaan kyselyjoukolla. Ulkoinen tavoite parantaa tulevaa kyselysuorituskykyä tehtävien yli. Meta‑validointi hienosäätää valintoja erillisissä tehtävissä, ja meta‑testaus arvioi aidosti näkemättömiä tehtäviä tai luokkia.
Gradienttipohjainen meta-oppiminen
Model-Agnostic Meta-Learning (MAML) oppii aloituspisteen, josta pieni määrä gradientti-askeleita tuottaa hyvän suorituskyvyn uudessa tehtävässä. Sisälooppi sopeuttaa malliparametreja tukidatan avulla. Ulkolooppi päivittää jaetun aloituspisteen kyselyhäviön perusteella otetuissa tehtävissä.
MAML ei rajoitu luokitteluun; sitä voidaan soveltaa regressioon ja vahvistusoppimiseen, kun malli ja tehtävä ovat derivoituvia. Reptile tarjoaa yksinkertaisemman ensimmäisen asteen lähestymistavan, joka siirtää parametreja kohti tehtävään sopeutettuja ratkaisuja laskematta koko MAML‑meta‑gradienttia.
Metripohjainen meta-oppiminen
Metripohjaiset menetelmät oppivat upotuksen, jossa saman luokan esimerkit ovat lähellä ja eri luokat erotettuina. Prototyypillinen verkko keskiarvoistaa tukiuputukset muodostaen yhden prototyypin per luokka, ja luokittelee kyselyt etäisyyden perusteella näihin prototyyppeihin.
Matching- ja Siamese-tyyliset verkot käyttävät samankaltaisia samankaltaisuusmekanismeja. Nämä menetelmät eivät pelkästään tarkista, osuuko malli “tavoitemetriikkiin”; opittu etäisyys tai esitys on itse asiassa osa ennustusprosessia.
Muistipohjaiset menetelmät ja opitut optimointialgoritmit
Muistipohjaiset järjestelmät käyttävät toistuvaa tai huomiointipohjaista tilaa tallentaakseen tietoa nykyisestä tehtävästä. Opitut optimointialgoritmit ottavat syötteenä gradientteja tai koulutussignaaleja ja oppivat, miten päivittää toinen malli. Nämä menetelmät voivat löytää sopeutussääntöjä, mutta ne lisäävät parametreja, laskentaa ja toisen tason mahdollista ylisovittamista.
Meta-oppiminen ja kontekstissa oppiminen
Suuret transformerit voivat sopeuttaa tuotostaan esimerkkien avulla, jotka annetaan kehotteessa päivittämättä painoja. Tätä kutsutaan kontekstissa oppimiseksi. Se muistuttaa meta‑oppimiskäyttäytymistä, ja koulutusdata saattaa edistää tehtäväinferensia, mutta kontekstissa oppija ei automaattisesti ole koulutettu perinteisellä episodisella meta‑oppimisen tavoitteella.
Missä meta-oppiminen on hyödyllistä
Mahdollisia sovelluksia ovat personointi, robotiikka, vähäresurssinen tunnistus, tieteelliset tehtävät, joissa on vain vähän mittauksia, sekä nopea sopeutuminen uusiin ympäristöihin. Meta‑oppiminen on houkuttelevinta, kun saatavilla on paljon toisiinsa liittyviä lähdetehtäviä, mutta kohde‑tehtävän data on niukkaa.
Rajoitukset
Meta‑oppiminen voi olla laskennallisesti kallista, koska koulutus sisällyttää sopeutumisen optimointiin. Tulokset ovat herkkiä tehtävien rakenteelle, tukijoukon/kyselyjoukon vuotamiselle, arkkitehtuurille ja domain‑siirtymälle. Malli, joka on koulutettu kapeisiin, homogeenisiin tehtäviin, saattaa sopeutua huonosti kyseisen jakauman ulkopuolella.
Vertailuihin tulisi sisällyttää tavallinen siirto‑oppiminen ja monitehtävä‑peruslinjat. Vahva esikoulutettu esitys, jota seuraa tavallinen hienosäätö, voi olla yksinkertaisempi ja tehokkaampi kuin omistettu meta‑oppimisalgoritmi.
Tehtävät, sopeutuminen ja sisä‑ulko‑optimoinnin rakenne
Meta‑oppiminen kouluttaa tehtäväjakauman yli, jotta oppija voi sopeutua uuteen tehtävään rajoitetun datan tai päivitysten avulla. Jokainen jakso näyttelee tehtävän, jakaa esimerkit tukijoukkoon, jota käytetään sopeutukseen, ja kyselyjoukkoon, jota käytetään arviointiin, ja päivittää jaettua tietoa jaksojen välillä. Metripohjaiset menetelmät oppivat upotuksen ja vertailusäännön; optimointipohjaiset menetelmät oppivat aloituspisteen tai päivityskäyttäytymisen; muistipohjaiset ja mallipohjaiset menetelmät ehdollistuvat tehtäväesimerkeistä. Tehtäväjakauma on todellinen koulutusdata ja sen on muistuttava tulevia sopeutustehtäviä.
Model-agnostic meta‑oppimisessa sisälooppi sopeuttaa parametreja tukiesimerkeillä ja ulkolooppi optimoi suorituskykyä kyselyesimerkeillä sopeutuksen jälkeen. Korkeamman asteen gradientit voivat olla kalliita; ensimmäisen asteen likiarviot vaihtavat tarkkuuden ja kustannuksen. Prototyypilliset verkot esittävät jokaisen luokan tukijoukon keskipisteenä ja luokittelevat etäisyyden perusteella. Nämä menetelmät olettavat, että luokkageometria, sopeutusaskeleet ja jakson rakenne heijastavat käyttöönottoa. Menetelmä voi vaikuttaa oppivan nopeasti hyödyntäen kiinteitä merkintöjä, hankintataiteita tai lähdedatasetien päällekkäisyyksiä.
Arviointi, peruslinjat ja todelliset rajoitukset
Erota koulutus-, validointi- ja testitehtävät – ei pelkästään esimerkit – mitattaessa sopeutumista aidosti näkemättömiin tehtäviin. Raportoi tarkkuus tai häviö shottien ja sopeutusaskelten funktiona, luottamusvälit tehtävien yli, laskenta, muisti ja herkkyys tukijoukon koostumukselle. Vertaa siirto‑oppimiseen, esikoulutetun mallin hienosäätöön, lähimmän naapurin menetelmään ja malliin, joka on koulutettu yhdessä kaikella lähdedatalla. Monet ilmeiset meta‑oppimisen edut kutistuvat, kun peruslinjat saavat vastaavat runkorakenteet, augmentoinnin ja säätämisen.
Todellisissa käyttöönottoissa täytyy olla keino tunnistaa, kun uusi tehtävä on meta‑koulutuksen jakauman ulkopuolella. Huonot tai virheellisesti merkityt tukiesimerkit voivat aiheuttaa nopean ja itsevarman epäonnistumisen. Rajoita päivityksen suuruutta, validoi sopeutuneet mallit, säilytä varajärjestelmä ja suojaa sopeutusdata myrkytykseltä. Seuraa perusmallia, tehtävä‑näytteenottajaa, jakson siemeniä ja sopeutuskoodia. Meta‑oppiminen on hyödyllistä toistuville pienidatan ongelma‑perheille, mutta se ei luo yleistä oppimiskykyä mielivaltaisista esimerkeistä eikä poista tarvetta toimialakohtaiselle arvioinnille.
Käytännön esimerkki: few-shot‑sopeutus koneiden välillä
Valmistaja käsittelee jokaisen konetyypin tehtävänä ja meta‑kouluttaa poikkeavuusrepresentaation monien koneiden yli, joilla on vahvistetut huoltotulokset. Testikoneet jätetään kokonaan pois tehtäväkoulutuksesta. Uudelle koneelle pieni tukijoukko kattaa normaalit käyttötilat mielivaltaisten minuuttien datan sijaan. Meta‑oppimista verrataan esikoulutettuun jäädytettyyn enkooderiin, lähimmän naapurin menetelmään ja tavalliseen hienosäätöön käyttäen samoja tukiesimerkkejä ja laskentaa.
Arvioinnissa toistetaan useita tukivalintoja ja raportoidaan tapahtumien palautus, väärät hälytykset, sopeutusaika ja varianssi. Järjestelmä pidättäytyy toimimasta, kun uuden koneen anturijoukko tai dynamiikka on tehtäväjakauman ulkopuolella. Sopeutuspäivitykset on rajoitettu ja tarkistettu ennen kuin ne vaikuttavat huoltoon. Tukimerkit ja koneen identiteetti on suojattu myrkytykseltä, ja jokainen sopeutettu malli säilyttää perusversioonsa ja esimerkkinsä. Nopea sopeutuminen hyväksytään vain, jos se johdonmukaisesti päihittää yksinkertaisemman siirron realistisessa tehtävämuutoksessa.
Toteutustodisteet ja operatiivinen valmius
Tuotantopäätös vaatii enemmän kuin onnistuneen demonstraation. Määritä kohdekäyttäjät, käyttöympäristö, syötteet, tuotokset, riippuvuudet, omistaja ja kunkin merkittävän vian seuraukset. Perusta toistettavissa oleva peruslinja ja versioitu arviointijoukko ennen säätöä. Testaa tavallisia tapauksia, reunatilanteita, virheellisiä tai puuttuvia syötteitä, jakauman siirtymää, riippuvuuksien katkeamista, väärinkäyttöä sekä ryhmiä tai ympäristöjä, joille palvelu todennäköisesti puuttuu. Mittaa tehtävän laatu yhdessä kalibroinnin tai epävarmuuden, viiveen, läpimenon, resurssikustannusten, saavutettavuuden, yksityisyyden ja turvallisuuden kanssa. Tallenna jokainen muunnos ja raja-arvo, jotta riippumaton tarkastaja voi toistaa tuloksen ja erottaa todisteet houkuttelevasta prototyypistä.
Ennen lanseerausta määritä vastuuhenkilöt julkaisulle, poikkeuksille, muutoksille, peruutukselle ja elinkaaren lopettamiselle. Käytä vaiheistettua käyttöönottoa, säilytä turvallinen varajärjestelmä ja varmista valvonta tahallisesti injektoiduilla vioilla. Operatiivisen telemetrian tulisi paljastaa syötteen laatu, tuotoksen käyttäytyminen, mallin tai säännön versio, riippuvuuksien tila, ihmisen ohitukset ja vahvistetut tulokset keräämättä tarpeetonta arkaluonteista dataa. Määritä hälytysrajat ja vastaavuusvastuuhenkilö, ja tarkastele todellisia todisteita käyttöönoton jälkeen sen sijaan, että olettaisit offline‑suorituskyvyn jatkuvan. Arvioi uudelleen aina, kun datalähteet, käyttäjät, mallit, toimittajat, politiikat, laitteisto tai tavoitteet muuttuvat. Ylläpidettävä järjestelmä tarvitsee myös dokumentoidun palautumisen, tapausten oppimisen, poistamisen ja säilyttämisen menettelytavat sekä selkeän pisteen, jossa se tulee poistaa käytöstä tai korvata.
Usein kysytyt kysymykset
Onko few-shot‑promptaus meta‑oppimista?
Few-shot‑promptaus on kontekstissa tapahtuva sopeutustekniikka. Se saattaa osoittaa käyttäytymistä, joka liittyy oppimiseen tehtävien välillä, mutta sitä ei automaattisesti kouluteta tukijoukon/kyselyjaksojen tai eksplisiittisen meta‑optimointisilmukan avulla.
Mikä on suurin meta‑oppimisen riski?
Epäyhtenäisyys meta‑koulutustehtävien ja kohde‑tehtävän välillä voi saada nopean sopeutumisen näyttämään vahvalta vertailussa, mutta epäonnistua käyttöönotossa. Tehtävän jaon ja lähteen alkuperän on tarkastettava yhtä huolellisesti kuin tavalliset koulutus‑/testijautumat.
Ensisijaiset lähteet











