
AI:n perusteet
Mikä on gradienttilaskeuma?

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Gradient descent on optimointimenetelmä, joka säätää mallin parametreja vähentääkseen tavoitefunktiota. Neuroverkkojen koulutuksessa tämä tavoite on yleensä esimerkeistä laskettu häviö. Gradientti osoittaa jyrkimmän paikallisen nousun suunnan, joten gradienttilaskeuma ottaa askeleen vastakkaiseen suuntaan.
Gradientti kuvaa paikallista herkkyyttä; sen suuruus ei ole suora mitta siitä, kuinka nopeasti malli “oppii”. Todellinen edistyminen riippuu myös oppimisnopeudesta, kaarevuudesta, kohinasta, parametrisaatiosta, optimointialgoritmin tilasta ja datasta.
Keskeiset havainnot
- Backpropagation laskee gradientit, kun taas gradienttilaskeuma käyttää niitä parametrien päivittämiseen.
- Mini‑eräoptimointi on syväoppimisen käytännön standardimenetelmä.
- Oppimisnopeus säätelee päivityksen mittakaavaa ja voi noudattaa aikataulua sen sijaan, että se pienentyisi jokaisen askeleen jälkeen.
- Momentum, AdamW, leikkaus ja normalisointi käsittelevät erilaisia optimointiongelmia.
Peruspäivityssääntö
Parametrivektorille θ, oppimisnopeudelle η ja häviölle L:
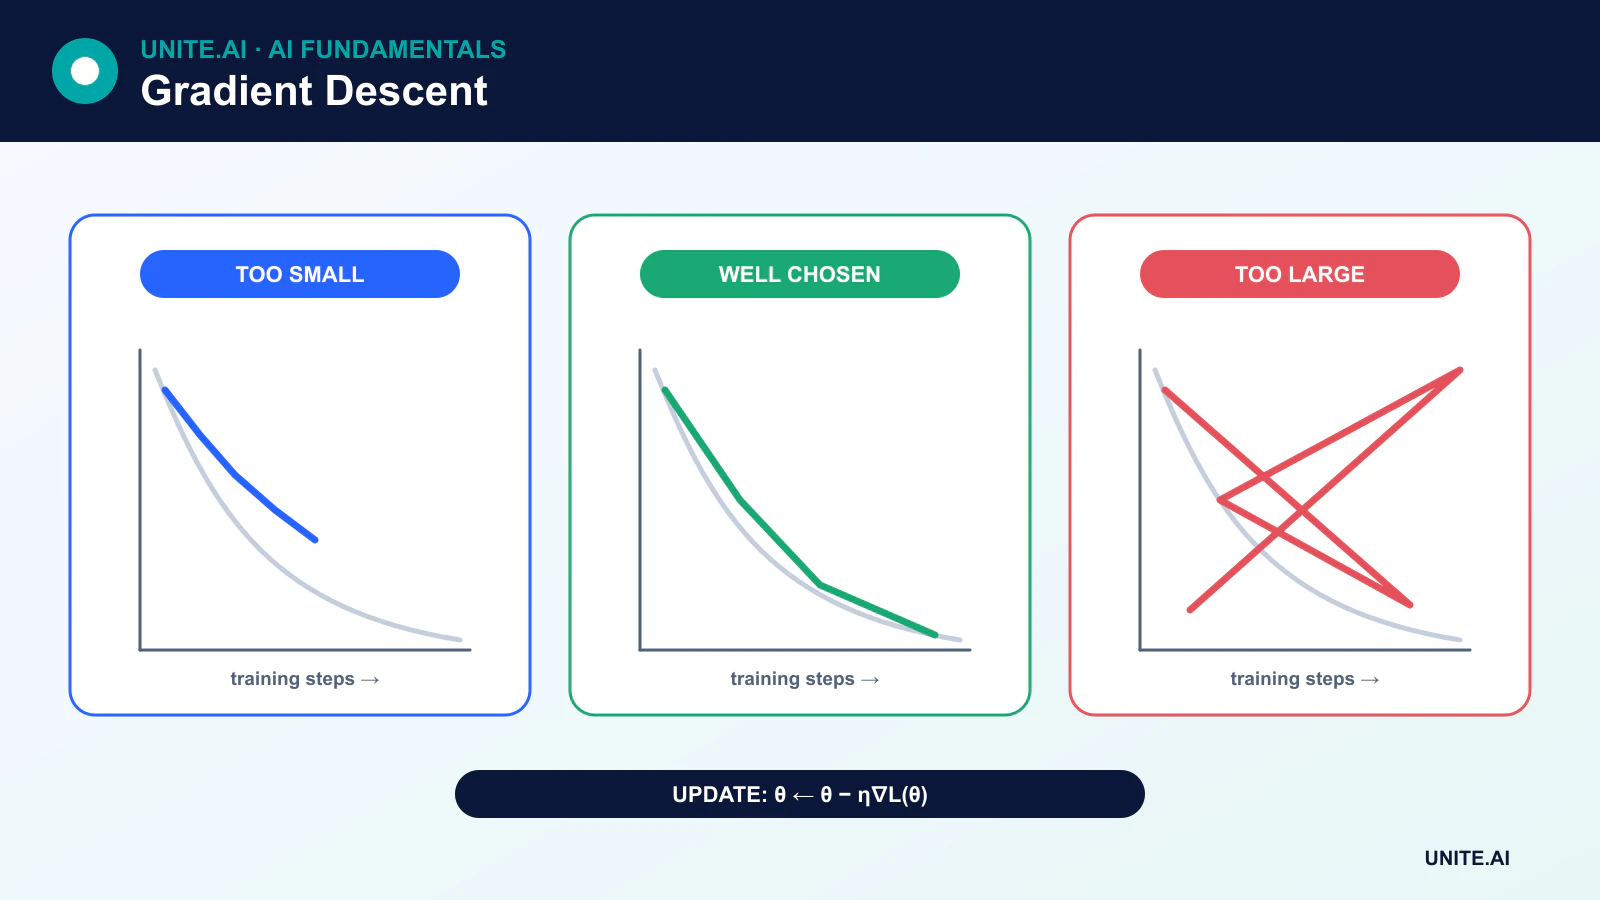
θ ← θ - η∇L(θ)
Gradientti ∇L(θ) sisältää yhden osittaisderivaatan per parametri. Sen vähentäminen liikuttaa paikallisesti alamäkeen. Pysähtymispisteellä gradientti on nolla, mutta se voi olla minimi, maksimi, satulapiste tai tasainen alue. Syväoppimisen häviöpinnoilla on epäkonveksi muoto, joten koulutus ei takaa ainutkertaisen globaalin minimin tai nollahäviön löytämistä.
Erä-, stokastinen- ja mini‑erämenetelmät
Erägradienttilaskeuma
Erägradienttilaskeuma laskee gradientin käyttäen koko harjoitusdataa jokaisessa päivityksessä. Arvio on vakaa, mutta se voi olla aikaa ja muistia kuluttava, eikä yksi päivitys välttämättä hyödynnä nykyaikaisia kiihdyttimiä täysimääräisesti.
Stokastinen gradienttilaskeuma
Tiukka stokastinen gradienttilaskeuma käyttää yhtä satunnaisesti valittua esimerkkiä jokaisessa päivityksessä. Sen gradientit ovat kohinaisia, mikä voi auttaa häviöpinon tutkimisessa, mutta yksittäisten esimerkkien operoinnit voivat olla tehottomia rinnakkaisessa laitteistossa.
Mini‑erägradienttilaskeuma
Mini‑eräkoulutus arvioi gradientin esimerkkien osajoukosta. Se tasapainottaa tilastollisen kohinan tehokkaiden matriisitoimintojen kanssa, ja on tavallinen lähestymistapa syväoppimisessa. Eräkoko vaikuttaa muistiin, läpimenoon, gradienttikohinaan, normalisointiin ja joskus yleistettävyyteen.
Oppimisnopeuden valinta
Liian suuri nopeus voi ohittaa hyödylliset alueet tai aiheuttaa divergenssin. Liian pieni nopeus voi tehdä koulutuksesta epäkäytännöllisen hitaan tai se voi juuttua tasaisiin alueisiin. Paras mittakaava riippuu optimointialgoritmista, eräkoosta, mallista, alustusmenetelmästä ja tavoitteesta.
Aikataulut voivat lämmittää asteittain, pienentää tiettyjen virstanpylväiden kohdalla, noudattaa kosinikäyrää tai reagoida validointiedistymiseen. Nopeuden ei tarvitse pienentyä monotonisesti jokaisen päivityksen jälkeen. Lämmin uudelleenkäynnistys ja sykliset aikataulut nostavat sitä tarkoituksellisesti koulutuksen eri vaiheissa.
Momentum
Momentum ylläpitää eksponentiaalista liukuvaa keskiarvoa menneistä gradientteista. Se voi nopeuttaa edistymistä johdonmukaisilla suuntiin ja vähentää värähtelyä jyrkissä, kapeissa suunnissa. Nesterov‑tyylinen momentum arvioi tai approksimoi gradientin katsomalla eteenpäin momentum‑suunnan mukaisesti.
Adaptatiiviset optimointialgoritmit
RMSProp skaalaa päivityksiä käyttämällä neliögradienttien liukuvaa keskiarvoa. Adam yhdistää momentum‑tyyppiset ensimmäiset momentit toisen momentin skaalaamiseen. AdamW erottaa painojen hajoamisen adaptatiivisesta gradienttipäivityksestä, ja sitä käytetään laajasti transformereissa.
Adaptatiiviset optimointialgoritmit tekevät usein varhaisesta koulutuksesta helpompaa, mutta ne eivät ole automaattisesti parempia jokaiselle mallille tai lopulliselle yleistämistavoitteelle. Optimointialgoritmien vertailu vaatii vastaavia aikatauluja ja tarkkaa säätöä.
Gradientin leikkaus ja kertymä
Gradientin leikkaus rajoittaa gradientin normia tai arvoja vähentääkseen räjähtävien gradienttien vaikutusta, erityisesti toistuvassa tai epävakaassa koulutuksessa. Gradienttikertymä lisää gradientteja useiden pienempien erien yli ennen päivitystä, lähentäen suurempaa tehokasta erää, kun muisti on rajoitettu.
Optimoinnin seuranta
Seuraa koulutus- ja validointihäviöitä, tehtävämetriikoita, oppimisnopeutta, gradientti- ja parametrinormeja sekä numeerisia virheitä. Koulutushäviön lasku, kun validointisuoritus heikkenee, viittaa ylisovittamiseen, ei optimoinnin onnistumiseen, jonka tulisi automaattisesti jatkua.
Optimointi minimoi sille annetun tavoitteen. Alhainen häviö ei todista, että data, metriikka tai todellinen käyttäytyminen on sopivaa. Vuoto, huonot merkinnät ja epäyhtenäinen tavoite voivat tuottaa hyvin optimoidun mutta haitallisen mallin.
Optimoinnin geometria ja päivityssäännöt
Gradienttilaskeuma päivittää parametreja vastakkaiseen suuntaan kuin häviön gradientti. Täyserädescent käyttää jokaista harjoitusesimerkkiä jokaisessa askeleessa; stokastinen descent käyttää yhtä; mini‑erämenetelmät arvioivat gradientin osajoukosta ja hallitsevat syväoppimista. Oppimisnopeus määrää askeleen mittakaavan. Liian pieni hukkaa laskentaa tai pysähtyy; liian suuri aiheuttaa värähtelyä tai divergenssiä. Momentum kerää liukuvan suunnan, kun taas adaptatiiviset menetelmät kuten Adam skaalaavat koordinaatteja gradienttimomenttien avulla. Niiden erilaiset implisiittiset vinoumat voivat tuottaa malleja, joilla on samanlainen koulutushäviö mutta erilainen yleistettävyys.
Neuroverkkojen häviöpinnoilla on tasaisia ja teräviä alueita, satulapisteitä, symmetrioita ja huonosti ehdollistettuja suuntia. Ominaisuuksien skaalaus, normalisointi, alustus, residual‑yhteydet ja esikondisointi muuttavat optimoinnin näkemää geometriaa. Aikataulut voivat lämmittää, pienentää, kiertää tai reagoida tasankoihin. Painojen hajoaminen eroaa pelkästä L2‑rangaistuksen lisäämisestä joissakin adaptatiivisissa optimointialgoritmeissa. Eräkoko vaikuttaa kohinaan, muistiin, rinnakkaisuuteen ja oppimisnopeuden alueeseen, joten optimointialgoritmien vertailu vaatii vastaavia koulutuksen budjetteja ja tarkkaa säätöä.
Diagnostointi, toistettavuus ja pysäyttäminen
Seuraa koulutus- ja validointihäviöitä, tehtävämetriikoita, gradientti- ja parametrinormeja, oppimisnopeutta, läpimenoa ja numeerisia varoituksia. Divergenssi voi johtua vioittuneista eristä, virheellisistä merkinnöistä, epävakaasta sekatarkkuudesta tai virheellisestä häviön aggregoinnista. Tasangot voivat viitata aliresurssisuuteen, kyllästyneisiin aktivaatioihin, huonoihin ominaisuuksiin, liialliseen regularisointiin tai aikatauluongelmaan. Ylisovittaminen vaatii dataa, augmentaatiota, regularisointia tai varhaista pysäytystä – ei väitettä, että optimointialgoritmi epäonnistui. Tarkastele edustavia virheitä ja vertaa yksinkertaista perusmallia ennen koulutuksen monimutkaisuuden kasvattamista.
Toistettavuus vaatii siemeniä, datan järjestystä, koodia, konfiguraatiota, laitteisto- ja kirjastoversioita, vaikka jotkut kiihdyttimien ytimet pysyvät epädeterministisinä. Tallenna tarkistuspisteet optimointialgoritmin ja aikataulun tilan kanssa, jotta koulutus voidaan jatkaa johdonmukaisesti. Valitse tarkistuspiste validointikriteerien perusteella, jotka on määritetty etukäteen, ja varaa koskematon testijoukko. Hajautetussa koulutuksessa varmista tehokas eräkoko, gradienttien keskiarvo ja epäonnistuneiden työntekijöiden käsittely. Optimointi minimoi valitun tavoitteen saatavilla olevassa datassa; se ei takaa kalibroituja todennäköisyyksiä, kausaalista päättelyä, oikeudenmukaisuutta, turvallisuutta tai todellista hyötyä.
Käytännön esimerkki: optimointialgoritmin säätäminen kielimallille
Tiimi määrittelee tokenisoijan, datan järjestyksen, mallin, tehokkaan erän ja koulutustoken‑budjetin, ja vertaa sitten SGD:tä momentumin kanssa sekä AdamW:ta perusteltujen oppimisnopeus‑aikataulujen kautta. Lämmitys, pienennys, painojen hajoaminen, leikkaus ja tarkkuus kirjataan. Jokainen ehdokas ajetaan useilla siemenillä, ja validointi käyttää erillistä aikajaksoa sekä tehtäväarvioita. Läpimeno ja energia raportoidaan yhdessä häviön kanssa, jotta hieman parempaa optimointialgoritmia ei valita suhteettoman korkealla kustannuksella.
Diagnostiikka paljastaa, onko epävakaus peräisin yhdestä datan sirusta, liiallisesta askelkoosta, alivuodosta tai mallin arkkitehtuurista. Tarkistuspisteet säilyttävät optimointialgoritmin ja aikataulun tilan ja ne käynnistetään uudelleen testissä. Lopullinen valinta perustuu validoinnin laatuun ja kestävyyteen, ei alhaisimpaan koulutushäviöön. Suljettu testijoukko ajetaan kerran valinnan jälkeen. Tuotannon inferenssi kalibroidaan ja valvotaan erikseen, koska optimointialgoritmin menestys esikoulutuksessa ei takaa turvallista tai totuudenmukaista käyttäytymistä.
Toteutustodisteet ja operatiivinen valmius
Tuotantopäätös vaatii enemmän kuin onnistuneen demonstraation. Määritä kohdekäyttäjät, käyttöympäristö, syötteet, tulosteet, riippuvuudet, omistaja ja kunkin tärkeän vian seuraukset. Perusta toistettavissa oleva peruslinja ja versioitu arviointijoukko ennen säätöä. Testaa tavalliset tapaukset, reunat, virheelliset tai puuttuvat syötteet, jakauman siirtymä, riippuvuuksien katkos, väärinkäyttö sekä ryhmät tai ympäristöt, jotka todennäköisesti jäävät huomiotta. Mittaa tehtävän laatu yhdessä kalibroinnin tai epävarmuuden, viiveen, läpimenon, resurssikustannusten, saavutettavuuden, yksityisyyden ja turvallisuuden kanssa. Tallenna jokainen muunnos ja raja‑arvo, jotta riippumaton tarkastaja voi toistaa tuloksen ja erottaa todisteet houkuttelevasta prototyypistä.
Ennen julkaisua määritä vastuuhenkilöt julkaisulle, poikkeuksille, muutoksille, palautukselle ja elinkaaren lopettamiselle. Käytä vaiheistettua käyttöönottoa, säilytä turvallinen varajärjestelmä ja varmista valvonta tarkoituksellisesti injektoiduilla vioilla. Operatiivisen telemetrian tulisi paljastaa syötteen laatu, tulosteen käyttäytyminen, mallin tai säännön versio, riippuvuuksien tila, ihmisen ohitukset ja vahvistetut tulokset keräämättä tarpeetonta arkaluontoista dataa. Määritä hälytysraja‑arvot ja vastaavan omistajan, tarkastele sitten todellista näyttöä käyttöönoton jälkeen sen sijaan, että oletetaan offline‑suorituskyvyn säilyvän. Arvioi uudelleen aina kun datalähteet, käyttäjät, mallit, toimittajat, politiikat, laitteisto tai tavoitteet muuttuvat. Ylläpidettävä järjestelmä tarvitsee myös dokumentoidun palautumisen, tapausten oppimisen, poistamisen ja säilytyskäytännöt sekä selkeän pisteen, jossa se tulee poistaa käytöstä tai korvata.
Usein kysytyt kysymykset
Saako gradienttilaskeuma aina globaalin minimin?
Ei. Konveksisille tavoitteille sopivat ehdot tarjoavat vahvoja takuita. Syväverkkojen tavoitteet ovat epäkonveksisia, ja käytännön optimointialgoritmit pyrkivät yleensä hyödylliseen ratkaisuun sen sijaan, että ne todistaisivat löytäneensä ainutkertaisen globaalin minimin.
Miksi nollagradientti voi olla harhaanjohtava?
Nolla‑tai hyvin pieni gradientti voi viitata minimiin, maksimiin, satulapisteeseen, saturaatioon tai tasaisiin tasankoihin. Koulutuksen diagnostiikan on otettava huomioon häviöhistoria, kaarevuus, parametrin mittakaava ja validointisuoritus.
Ensisijaiset viitteet












