
Fundamentos de la IA
¿Qué es AIOps? Inteligencia artificial para operaciones de TI

 Añade Unite.AI a tus fuentes preferidas en Google
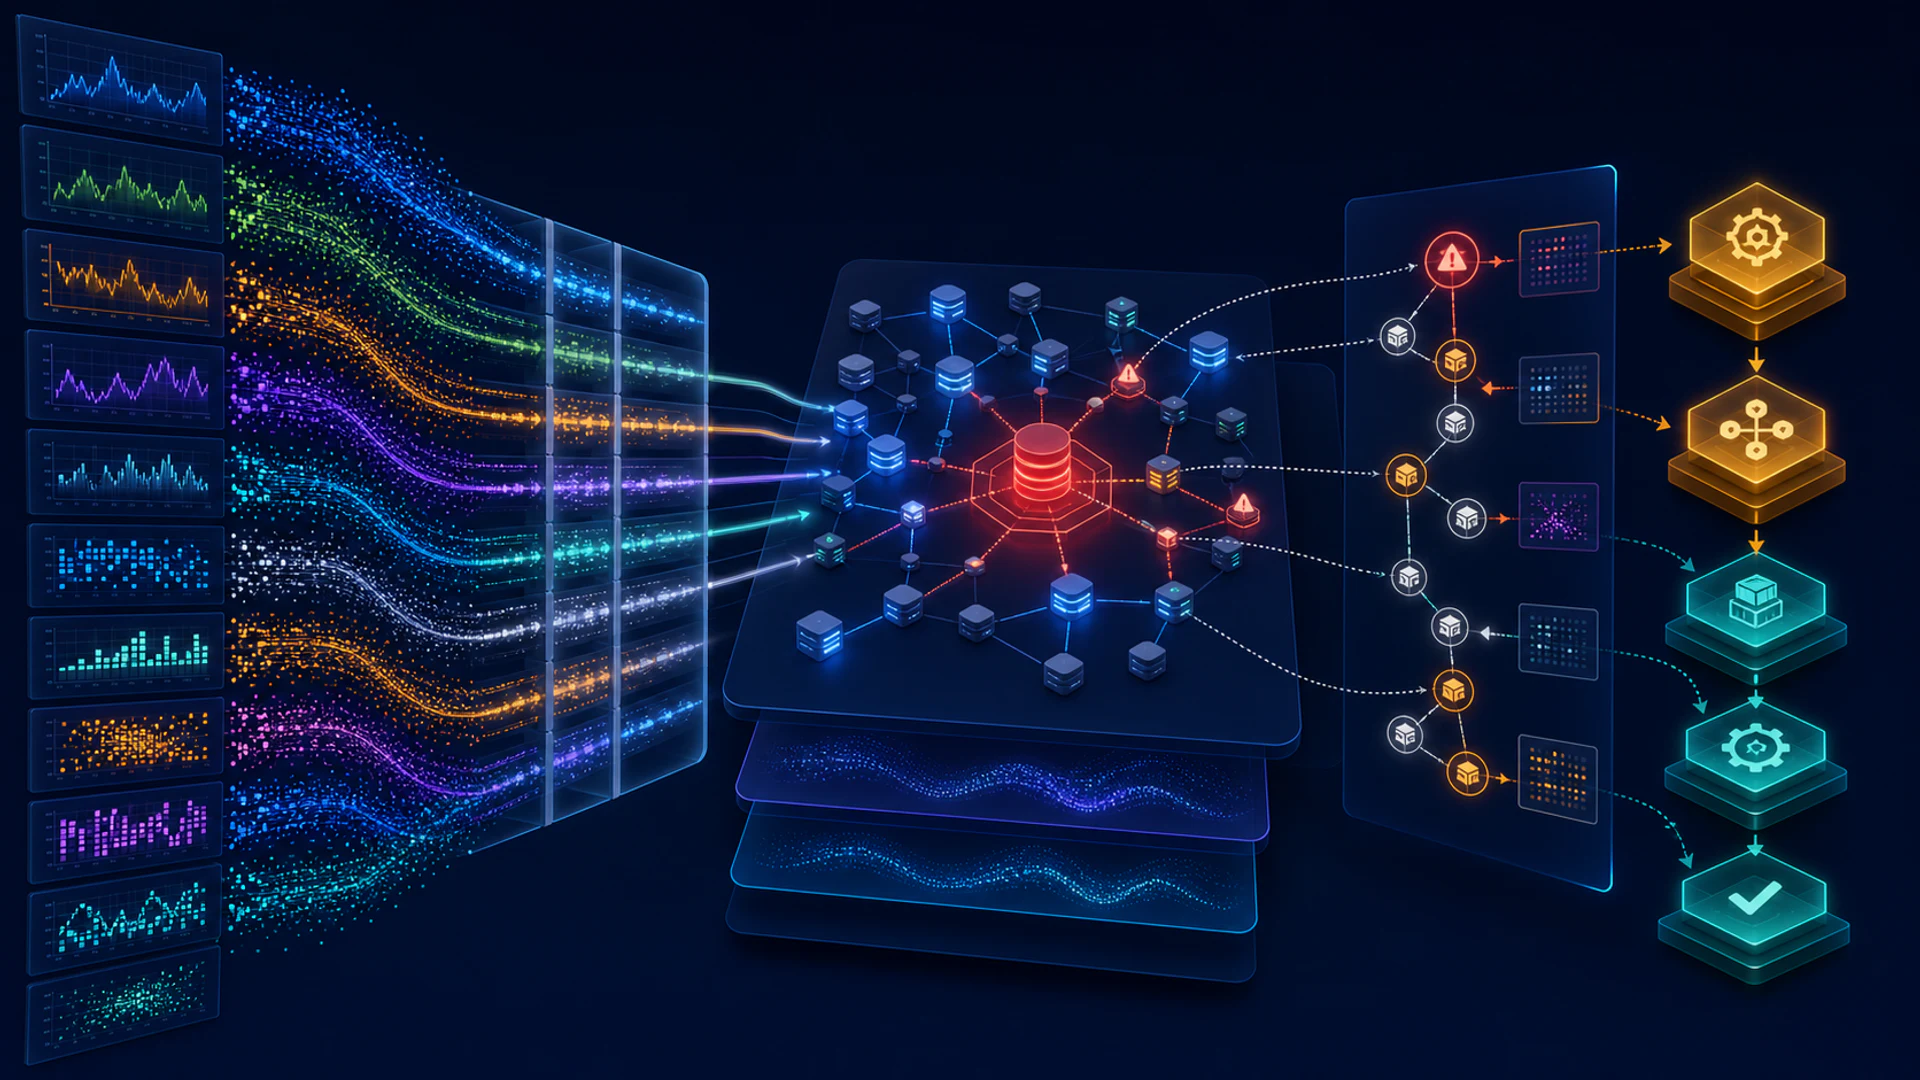
AIOps aplica aprendizaje automático y automatización a los datos de operaciones de TI para que los equipos puedan detectar comportamientos inusuales, reducir alertas duplicadas, conectar eventos relacionados, clasificar causas probables y recomendar o ejecutar acciones de respuesta.
AIOps no es un reemplazo autónomo para las operaciones. Es una capa dentro de un sistema ITOps, y su valor depende de la calidad de la telemetría, la topología de servicios, el historial de cambios, la retroalimentación humana y los límites seguros de automatización.
Conclusiones clave
- Normalizar eventos y añadir contexto de servicio antes de aplicar modelos sofisticados.
- La detección de anomalías identifica desviaciones, no necesariamente fallas o causas raíz.
- La correlación y la clasificación de causas probables deben mostrar evidencia e incertidumbre.
- La remediación automatizada necesita el principio de menor privilegio, aprobaciones, canarios, reversión y monitoreo de resultados.
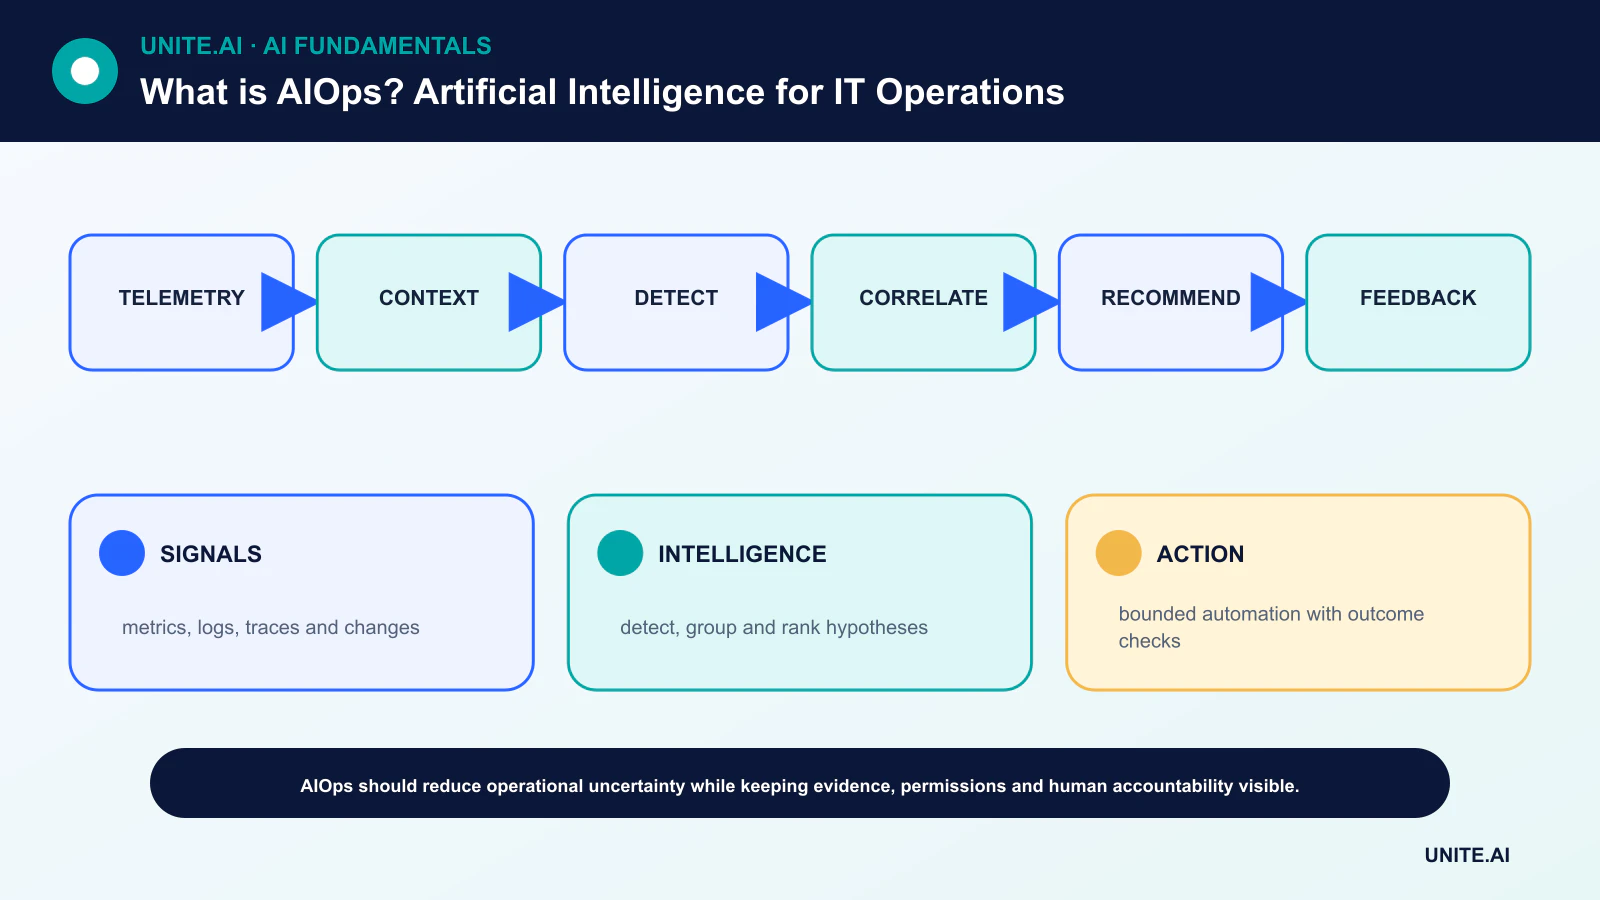
Construir una capa de datos operacionales
Las plataformas AIOps ingieren métricas, registros, trazas, alertas, tickets, topología, implementaciones y cambios de configuración. Las marcas de tiempo, los identificadores y la propiedad del servicio deben reconciliarse para que el sistema pueda conectar señales que se refieren al mismo incidente.
La falta o inconsistencia de contexto genera correlaciones falsas. La retención de datos, el acceso y la privacidad también son importantes porque los registros pueden contener credenciales o información personal. Aplique la misma gobernanza que se espera de otros sistemas de datos de producción.
Detección y reducción de ruido
Los umbrales estáticos funcionan para límites conocidos; los métodos estadísticos y de aprendizaje automático pueden modelar estacionalidad o patrones multivariados. La deduplicación agrupa notificaciones repetidas, mientras que la supresión elimina alertas que no son accionables bajo reglas definidas.
Una anomalía es solo una desviación del comportamiento esperado. Los lanzamientos planificados, campañas de tráfico y ciclos de negocio pueden ser inusuales pero saludables. Evalúe precisión, exhaustividad, retraso de detección y carga de trabajo del operador en lugar de celebrar la cantidad de alertas eliminadas.
Correlación y causa probable
La correlación de eventos vincula síntomas a través de un grafo de dependencias y una ventana temporal. Un modelo de causa probable puede clasificar componentes o cambios recientes que podrían explicar el incidente. Esto prioriza la investigación; no establece causalidad.
Muestre evidencia contributiva, hipótesis alternativas y nivel de confianza. IA explicable es especialmente importante cuando un operador debe decidir si aislar un servicio o revertir una implementación.
De la recomendación a la automatización
Un manual de operaciones puede recopilar diagnósticos, reiniciar un trabajador sin estado o escalar la capacidad. Los copilotos pueden resumir incidentes y recuperar procedimientos. Los agentes pueden planificar llamadas a herramientas, pero los permisos de producción deben ser limitados y las acciones deben validarse contra el estado actual.
Comience con recomendaciones de solo lectura. Promueva acciones maduras mediante simulación, aprobación humana, canarios y reversión automática. Registre las entradas, la versión del modelo, la autorización y el resultado de cada acción.
Evaluación y retroalimentación operativa
Reproduzca incidentes históricos sin filtrar sus etiquetas finales en las características. Pruebe en servicios y cambios nuevos, mida supresión falsa, tiempo de detección, tiempo de mitigación, aceptación del operador y recurrencia. Compare con reglas existentes y líneas base simples.
El desvío ocurre cuando cambian la arquitectura, el tráfico o las prácticas de respuesta. Cierre el ciclo permitiendo que los operadores corrijan correlaciones y resultados, y luego revise si el sistema reduce el trabajo manual sin ocultar riesgos o crear complacencia en la automatización.
Canal de datos y analítica de AIOps
AIOps aplica métodos estadísticos y de aprendizaje automático a los datos de operaciones como métricas, registros, trazas, eventos, topología, tickets y cambios. El canal recopila y normaliza señales, las enriquece con contexto de servicio y propiedad, detecta anomalías, correlaciona eventos relacionados, estima causas probables y recomienda o desencadena acciones. La calidad depende de marcas de tiempo, identificadores, topología y registros de cambios. Un modelo sofisticado no puede correlacionar de forma fiable alertas que se refieren al mismo servicio bajo nombres inconsistentes.
La detección de anomalías aprende líneas base por servicio, temporada y estado operativo; los umbrales estáticos pueden ser mejores para límites de seguridad conocidos. La correlación de eventos agrupa síntomas en un incidente usando tiempo, topología, texto y patrones históricos. La clasificación de causas raíz propone hipótesis pero puede confundir la primera falla observada con la causa real o pasar por alto una dependencia compartida ausente de la topología. Los resúmenes en lenguaje natural pueden ayudar a los respondedores, pero deben enlazar a la evidencia cruda y expresar incertidumbre.
Automatización, evaluación y retroalimentación
Comience con soporte a la decisión y remediación reversible de bajo riesgo. Cada acción automatizada necesita autorización, precondiciones, alcance limitado, tiempo de espera, verificación de postcondiciones, reversión y un registro de auditoría. El modelo no debe otorgarse credenciales ni tratar el texto de los registros como instrucciones confiables. Los respondedores humanos deben aceptar, rechazar o corregir recomendaciones, y esos resultados deben actualizar reglas o datos de entrenamiento mediante revisión en lugar de aprendizaje autónomo sin control.
Evalúe la reducción de alertas sin perder incidentes, tiempo de anticipación de detección, precisión de correlación, clasificación de causa raíz, éxito de la remediación, tiempo de recuperación, recurrencia y carga de trabajo del respondedor. Use reproducciones históricas y fallas inyectadas, pero tenga en cuenta etiquetas de incidentes incompletas. Mida por servicio y tipo de incidente; un promedio puede ocultar fallas peligrosas en sistemas críticos raros. Compare con reglas determinísticas y observabilidad mejorada antes de añadir complejidad de IA.
Gobernanza y modos de falla
AIOps puede amplificar brechas de telemetría, automatizar un diagnóstico erróneo o crear acciones correlacionadas a nivel de flota. Aísle entornos, limite la concurrencia, mantenga un interruptor de emergencia fuera del modelo y ensaye la falla de la propia plataforma AIOps. Proteja los registros y tickets que contengan secretos o datos personales. Monitoree el desvío del modelo, la frescura de la topología, acciones falsas y anulaciones. AIOps respalda operaciones confiables cuando hace que la evidencia y la acción limitada sean más rápidas; no es un reemplazo autónomo de la propiedad del servicio, el comando de incidentes o el juicio de ingeniería.
Ejemplo práctico: AIOps para un incidente de pago
AIOps agrupa un aumento de errores de API, saturación de bases de datos y alertas regionales en un solo incidente y lo enriquece con una implementación reciente, topología y propietario. Clasifica la implementación como un posible contribuyente, pero muestra la telemetría cruda y alternativas. Una política determinista pausa la implementación adicional; un comandante de incidentes humano aprueba el cambio de tráfico después de verificar que la capacidad y la consistencia de datos son seguras.
El sistema mide la precisión del agrupamiento, el tiempo de anticipación de detección, la exactitud de la clasificación, la aceptación del respondedor, la recuperación y la remediación falsa en reproducciones históricas y jornadas de simulación. Todas las acciones automatizadas tienen límites, idempotencia, verificaciones de postcondiciones y reversión. Los registros se sanitizan y el texto malicioso no puede convertirse en una orden. Después del incidente, la causa confirmada y los resultados de las acciones actualizan las reglas revisadas y los datos de evaluación. La plataforma AIOps ayuda con la evidencia y la coordinación; nunca reemplaza el comando de incidentes ni la autorización externa.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, las entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de ajustar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, desplazamiento de distribución, interrupción de dependencias, uso indebido y los grupos o entornos más propensos a quedar desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la publicación, excepciones, cambios, reversión y retiro. Utilice un despliegue escalonado, conserve una alternativa segura y verifique la monitorización con fallas inyectadas deliberadamente. La telemetría operativa debe revelar la calidad de las entradas, el comportamiento de las salidas, la versión del modelo o regla, la salud de las dependencias, las anulaciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalúe siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿Es AIOps lo mismo que la observabilidad?
No. La observabilidad suministra y explora señales del sistema; AIOps utiliza análisis y automatización sobre esas señales. Cada una puede existir sin la otra.
¿Puede AIOps determinar la causa raíz automáticamente?
Puede clasificar hipótesis y recopilar evidencia, pero las afirmaciones causales requieren topología, contexto de cambios y validación. Muchos incidentes tienen causas interactivas.
Referencias principales












