Fundamentos de la IA
¿Qué es la Operación de TI (ITOps)?

 Añade Unite.AI a tus fuentes preferidas en Google
Operaciones de TI (ITOps) es el trabajo de gestionar los servicios tecnológicos de los que depende una organización. Abarca cómputo, redes, identidad, puntos finales, plataformas en la nube, bases de datos, almacenamiento, copias de seguridad y los procesos operativos que mantienen esos componentes disponibles, seguros y soportables.
Las ITOps modernas no se limitan a un centro de operaciones de red que observa paneles. Los equipos gestionan cada vez más infraestructura definida por software, servicios de plataforma, automatización y propiedad distribuida, al tiempo que conservan la responsabilidad de incidentes, capacidad, continuidad y niveles de servicio.
Conclusiones clave
- ITOps gestiona servicios y sus dependencias en entornos locales, en la nube y de borde.
- La observabilidad, la configuración y el inventario proporcionan el contexto necesario para interpretar fallas.
- La gestión de incidentes restaura el servicio; la gestión de problemas aborda causas recurrentes o sistémicas.
- ITOps se superpone con ITSM, SRE, DevOps, SecOps y AIOps, pero no es idéntico a ninguno de ellos.
Servicios, activos y configuración
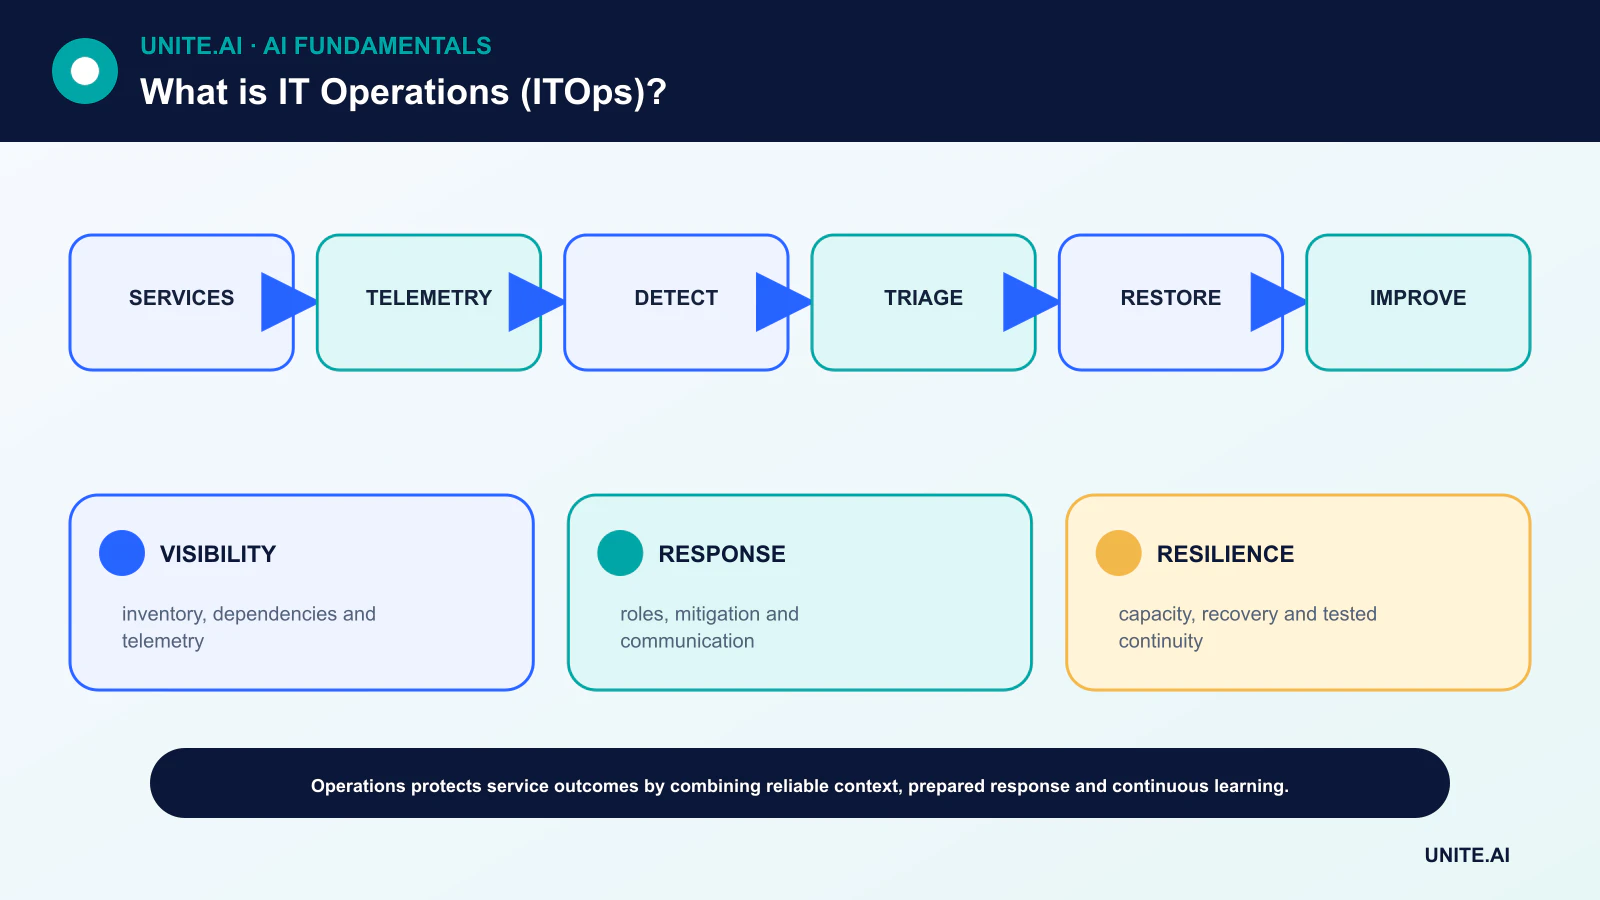
Las operaciones comienzan con conocer qué servicios existen, quién los posee, qué usuarios dependen de ellos y qué infraestructura los soporta. El inventario de activos registra los componentes; la gestión de configuración registra relaciones relevantes y el estado controlado.
Un inventario que nunca se concilia resulta engañoso. Automatice el descubrimiento donde sea útil, identifique fuentes autorizadas y registre la confianza o frescura en lugar de pretender que cada mapa de dependencias está completo.
Observabilidad y objetivos de servicio
Las métricas cuantifican el comportamiento, los registros capturan eventos y los trazos siguen el trabajo a través de los servicios. Las comprobaciones sintéticas pueden probar un recorrido de usuario. La observabilidad útil comienza con preguntas y objetivos de servicio, y luego recoge las señales necesarias para responderlas.
Las alertas deben identificar condiciones que requieran acción oportuna. Los umbrales sin impacto para el usuario generan ruido, mientras que la falta de contexto de dependencias retrasa el diagnóstico. AIOps puede ayudar a la correlación, pero necesita telemetría confiable y retroalimentación operativa.
Gestión de incidentes, problemas y cambios
La gestión de incidentes coordina la detección, el triaje, la mitigación, la comunicación y la recuperación. Roles claros reducen la confusión bajo presión. Una solución alternativa temporal puede restaurar el servicio mientras una investigación posterior del problema aborda causas más profundas.
La gestión de cambios evalúa y registra el riesgo sin convertir cada cambio en una cola. Los cambios estándar, automatizados y de bajo riesgo pueden seguir rutas preaprobadas; los cambios de alto impacto requieren evidencia más sólida, programación y preparación de reversión.
Capacidad, resiliencia y continuidad
Los equipos pronostican la demanda de recursos, eliminan cuellos de botella y prueban el comportamiento bajo carga. Las copias de seguridad son útiles solo cuando se prueba su restauración. La redundancia ayuda solo cuando los modos de falla son independientes y la conmutación por error realmente funciona.
La continuidad del negocio define prioridades, tiempo de recuperación y pérdida de datos aceptable. Las dependencias de identidad, DNS, planos de control de la nube y proveedores deben incluirse en los ejercicios en lugar de asumirse disponibles.
ITOps, ITSM, SRE y DevOps
La gestión de servicios de TI suministra procesos para alinear los servicios con las necesidades organizacionales. La ingeniería de confiabilidad del sitio aplica la ingeniería de software a las operaciones y utiliza objetivos de nivel de servicio y presupuestos de error. DevOps une la retroalimentación de desarrollo y operaciones.
SecOps se centra en amenazas y respuesta, mientras que ITOps mantiene una salud de servicio más amplia. Los organigramas difieren; el requisito importante es la propiedad explícita y la evidencia compartida entre estas disciplinas.
El modelo operativo de ITOps
Las operaciones de TI mantienen los servicios tecnológicos de la organización disponibles, con buen rendimiento, seguros y recuperables. El alcance suele incluir puntos finales, identidad, redes, servidores, nube, almacenamiento, colaboración, bases de datos, monitoreo, mesa de servicio, copias de seguridad y servicios de proveedores. Las ITOps modernas abarcan infraestructura propia y plataformas gestionadas, por lo que la responsabilidad debe ser explícita incluso cuando la operación se externaliza. Un inventario de configuración o de servicios conecta los componentes técnicos con propietarios, usuarios, dependencias, clasificación de datos y criticidad empresarial.
La gestión de servicios organiza incidentes, solicitudes, problemas, cambios, activos, conocimiento y niveles de servicio. La gestión de incidentes restaura el servicio; la gestión de problemas investiga causas recurrentes; la habilitación de cambios evalúa y coordina el riesgo. Tratar cada cambio como una aprobación lenta genera derivaciones, mientras que la automatización sin gobernanza crea fallas descontroladas. Los cambios de bajo riesgo estándar pueden preautorizarse y automatizarse; los cambios de alto riesgo necesitan evidencia, comunicación, reversión y programación basadas en el impacto.
Confiabilidad, capacidad y continuidad
El monitoreo debe seguir los servicios orientados al usuario y sus dependencias, no solo el recuento de dispositivos. Defina disponibilidad, latencia, capacidad, frescura y objetivos de soporte con los propietarios del negocio. Alerta sobre síntomas accionables y consumo del presupuesto de error; enriquezca los eventos con la propiedad y los cambios recientes. Los modelos de planificación de capacidad consideran demanda, saturación, licencias y tiempo de entrega. La elasticidad de la nube reduce la demora de aprovisionamiento, pero no elimina cuotas, límites regionales o control de costos.
La continuidad del negocio requiere copias de seguridad probadas, restauración, recuperación de identidad, alternativas de red, contactos de proveedores y procedimientos manuales. Defina objetivos de tiempo de recuperación y punto de recuperación por servicio. Una copia de seguridad no es evidencia de recuperación hasta que se restaura y valida. Practique escenarios de ransomware, pérdida de región, certificados caducados, interrupción de identidad y falla de proveedores. Rastree la configuración y la infraestructura como código siempre que sea posible para que la recuperación sea reproducible.
Seguridad, automatización y métricas
Utilice el principio de menor privilegio, gestión de parches y vulnerabilidades, controles de puntos finales, segmentación de red, registro y respuesta a incidentes. Automatice el trabajo repetitivo con idempotencia, límites, aprobaciones y auditoría. Mida la disponibilidad del servicio, recurrencia de incidentes, cumplimiento de solicitudes, fallos de cambios, recuperación, exposición a parches, capacidad, costo y satisfacción del usuario, no solo el cierre de tickets. ITOps tiene éxito cuando la tecnología respalda el trabajo de forma predecible y puede recuperarse de una falla, no cuando la infraestructura parece ocupada o los paneles muestran más indicadores verdes.
Ejemplo práctico: recuperación de un servicio de colaboración
Una empresa define un objetivo de tiempo de recuperación de cuatro horas y un objetivo de punto de recuperación de una hora para una plataforma de colaboración. Inventariza identidad, DNS, red, datos, claves, configuración, integraciones y dependencias de proveedores. Un ejercicio de recuperación asume que la región primaria y la cuenta de administrador no están disponibles. Los operadores activan una identidad de emergencia protegida de forma independiente, restauran la configuración del servicio y los datos en una región aislada, y validan permisos, mensajes, integraciones y acceso de clientes. Los propietarios del negocio verifican el servicio restaurado con recorridos de usuario realistas en lugar de depender solo de verificaciones de salud de la infraestructura.
El ejercicio registra la pérdida real de datos, el tiempo transcurrido, los pasos manuales, los contactos fallidos y las dependencias ocultas. Una copia de seguridad que restaura archivos pero no claves de cifrado o políticas de identidad se marca como incompleta. Las acciones correctivas reciben responsables y fechas, y el manual de operaciones se actualiza y vuelve a probar. Se incluyen plantillas de monitoreo y comunicación. La organización mide la evidencia de recuperación en lugar del éxito del trabajo de copia de seguridad, reconociendo que unas ITOps confiables deben restaurar el servicio que los usuarios necesitan bajo condiciones de falla realistas.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de afinar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, cambios de distribución, interrupción de dependencias, uso indebido y los grupos o entornos con mayor probabilidad de quedar desatendidos. Mida la calidad de la tarea junto con calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la publicación, excepciones, cambios, reversión y retiro. Use un despliegue escalonado, conserve una alternativa segura y verifique el monitoreo con fallas inyectadas deliberadamente. La telemetría operativa debe revelar la calidad de entrada, comportamiento de salida, versión del modelo o regla, salud de dependencias, intervenciones humanas y resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento fuera de línea persistirá. Reevalue siempre que cambien fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿Cuál es el objetivo principal de ITOps?
Entregar y restaurar servicios tecnológicos confiables dentro de los límites acordados de seguridad, rendimiento, continuidad y costo.
¿La infraestructura en la nube es operada completamente por el proveedor de la nube?
No. Los proveedores operan partes de la plataforma subyacente, mientras que los clientes siguen siendo responsables de la configuración, identidad, datos, cargas de trabajo, monitoreo y muchas decisiones a nivel de servicio.
Referencias principales