Fundamentos de la IA
¿Qué es la automatización de incidentes? Flujos de trabajo, salvaguardas y casos de uso

 Añade Unite.AI a tus fuentes preferidas en Google
La automatización de incidentes utiliza software para detectar, enriquecer, enrutar, coordinar y, a veces, remediar incidentes operacionales o de seguridad. Conecta las señales de monitoreo con runbooks, sistemas de tickets, comunicación, controles de acceso y acciones de recuperación, de modo que los respondedores dediquen menos tiempo a copiar datos y más tiempo a tomar decisiones.
La automatización no implica la eliminación de la responsabilidad humana. Un programa seguro distingue los pasos determinísticos de bajo riesgo de las acciones que pueden afectar a clientes o a la producción, y luego aplica aprobaciones, credenciales limitadas, registros de auditoría, tiempos de espera y retrocesos según el impacto.
Conclusiones clave
- Automatiza la recopilación repetible de evidencia antes de intentar una remediación autónoma.
- Utiliza la gravedad, la confianza, el radio de impacto y la reversibilidad para seleccionar un nivel de aprobación.
- Trata cada runbook como código de producción versionado, con pruebas y un propietario.
- Mide la detección, el reconocimiento, la recuperación, la recurrencia y el impacto en el usuario, no solo el volumen de alertas.
De la señal a la respuesta coordinada
Un flujo de trabajo puede desduplicar alertas, adjuntar implementaciones y registros recientes, identificar al propietario del servicio, abrir un registro de incidente, notificar al equipo de guardia, crear un canal de comunicación e iniciar una línea de tiempo. Estos pasos reducen la carga cognitiva sin realizar un diagnóstico arriesgado de forma automática.
La correlación debe preservar la evidencia. Si una plataforma agrupa los síntomas de manera demasiado agresiva, puede ocultar incidentes concurrentes. Vincula la automatización a la IT operations ownership y conserva las señales crudas que los respondedores puedan necesitar.
Elige acciones según el riesgo
Las consultas de solo lectura, las instantáneas y los cambios de tráfico reversibles son generalmente más fáciles de automatizar que la eliminación de datos, la rotación de credenciales amplias o la modificación de un esquema de producción. Define precondiciones, un tiempo de ejecución, postcondiciones y un retroceso para cada acción.
Utiliza identidades de servicio con el principio de menor privilegio y separa la autorización del motor del flujo de trabajo. Los pasos de alto impacto deben requerir un aprobador identificado. Si AIOps propone una causa o solución, los respondedores aún necesitan evidencia de respaldo y una forma segura de rechazarla.
Construye runbooks confiables
Un runbook debe declarar entradas, dependencias, propietario, alcance, comportamiento ante fallas y la evidencia generada. Pruébalo en entornos de pruebas y durante jornadas de simulación. Los pasos idempotentes son valiosos porque volver a ejecutarlos no genera daño adicional.
Versiona y revisa la automatización como cualquier otro software. Supervisa la expiración de credenciales, cambios en APIs, límites de velocidad, ejecuciones parciales y acoplamientos ocultos entre servicios. Los procedimientos manuales siguen siendo necesarios cuando la propia plataforma de automatización no está disponible.
Aprende después de la recuperación
La automatización debe conservar un registro con marca de tiempo de las señales, decisiones, acciones, aprobaciones y resultados. Una revisión sin culpabilizar puede entonces separar las condiciones del sistema que contribuyeron del desencadenante final y convertir las lecciones en mejoras probadas.
Las métricas útiles incluyen el tiempo medio para reconocer y restaurar, el porcentaje de pasos seguros automatizados, la tasa de acciones fallidas, los incidentes repetidos y el impacto en el cliente. Conecta los hallazgos a la planificación DevOps en lugar de optimizar por el número de tickets cerrados.
Tipos de automatización de incidentes
La automatización de eventos normaliza y enriquece las señales entrantes. La automatización de coordinación crea un registro de incidente, notifica a los propietarios, abre canales de comunicación y publica actualizaciones de estado. La automatización diagnóstica ejecuta consultas de solo lectura o captura instantáneas. La automatización de remediación cambia el estado del sistema, mientras que la automatización de recuperación verifica la salud del servicio y cierra mitigaciones temporales.
Estas categorías no deben compartir un nivel de confianza predeterminado. El enriquecimiento a menudo puede ejecutarse automáticamente; una conmutación por error en producción puede requerir verificaciones de confianza y un aprobador; la restauración de datos generalmente necesita un comandante de incidente y el propietario de la aplicación. El control debe basarse en el impacto potencial, no en si el paso se implementa mediante una regla o un modelo de aprendizaje automático.
Los incidentes de seguridad añaden requisitos de preservación de evidencia. La automatización debe evitar modificar un host comprometido antes de capturar los datos volátiles, exponer indicadores sensibles en canales públicos o aislar infraestructura compartida sin comprender el radio de impacto. Los runbooks operacionales y forenses pueden superponerse, pero su orden puede diferir.
Diseño del flujo de trabajo y plano de control
Modela el runbook como estados explícitos con precondiciones y resultados terminales. Cada acción debe informar si se inició, tuvo éxito, falló, expiró o se omitió, junto con un identificador de ejecución inmutable. Un orquestador central puede coordinar los pasos, pero los servicios descendentes deben aplicar su propia autorización y validar las entradas de forma independiente.
Utiliza credenciales limitadas y de corta duración y restringe las rutas de red desde el motor de automatización. Separa los runners de desarrollo, pruebas y producción. Los secretos no deben aparecer en transcripciones de chat ni en registros. Para acciones de alto impacto, requiere la aprobación de dos personas o un rol de emergencia cuyo uso genere una pista de revisión inmediata.
Diseña para fallos parciales. Un ticket puede crearse mientras falla la notificación; un cambio de tráfico puede tener éxito en una región y expirar en otra. Las acciones compensatorias, los trabajos de reconciliación y la claridad en la propiedad evitan que el flujo de trabajo informe éxito solo porque el proceso de orquestación finalizó.
Ejemplos, pruebas y madurez
Un caso de uso maduro inicial es el agotamiento de conexiones a bases de datos: recopilar métricas del pool, implementaciones recientes, consultas lentas e información del propietario; abrir un incidente; proponer una acción de escalado o tráfico reversible; requerir aprobación; y luego verificar la tasa de errores y la latencia. El mismo patrón puede servir para vencimiento de certificados, presión de disco, trabajos fallidos o actividad sospechosa de cuentas.
Prueba los runbooks mediante pruebas unitarias, APIs simuladas, incidentes en entornos de pruebas, jornadas de simulación y ejercicios controlados en producción. Inyecta datos obsoletos, denegaciones de permisos, dependencias lentas, eventos duplicados e incidentes conflictivos. Confirma que los reintentos son seguros y que los respondedores pueden tomar el control manual sin luchar contra la automatización.
La madurez progresa desde la notificación, al enriquecimiento, a acciones guiadas y a la remediación automática limitada. El avance debe depender de la evidencia: diagnóstico estable, bajas tasas de acciones fallidas, retroceso verificado y beneficio claro para el usuario. El cierre autónomo debe ser raro hasta que el sistema pueda demostrar la recuperación y conservar suficiente evidencia para el aprendizaje posterior.
Ejemplo práctico: automatizando un incidente de servicio en producción
Considera una API de pagos cuyo índice de errores aumenta después de una implementación. El monitoreo genera una alerta estructurada que contiene servicio, entorno, región, versión, presupuesto de errores y enlace al runbook. La automatización la enriquece con el registro de cambios, la salud de las dependencias, registros recientes y la propiedad, y luego agrupa alertas duplicadas en un solo incidente. Una política determinista puede pausar inmediatamente el despliegue adicional; una reversión debe requerir evidencia de que la nueva versión es la causa y de que la reversión es segura.
El flujo de trabajo asigna un comandante de incidente, abre canales de comunicación, registra una línea de tiempo y sugiere pasos diagnósticos. La remediación automatizada comienza con acciones reversibles de bajo riesgo, como redirigir el tráfico a una instancia saludable. Cada acción necesita autorización, límites de concurrencia, un tiempo de espera, postcondiciones verificadas y retroceso. Los resúmenes generativos pueden ayudar a los respondedores, pero la telemetría y los comandos de origen permanecen visibles para que el equipo pueda cuestionar una narrativa incorrecta.
Mide el tiempo para detectar, reconocer, mitigar y recuperarse; el volumen de alertas; la supresión de duplicados; el éxito de la remediación; la recurrencia; y los daños causados por la automatización. Realiza jornadas de simulación para credenciales expiradas, regiones parciales, alertas engañosas y reversiones fallidas. Después de la recuperación, conserva la línea de tiempo factual, identifica las condiciones técnicas y organizativas que contribuyeron, actualiza los runbooks y pruebas, y sigue el trabajo correctivo hasta su finalización en lugar de considerar una mitigación rápida como el fin del trabajo de fiabilidad.
Lista de verificación para implementación práctica
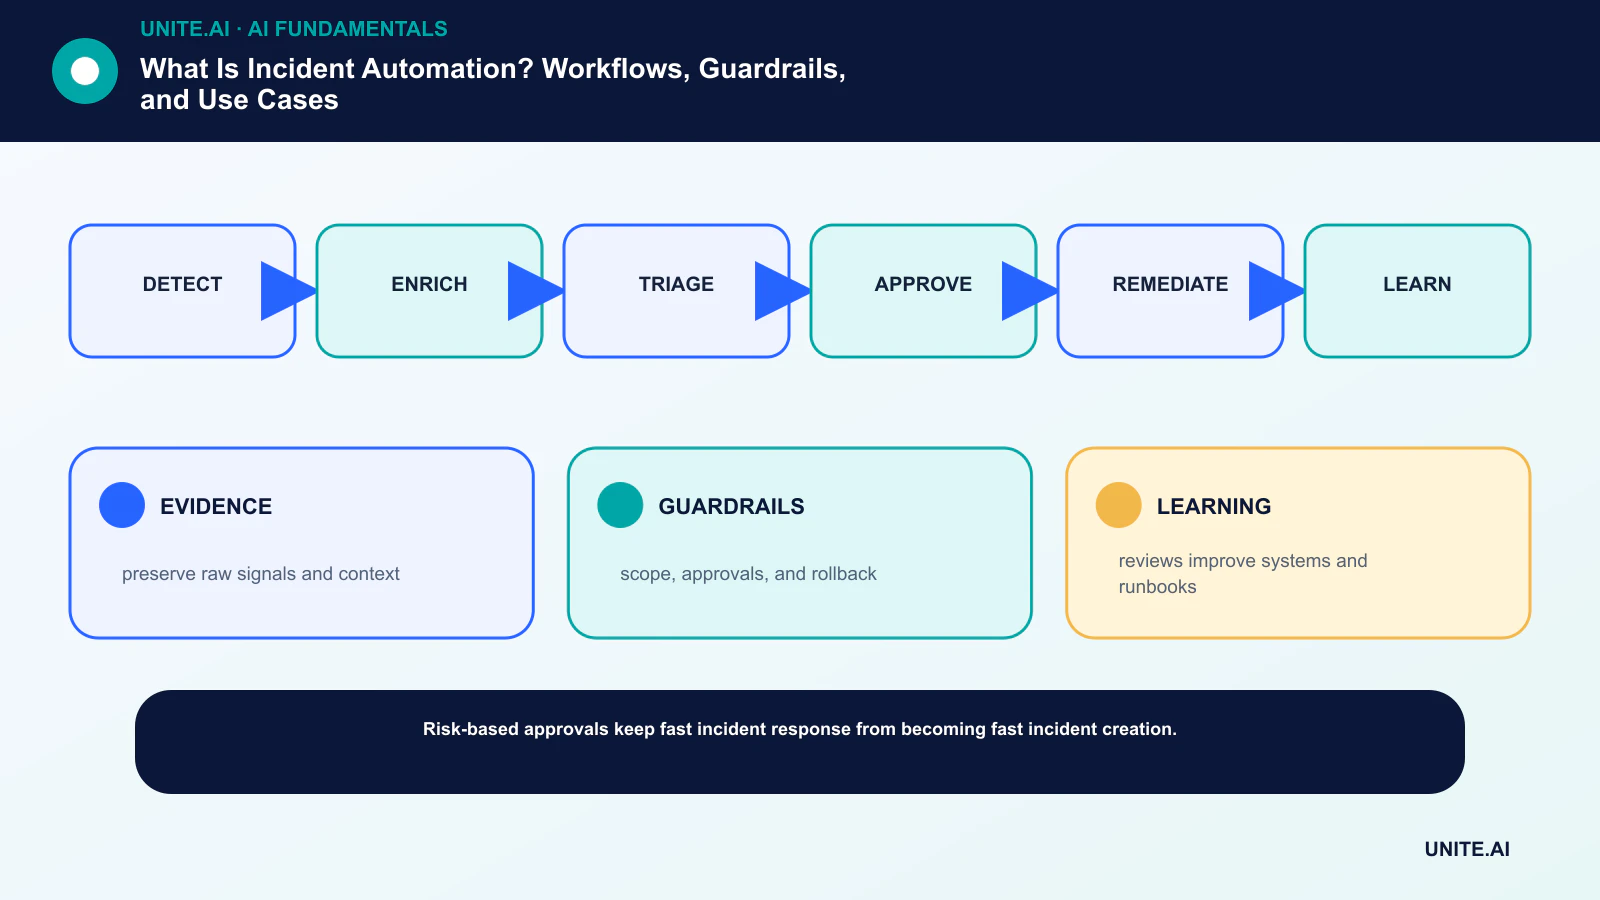
Convierte el concepto en un flujo de trabajo limitado y comprobable: detectar → enriquecer → clasificar → aprobar → remediar → aprender. Nombra a un propietario responsable, documenta los datos y dependencias, establece una línea base simple, define criterios de aceptación y de detención, prueba fallas representativas y define monitoreo, retroceso y revisión antes de ampliar el alcance. Registra versiones y suposiciones para que otro equipo pueda reproducir el resultado y comprender qué cambió.
Antes del lanzamiento, realiza una revisión de preparación documentada con las personas que construyen, operan, aseguran y se ven afectadas por el sistema. Prueba casos normales, condiciones límite, fallas de dependencias y usos indebidos; conserva la evidencia y los riesgos no resueltos. Define quién puede aprobar la liberación, cambiar un umbral, sobrescribir una salida o detener la operación. Revisa la decisión cuando lleguen datos del mundo real, porque un piloto técnicamente exitoso no garantiza un rendimiento fiable a mayor escala.
- EVIDENCIA: conserva señales crudas y contexto.
- SALVAGUARDAS: alcance, aprobaciones y retroceso.
- APRENDIZAJE: las revisiones mejoran los sistemas y los runbooks.
Preguntas frecuentes
¿La automatización de incidentes es lo mismo que AIOps?
No. AIOps aplica análisis o aprendizaje automático a los datos operacionales. La automatización de incidentes es la capa más amplia de ejecución y coordinación; puede usar reglas simples, resultados de AIOps o ambos.
¿Qué debería automatizarse primero?
Comienza con pasos de alta frecuencia, bajo riesgo y bien comprendidos, como el enriquecimiento, la búsqueda del propietario, la captura de evidencia, las actualizaciones de estado y los diagnósticos reversibles.
Referencias principales