
Fundamentos de la IA
¿Qué es la Ingeniería de Plataformas? Plataformas, Experiencia del Desarrollador y Barreras de Seguridad

 Añade Unite.AI a tus fuentes preferidas en Google
La ingeniería de plataformas es la práctica de crear y operar capacidades internas compartidas que ayudan a los equipos de software a entregar y ejecutar aplicaciones mediante flujos de trabajo de autoservicio soportados. La plataforma se trata como un producto cuyos usuarios son desarrolladores y otros equipos técnicos.
Una plataforma no es automáticamente un portal, un clúster de Kubernetes o una colección de scripts. Resulta útil cuando reduce la carga cognitiva y el tiempo de entrega, al tiempo que mejora la fiabilidad, la seguridad, la observabilidad y la consistencia organizacional.
Conclusiones clave
- Comience con la investigación de los desarrolladores y la fricción recurrente, no con una pila de herramientas predeterminada.
- Ofrezca caminos dorados opcionales y soportados con rutas de escape claras para excepciones legítimas.
- Expona capacidades mediante APIs, plantillas, automatización y documentación; un portal es solo una interfaz.
- Mida los resultados de los usuarios y la adopción del producto junto con la entrega, la fiabilidad, la seguridad y el costo.
Plataforma como producto interno
Un equipo de plataforma identifica a los usuarios internos, sus recorridos, puntos de dolor y resultados deseados. Mantiene una hoja de ruta, niveles de servicio, documentación, soporte y bucles de retroalimentación como cualquier equipo de producto. La adopción se gana por la utilidad, no por imponerla al nombrar a un equipo central.
Esto amplía la cooperación DevOps. Los equipos de aplicación conservan la propiedad de sus servicios mientras la plataforma brinda capacidades reutilizables y políticas.
Capacidades, portales y caminos dorados
Las capacidades pueden abarcar repositorios, entornos, CI/CD, secretos, identidad, infraestructura, observabilidad, catálogos de servicios, costos e integración de incidentes. Un portal de desarrolladores puede exponerlas, pero la orquestación y los servicios operativos hacen que la plataforma sea real.
Un camino dorado es una forma bien soportada de realizar una tarea común. Debe codificar valores predeterminados seguros y mantenerse transparente. Los equipos necesitan una ruta de excepción gobernada cuando los requisitos difieren.
Arquitectura y barreras de seguridad
Utilice interfaces estables y APIs declarativas para que la plataforma pueda evolucionar detrás de ellas. Separe el plano de control de las cargas de trabajo, delimite las credenciales, preserve los metadatos de propiedad y haga que los cambios generados sean revisables y reversibles.
Integre las verificaciones, políticas y procedencia de artefactos de DevSecOps en los flujos de trabajo. Las barreras de seguridad deben ofrecer retroalimentación rápida y remediación accionable en lugar de denegaciones sin explicación.
Medir y evolucionar
Mida el tiempo hasta la primera implementación, el tiempo de entrega, la recuperación de cambios fallidos, la disponibilidad de la plataforma, la carga de soporte, la adopción, la satisfacción, la postura de seguridad y el costo. Evite contar los inicios de sesión en el portal como un proxy de mejora en la entrega.
Instrumente la plataforma mediante prácticas de operaciones de TI y entreviste a los usuarios regularmente. Elimine rutas no utilizadas, estandarice donde la repetición es costosa y permita la diversidad donde genere valor de producto.
Plataformas internas de desarrollo y caminos dorados
Una plataforma interna de desarrollo es un producto que expone infraestructura y capacidades operativas aprobadas a través de interfaces de autoservicio. Puede combinar un portal, un catálogo de servicios, plantillas, APIs, herramientas de línea de comandos, flujos de trabajo de despliegue, secretos, entornos y observabilidad. La plataforma no reemplaza a la nube o a Kubernetes; las organiza en capacidades utilizables.
Un camino dorado es una forma opinada y soportada de completar una tarea común, como crear un servicio con un repositorio, una canalización CI, un tiempo de ejecución, paneles, alertas y metadatos de propiedad. Debe ser la opción más fácil y segura, permitiendo excepciones justificadas. Una ruta obligatoria que no pueda soportar cargas de trabajo reales se convierte en un cuello de botella o es eludida.
Los equipos de plataforma deben tratar a los desarrolladores como clientes y a las capacidades como productos. Las entrevistas de descubrimiento, analíticas de uso, datos de soporte, hojas de ruta, documentación y objetivos de nivel de servicio son tan importantes como la automatización. La adopción es evidencia de utilidad, pero la adopción por sí sola no prueba que la entrega, la fiabilidad, la seguridad o la experiencia del desarrollador hayan mejorado.
Planos de control, interfaces y modelo operativo
El plano de control de la plataforma concilia la intención declarada por un desarrollador con los recursos subyacentes. Una definición de servicio podría solicitar un tiempo de ejecución, base de datos, región y nivel de fiabilidad; los controladores traducen eso en configuraciones de nube, red, política y observabilidad. Las abstracciones estables deben ocultar la complejidad incidental sin esconder el estado operativo necesario para la depuración.
Las interfaces pueden incluir portales web, APIs, configuraciones basadas en Git, CLIs y componentes reutilizables de canalizaciones. La mejor interfaz depende de la frecuencia de la tarea y del flujo de trabajo del usuario. Cada interfaz necesita autenticación, autorización, validación, historial de auditoría, explicaciones de errores y versionado. El autoservicio sin gestión del ciclo de vida produce recursos abandonados y proliferación de configuraciones.
Un equipo de plataforma posee capacidades compartidas y caminos pavimentados, mientras que los equipos de aplicación conservan la responsabilidad del comportamiento del software y de los resultados del negocio. Los equipos de seguridad, fiabilidad, finanzas e infraestructura aportan políticas y servicios. Los límites de responsabilidad explícitos evitan que la plataforma se convierta en una cola de tickets sin rendición de cuentas o en un intento de centralizar cada decisión de ingeniería.
Medir el valor y evitar el fracaso de la plataforma
Mida el tiempo de entrega hasta la primera implementación en producción, el tiempo de aprovisionamiento de entornos, la frecuencia de despliegues, la tasa de fallos de cambios, el tiempo de recuperación, la carga cognitiva, el volumen de soporte, la fiabilidad y la adopción de controles de seguridad. Segmente los resultados por equipo y carga de trabajo. Un lanzamiento de plantilla más rápido tiene valor limitado si los cambios posteriores siguen siendo lentos o los incidentes se vuelven más difíciles de diagnosticar.
Los fallos comunes incluyen construir antes de comprender a los usuarios, copiar la pila de una gran empresa, exponer infraestructura cruda detrás de un portal, forzar una estandarización prematura y optimizar para la producción del equipo de plataforma. Comience con un recorrido recurrente doloroso, mapee sus pasos y esperas, entregue una ruta delgada de extremo a extremo y itere usando los resultados observados.
Las plataformas deben evolucionar sin desestabilizar cada servicio. Use contratos versionados, ventanas de desactivación, migraciones automatizadas, pruebas de compatibilidad y una propiedad clara. Rastree las dependencias de la plataforma para que una interrupción del plano de control no bloquee todos los despliegues ni dañe las cargas de trabajo en ejecución. Documente los procedimientos de emergencia y pruebe regularmente la recuperación ante fallos de la plataforma.
Ejemplo práctico: una ruta de autoservicio para una nueva API
Un desarrollador selecciona una plantilla de API aprobada y proporciona el nombre del servicio, propietario, clasificación de datos, lenguaje y nivel de fiabilidad. La plataforma crea un repositorio, una política de dependencias, una canalización CI, un entorno de pruebas, una configuración de despliegue, una entrada en el catálogo de servicios, paneles, alertas y un manual de operaciones inicial. La política valida nombres, regiones, permisos y exposición de red antes del aprovisionamiento, mientras los artefactos generados permanecen inspeccionables y son propiedad del equipo.
La plataforma expone operaciones de ciclo de vida — crear entorno, desplegar, escalar, rotar un secreto, ver registros, revertir y retirar — mediante APIs estables y un portal. Las cargas de trabajo en ejecución continúan si el portal no está disponible. Las excepciones utilizan un punto de extensión documentado y una expiración en lugar de un cambio manual no rastreado. Las plantillas versionadas y las migraciones automatizadas evitan que las mejoras de la plataforma rompan silenciosamente los servicios existentes.
Mida el tiempo desde la creación del repositorio hasta una implementación en producción saludable, el esfuerzo del desarrollador, la demanda de soporte, los fallos de cambios, la recuperación, el cumplimiento de políticas y la adopción por tipo de carga de trabajo. Entrevista a los usuarios que abandonan la ruta e inspecciona dónde esperan o escapan de la abstracción. El equipo de plataforma debe priorizar la fricción recurrente más grande, publicar la fiabilidad y la hoja de ruta, y retirar capacidades no utilizadas. Un catálogo pulido no es una plataforma si los equipos aún necesitan tickets para cada operación significativa.
La adopción debe ser escalonada. Comience con equipos voluntarios y una clase de carga de trabajo, demuestre las operaciones posteriores al día uno, luego migre con herramientas y soporte. Publique los objetivos de servicio de la plataforma y el estado de dependencias, y diseñe una ruta de emergencia que sea controlada pero utilizable durante interrupciones. El cobro interno o la visualización de costos pueden exponer el gasto de recursos, pero los equipos de producto también necesitan valores predeterminados sensatos para que la gobernanza financiera no se convierta en otra cola de aprobaciones manuales.
Lista de verificación de implementación práctica
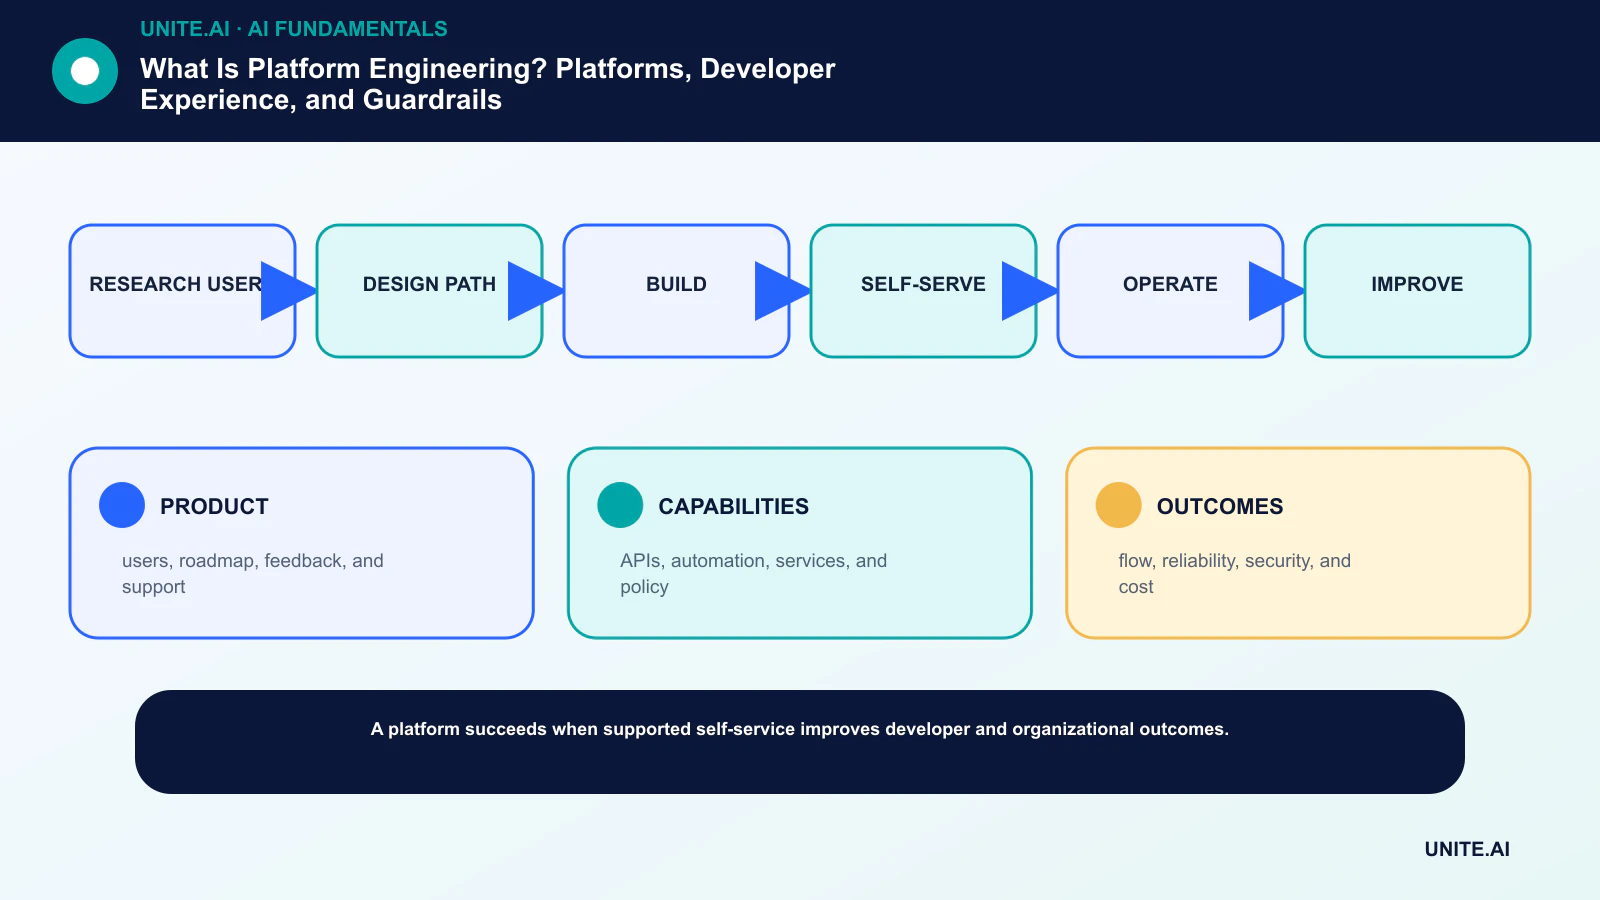
Convierta el concepto en un flujo de trabajo delimitado y verificable: investigar usuarios → diseñar la ruta → construir → autoservicio → operar → mejorar. Asigne un propietario responsable, documente los datos y dependencias, establezca una línea base simple, defina criterios de aceptación y de finalización, pruebe fallos representativos y defina monitoreo, reversión y revisión antes de ampliar el alcance. Registre versiones y suposiciones para que otro equipo pueda reproducir el resultado y comprender qué cambió.
Antes del lanzamiento, realice una revisión de preparación documentada con las personas que construyen, operan, aseguran y se ven afectadas por el sistema. Pruebe casos normales, condiciones límite, fallos de dependencias y usos indebidos; preserve la evidencia y los riesgos no resueltos. Defina quién puede aprobar la versión, cambiar un umbral, anular una salida o detener la operación. Revise la decisión cuando lleguen datos del mundo real, porque un piloto técnicamente exitoso no garantiza un rendimiento fiable a mayor escala.
- PRODUCTO: usuarios, hoja de ruta, retroalimentación y soporte.
- CAPACIDADES: APIs, automatización, servicios y políticas.
- RESULTADOS: flujo, fiabilidad, seguridad y costo.
Preguntas frecuentes
¿La ingeniería de plataformas está reemplazando a DevOps?
No. La ingeniería de plataformas es una forma de escalar los principios de DevOps al proporcionar productos compartidos y capacidades de autoservicio. La colaboración y la propiedad del servicio siguen siendo esenciales.
¿Un portal interno de desarrolladores es la plataforma?
Generalmente no. Un portal es una interfaz. La plataforma también incluye APIs, automatización, infraestructura, políticas, servicios, documentación, soporte y propiedad operativa.
Referencias principales











