
Fundamentos de la IA
¿Qué es la gestión del rendimiento de activos (APM)?

 Añade Unite.AI a tus fuentes preferidas en Google
La gestión del rendimiento de activos (APM) combina la estrategia de activos, el mantenimiento, la monitorización de condición, el análisis de confiabilidad y los datos operacionales para mejorar el valor que aportan los activos físicos. Se utiliza habitualmente para equipos como turbinas, bombas, vehículos, líneas de producción e infraestructuras.
El APM no es un panel de sensores ni un modelo de mantenimiento predictivo por sí mismo. Es un proceso de decisión que equilibra el rendimiento, el costo, el riesgo, la seguridad y la sostenibilidad a lo largo del ciclo de vida del activo, con una clara responsabilidad sobre inspecciones, trabajos, repuestos y planificación de capital.
Conclusiones clave
- Comience con la criticidad y las consecuencias de fallas, no con el sensor más fácil de recopilar.
- Combine los datos de condición con el historial de mantenimiento, el contexto operativo y el conocimiento de ingeniería.
- Utilice señales predictivas para respaldar una decisión de trabajo definida y un requisito de tiempo de anticipación.
- Mida el riesgo evitado, la disponibilidad, la calidad del mantenimiento, el costo del ciclo de vida y las falsas alarmas.
De la estrategia de activos al trabajo
Las organizaciones definen objetivos, jerarquías de activos, criticidad, estándares de rendimiento, modos de falla y estrategias de mantenimiento. Un sistema de gestión del trabajo programa inspecciones y reparaciones; los análisis de APM ayudan a priorizar cuándo y por qué debe realizarse el trabajo.
La misma condición puede implicar acciones diferentes para una bomba de bajo costo y redundante y una turbina crítica para la seguridad. El APM conecta la evidencia técnica con el contexto empresarial y de seguridad en lugar de optimizar una única puntuación de predicción.
Datos y representaciones digitales
Las fuentes útiles incluyen series temporales de sensores, alarmas, rondas de operadores, notas de mantenimiento, repuestos, entorno, cargas y límites de diseño. Los identificadores de activos y las marcas de tiempo deben alinearse antes del análisis. Los sensores ausentes, que presentan deriva o que son reemplazados pueden generar tendencias falsas.
Un gemelo digital puede combinar modelos de ingeniería y estado en tiempo real, pero necesita supuestos validados y reglas de actualización. Las notas de técnicos no estructuradas pueden aportar contexto que la telemetría no tiene.
Condición, predicción y decisión
Los umbrales detectan límites conocidos; los modelos de anomalía señalan desviaciones; los modelos diagnósticos estiman causas; los modelos pronósticos estiman la vida útil restante. Cada uno requiere un horizonte temporal y una incertidumbre adecuados a la decisión de mantenimiento.
Un modelo que predice una falla cinco minutos antes de que ocurra puede ser preciso pero operativamente inútil si los repuestos requieren una semana. El aprendizaje automático debe compararse con reglas y métodos de confiabilidad y probarse en diferentes regímenes operativos.
Implementación y medición
Comience con una clase de activo crítico, un modo de falla creíble, un tiempo de anticipación disponible y un responsable que pueda actuar. Integre las recomendaciones en la planificación, órdenes de trabajo e inventario; recopile el resultado para que la regla o modelo pueda revisarse.
Monitoree la disponibilidad, el tiempo de inactividad no planificado, el costo de mantenimiento, el cumplimiento del programa, las falsas alarmas, los eventos perdidos, la exposición a la seguridad y el valor del ciclo de vida. Evite afirmar fallas evitadas sin un método contrafactual y supuestos documentados.
Jerarquía de activos, comportamiento de fallas y criticidad
Un programa de APM comienza con una jerarquía de activos que conecta sitios, sistemas, equipos, ensamblajes y componentes mantenibles. Cada nivel necesita identificadores consistentes, propiedad, ubicación, especificaciones y relaciones. Sin esa base, los flujos de sensores, órdenes de trabajo, hallazgos de inspección y registros de costos no pueden describir de manera fiable el mismo activo físico.
Los modos de falla explican cómo un activo puede dejar de cumplir su función requerida, por qué ocurre la falla, qué evidencia aparece primero y qué consecuencia sigue. El análisis de modos y efectos de falla, el mantenimiento centrado en la confiabilidad y el análisis de causa raíz convierten el mantenimiento de una actividad calendarizada a una disciplina informada por el riesgo. El análisis debe distinguir los síntomas de los mecanismos causales.
La criticidad combina la probabilidad con las consecuencias para la seguridad, el medio ambiente, la producción, la calidad, el cumplimiento y el costo. Una bomba redundante que sirve a un circuito no esencial no debe recibir el mismo presupuesto de monitorización que un compresor de punto único de falla. La criticidad cambia con el contexto operativo, por lo que los equipos deben revisar las clasificaciones después de cambios en procesos, activos o demandas.
Monitorización de condición, predicción y decisiones de mantenimiento
La monitorización de condición puede utilizar vibración, temperatura, presión, corriente, emisión acústica, análisis de lubricante, inspección visual y observaciones del operador. La frecuencia de muestreo debe coincidir con la física de la falla. La vibración de rodamientos de alta frecuencia y la corrosión de deriva lenta requieren sensores, almacenamiento, características y lógica de alerta diferentes. La calibración y la calidad de la instalación forman parte de la calidad de los datos.
Los modelos predictivos pueden detectar anomalías, clasificar fallas conocidas, estimar indicadores de salud o predecir la vida útil restante. Una señal estadísticamente inusual no es automáticamente una falla accionable. Los modelos necesitan contexto del estado operativo, incertidumbre, evaluación del tiempo de anticipación y validación en diferentes equipos, estaciones, cargas y eventos de mantenimiento. Las falsas alarmas consumen confianza y mano de obra; las detecciones perdidas pueden generar pérdidas graves.
El resultado de los análisis debe conectarse a una decisión: inspeccionar, lubricar, reducir la carga, programar trabajo, ordenar una pieza o detener la operación. Los umbrales de decisión deben reflejar la consecuencia de la falla, el tiempo de anticipación de la intervención, la capacidad de la fuerza laboral, los repuestos y las ventanas de producción. El umbral económicamente óptimo rara vez es el que maximiza una métrica genérica del modelo.
Integración del APM, medición de valor y gobernanza
El APM conecta la tecnología operativa con sistemas empresariales como la gestión computarizada de mantenimiento, la gestión de activos empresariales, historiales, inventario y planificación. La integración debe preservar marcas de tiempo, unidades, identidad del activo, estado del trabajo y procedencia. La segmentación de redes y puertas de enlace controladas son esenciales porque la comodidad diagnóstica no debe crear una vía hacia sistemas de control críticos para la seguridad.
Mida el valor mediante el tiempo de inactividad evitado, la reducción del trabajo de emergencia, el costo de mantenimiento, la disponibilidad de repuestos, la eficiencia energética, el rendimiento, la exposición a la seguridad y la vida del activo. Las fallas evitadas son contrafactuales, por lo que se deben usar bases de referencia creíbles, activos comparables, supuestos documentados y rangos de sensibilidad. Un piloto que detecta muchas anomalías pero no modifica decisiones de mantenimiento no ha demostrado valor comercial.
La gobernanza asigna responsables para sensores, modelos, reglas de alarmas, bibliotecas de fallas y procesos de trabajo. Revise las alertas después de cada intervención, registre si el diagnóstico fue correcto y retroalimente los resultados confirmados a las reglas y modelos. Los operadores y mantenedores necesitan una forma de cuestionar las recomendaciones; el conocimiento local es evidencia, no resistencia a la automatización.
Ejemplo práctico: protección de un activo rotativo crítico
Para un compresor de producción, el equipo mapea componentes y modos de falla, clasifica las consecuencias de pérdida de producción y seguridad, y conecta etiquetas del historial, sensores de vibración, muestras de lubricante, inspecciones y órdenes de trabajo a una única identidad de activo. Los datos de referencia deben cubrir el arranque, carga estable, reducción y condiciones estacionales. De lo contrario, el modelo podría marcar transiciones operativas normales como fallas o pasar por alto degradaciones visibles solo bajo una carga específica.
Una capa analítica detecta cambios en el espectro de vibración y la temperatura del rodamiento, estima la incertidumbre y muestra la evidencia junto a eventos históricos comparables. Una alerta persistente genera una solicitud de inspección en lugar de detener automáticamente la operación. El mantenedor registra los hallazgos, la acción, la pieza reemplazada y la causa confirmada. Esos resultados determinan si el umbral, el modelo de falla o la instalación del sensor deben modificarse.
Evalúe el tiempo de anticipación de la advertencia, la tasa de detección confirmada, la carga de falsas alarmas, el tiempo de inactividad evitado, el trabajo de emergencia, la disponibilidad de repuestos y el costo de mantenimiento en relación con una referencia documentada. Incluya el costo de sensores, integración, análisis y procesos de trabajo modificados. La revisión de ciberseguridad aísla la monitorización del control, y la gobernanza asigna responsables para los datos y modelos. El objetivo es una decisión de mantenimiento más segura y económica, no la mayor recopilación posible de telemetría de activos.
Lista de verificación práctica de implementación
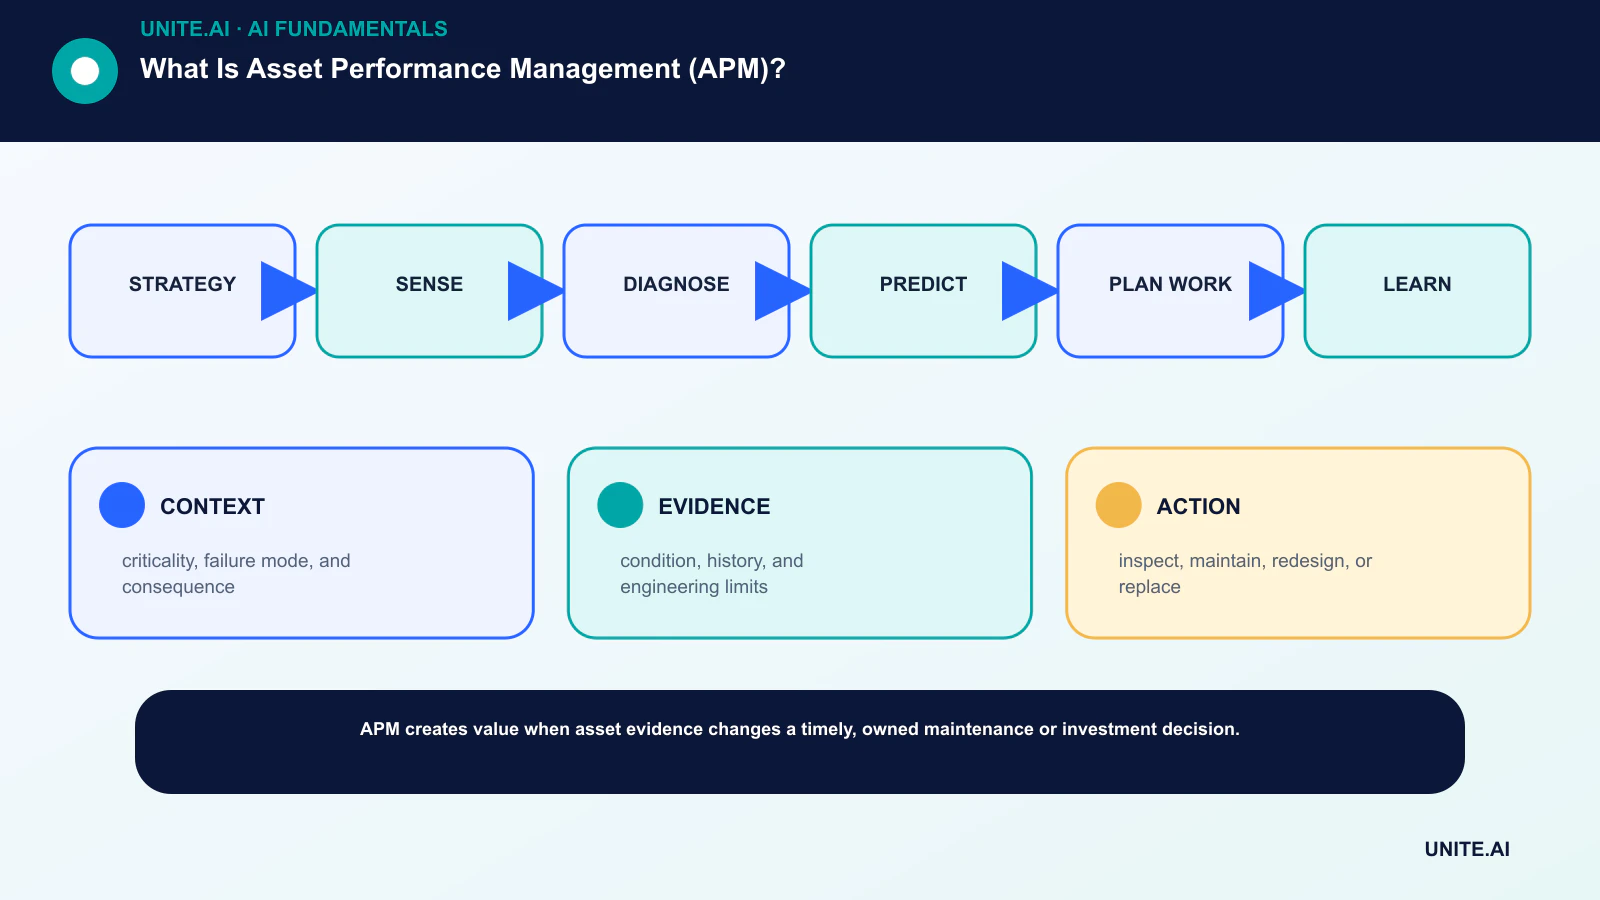
Convierta el concepto en un flujo de trabajo delimitado y comprobable: estrategia → detección → diagnóstico → predicción → planificación del trabajo → aprendizaje. Asigne un responsable, documente los datos y dependencias, establezca una referencia simple, defina criterios de aceptación y de parada, pruebe fallas representativas y defina la monitorización, reversión y revisión antes de ampliar el alcance. Registre versiones y supuestos para que otro equipo pueda reproducir el resultado y comprender qué cambió.
Antes del lanzamiento, realice una revisión de preparación documentada con las personas que construyen, operan, aseguran y se ven afectadas por el sistema. Pruebe casos normales, condiciones límite, fallas de dependencias y usos indebidos; preserve la evidencia y los riesgos no resueltos. Defina quién puede aprobar la publicación, cambiar un umbral, anular un resultado o detener la operación. Revise la decisión cuando lleguen datos reales, porque un piloto técnicamente exitoso no garantiza un rendimiento fiable a mayor escala.
- CONTEXTO: criticidad, modo de falla y consecuencia.
- EVIDENCIA: condición, historial y límites de ingeniería.
- ACCIÓN: inspeccionar, mantener, rediseñar o reemplazar.
Preguntas frecuentes
¿Cómo se diferencia el APM de un CMMS?
Un CMMS gestiona principalmente el trabajo de mantenimiento, los horarios y los registros. El APM añade estrategia de activos, análisis de confiabilidad y condición, priorización y decisiones de rendimiento; los sistemas a menudo se integran.
¿Se requiere mantenimiento predictivo para el APM?
No. Las estrategias preventivas, basadas en condición, de funcionamiento hasta falla, de rediseño y de reemplazo pueden ser todas apropiadas. La predicción es una herramienta dentro de una estrategia de activos.
Referencias principales












