
Ángulo de Anderson
GAN como renderizador de caras para CGI “tradicional”

 Añade Unite.AI a tus fuentes preferidas en Google

Puntos claveDesenredar la identidad de la expresión en el espacio latente de las GAN sigue siendo…
Ver más
- Desenredar la identidad de la expresión en el espacio latente de las GAN sigue siendo el desafío central no resuelto para la síntesis de video facial.
- Modelos CGI paramétricos como SMPL y 3DMM se utilizan cada vez más para imponer orden en los códigos latentes rebeldes de las GAN.
- El enfoque híbrido de Disney, Rendering with Style, produjo resultados inquietantes al fusionar mapas de textura tradicionales con imágenes generadas por GAN.
Opinión Cuando las Redes Adversarias Generativas (GAN) demostraron por primera vez su capacidad para reproducir caras 3D sorprendentemente realistas, el avance desencadenó una fiebre del oro para el potencial no explotado de las GAN para crear videos temporalmente consistentes con caras humanas.
En algún lugar del espacio latente de la GAN, parecía que debía haber un orden y una lógica racional ocultos – un esquema de lógica semántica incipiente, enterrado en los códigos latentes, que permitiría a una GAN generar vistas y interpretaciones múltiples consistentes (como cambios de expresión) de la misma cara – y ofrecería un método de video deepfake temporalmente convincente que superaría ampliamente a los autoencoders.
La salida de alta resolución sería trivial en comparación con los entornos de baja resolución en los que las limitaciones de la GPU obligan a DeepFaceLab y FaceSwap a operar, mientras que la “zona de intercambio” de una cara (en flujos de trabajo de autoencoders) se convertiría en la “zona de creación” de una GAN, informada por un puñado de imágenes de entrada, o incluso solo una imagen.
No habría más discrepancia entre las caras “de intercambio” y “de host”, porque la totalidad de la imagen se generaría desde cero, incluyendo el cabello, las líneas de la mandíbula y las extremidades más externas de los rasgos faciales, que a menudo resultan un desafío para los deepfakes “tradicionales” de autoencoders.
El invierno de video facial GAN
Resultó que no iba a ser tan fácil. En última instancia, el desacoplamiento de factores resultó ser el problema central y sigue siendo el desafío principal. ¿Cómo se puede mantener una identidad facial distinta y cambiar su pose o expresión sin reunir un corpus de miles de imágenes de referencia que enseñen a una red neuronal qué sucede cuando se realizan estos cambios, de la misma manera que los sistemas de autoencoders lo hacen de manera laboriosa?
En lugar de eso, el pensamiento posterior en la investigación de síntesis y actuación facial GAN fue que una identidad de entrada podría ser sometida a transformaciones genéricas, basadas en plantillas y teleológicas que no son específicas de la identidad. Un ejemplo de esto sería aplicar una expresión a una cara GAN que no estuviera presente en ninguna de las imágenes de esa persona que la GAN conoce.

A partir del artículo de 2022 Tensor-based Emotion Editing in the StyleGAN Latent Space, se aplican expresiones basadas en plantillas a una cara de entrada del conjunto de datos FFHQ. Fuente: https://arxiv.org/pdf/2205.06102.pdf
Es obvio que un enfoque “de un tamaño para todos” no puede cubrir la diversidad de expresiones faciales únicas de un individuo. Nos preguntamos si una sonrisa tan única como la de Jack Nicholson o Willem Dafoe podría recibir una interpretación fiel bajo la influencia de tales códigos latentes de “promedio de expresión”.

¿Quién es este encantador extraño latino? Aunque el método GAN produce una cara más realista y de mayor resolución, la transformación no está informada por múltiples imágenes del mundo real del actor, como es el caso con DeepFaceLab, que se entrena extensivamente en una base de datos de miles de tales imágenes, y en consecuencia, la semejanza se ve comprometida. Aquí (fondo) un modelo DeepFaceLab se importa a DeepFaceLive, una implementación de streaming del software popular y controvertido. Ejemplos de https://www.youtube.com/watch?v=9tr35y-yQRY (2022) y https://arxiv.org/pdf/2205.06102.pdf.
Se han presentado varios editores de expresiones faciales GAN en los últimos años, la mayoría de ellos tratando con identidades desconocidas, donde la fidelidad de las transformaciones es imposible de conocer para el lector casual, ya que estas no son caras familiares.

Identidades desconocidas transformadas en la oferta de 2020 Cascade-EF-GAN. Fuente: https://arxiv.org/pdf/2003.05905.pdf
Quizás el editor de caras GAN que ha recibido más interés (y citas) en los últimos tres años es InterFaceGAN, que puede realizar travesías en el espacio latente en códigos latentes relacionados con la pose (ángulo de la cámara/cara), expresión, edad, raza, género y otras cualidades esenciales.
Las capacidades de “morfo” de estilo de los años 80 de InterFaceGAN y marcos similares son principalmente una forma de ilustrar el camino hacia la transformación mientras se reprojeta una imagen a través de un código latente apropiado (como “edad”). En términos de producir metraje de video con continuidad temporal, tales esquemas hasta la fecha han calificado como “desastres impresionantes”.
Si se suma a eso la dificultad de crear cabello temporalmente coherente, y el hecho de que la técnica de exploración/manipulación de códigos latentes no tiene directrices temporales innatas para trabajar (y es difícil saber cómo inyectar tales directrices en un marco diseñado para acomodar y generar imágenes fijas, y que no tiene provisión nativa para la salida de video), podría ser lógico concluir que GAN no es Todo lo que Necesitas ™ para la síntesis de video facial.
Por lo tanto, esfuerzos posteriores han producido mejoras incrementales en el desacoplamiento de factores, mientras que otros han agregado otras convenciones en visión por computadora como una “capa de orientación”, como el uso de segmentación semántica como mecanismo de control en el artículo de finales de 2021 estudio SemanticStyleGAN: Learning Compositional Generative Priors for Controllable Image Synthesis and Editing.
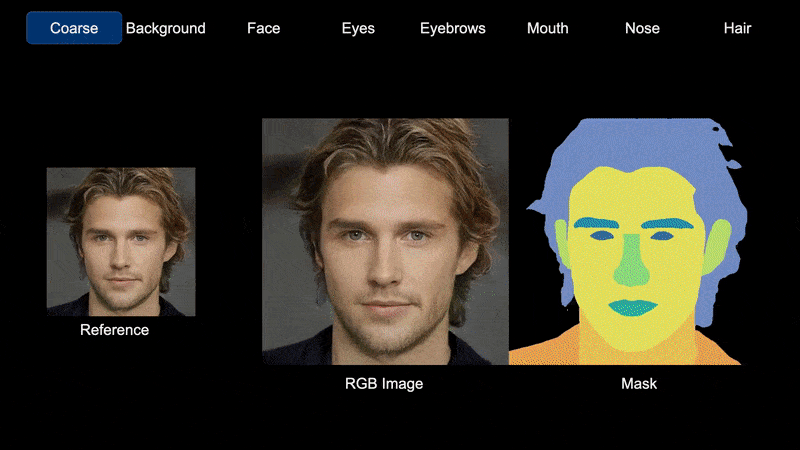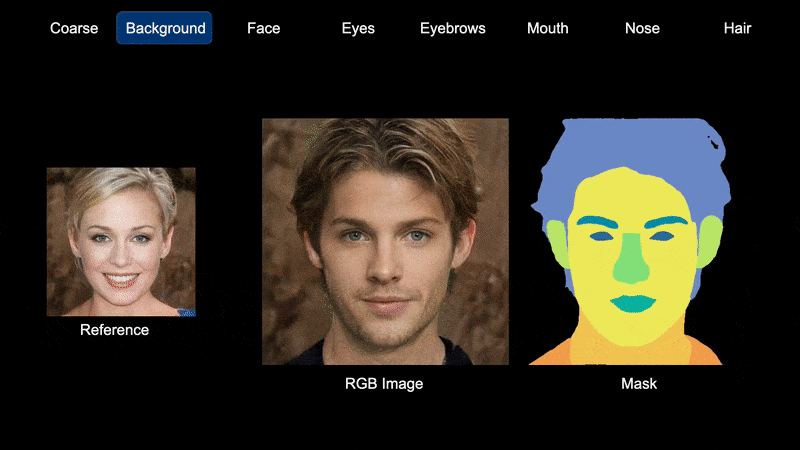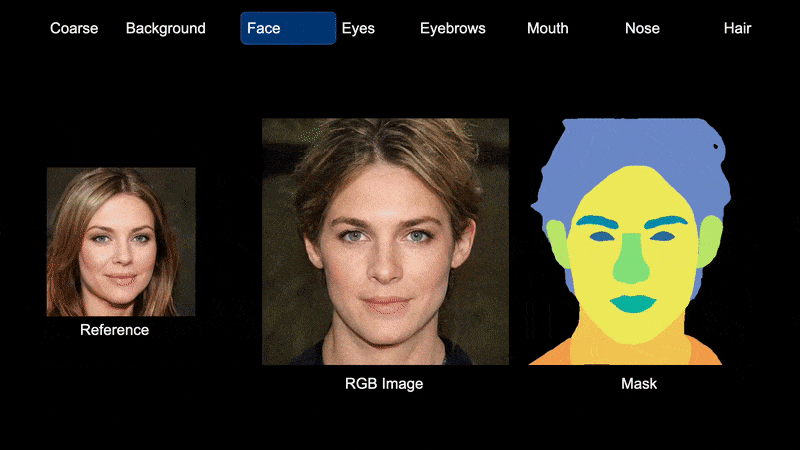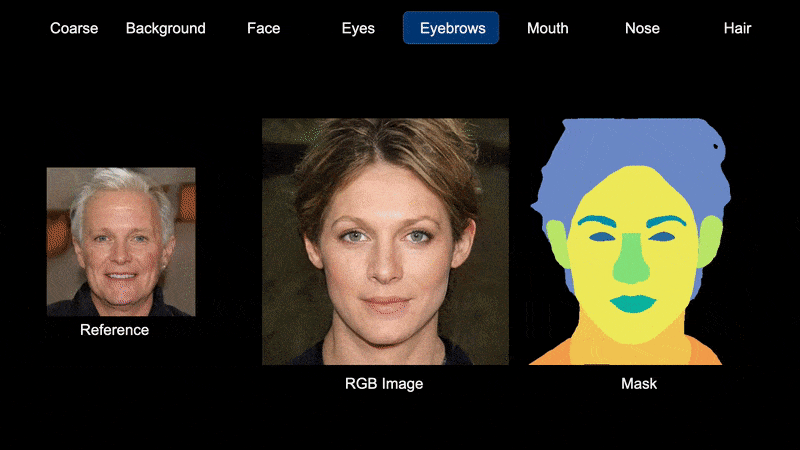
Segmentación semántica como método de control del espacio latente en SemanticStyleGAN. Fuente: https://semanticstylegan.github.io/
Orientación paramétrica
La comunidad de investigación de síntesis facial GAN se dirige cada vez más hacia el uso de caras CGI paramétricas “tradicionales” como un método para guiar y dar orden a los códigos latentes impresionantes pero indisciplinados en el espacio latente de una GAN.
Aunque los primitivos faciales paramétricos han sido un elemento básico de la investigación en visión por computadora durante más de veinte años, el interés en este enfoque ha crecido en los últimos tiempos, con el uso creciente de primitivos CGI Skinned Multi-Person Linear Model (SMPL), un enfoque pionero del Instituto Max Planck y ILM, y desde entonces mejorado con el marco Sparse Trained Articulated Human Body Regressor (STAR).

SMPL (en este caso una variante llamada SMPL-X) puede imponer una malla paramétrica CGI que se ajusta a la pose estimada (incluyendo expresiones, según sea necesario) de la totalidad del cuerpo humano representado en una imagen, lo que permite realizar nuevas operaciones en la imagen utilizando la malla paramétrica como una guía volumétrica o perceptual. Fuente: https://arxiv.org/pdf/1904.05866.pdf
El desarrollo más aclamado en esta línea ha sido la iniciativa de Disney de 2019 Rendering with Style, que fusionó el uso de mapas de textura tradicionales con imágenes generadas por GAN, en un intento de crear una salida animada mejorada y de estilo “deepfake”.

Lo antiguo se encuentra con lo nuevo en el enfoque híbrido de Disney para los deepfakes generados por GAN. Fuente: https://www.youtube.com/watch?v=TwpLqTmvqVk
El enfoque de Disney impone facetas CGI tradicionalmente renderizadas en una red StyleGAN2 para rellenar regiones de rostros humanos en “áreas problemáticas”, donde la coherencia temporal es un problema para la generación de video – áreas como la textura de la piel.

El flujo de trabajo de Rendering with Style.
Como la cabeza CGI paramétrica que guía este proceso se puede ajustar y cambiar para adaptarse al usuario, la cara generada por GAN puede reflejar esos cambios, incluyendo cambios de pose y expresión.
Aunque se diseñó para casar el control que ofrece CGI con el realismo natural de las caras GAN, al final, los resultados demuestran lo peor de ambos mundos y todavía no logran mantener la textura del cabello y la posición de las características básicas consistentes:
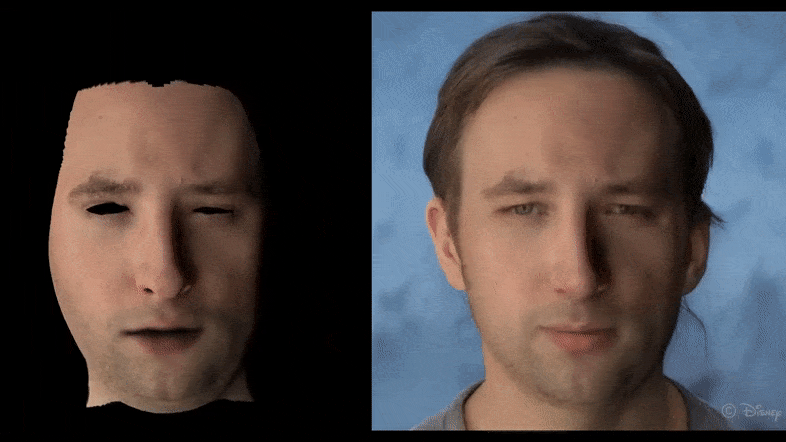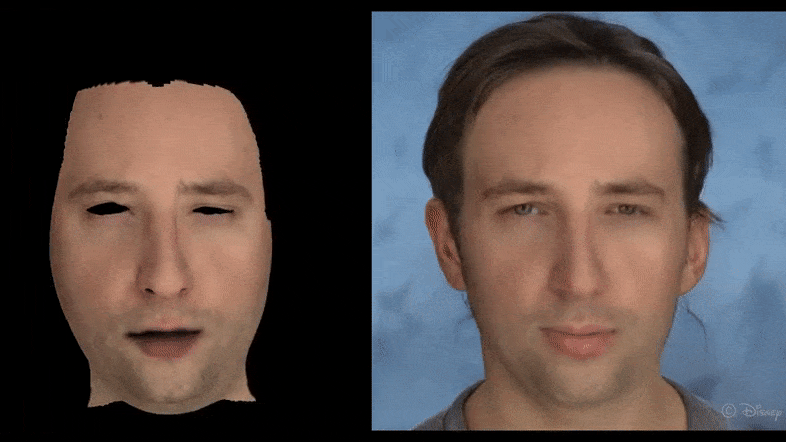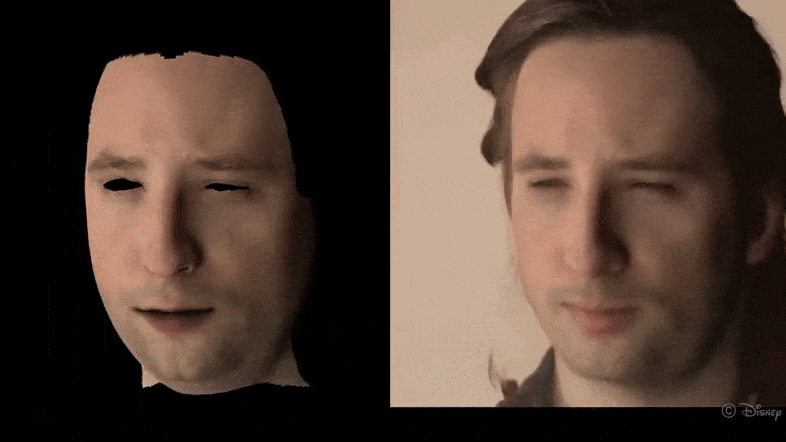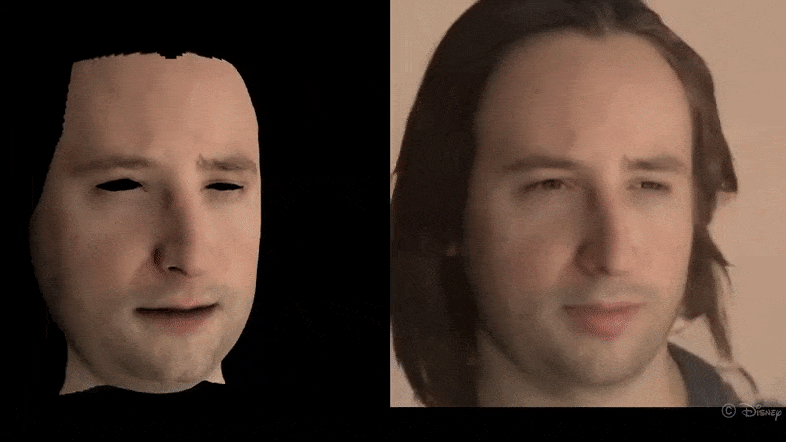
Un nuevo tipo de valle inquietante surge de Rendering with Style, aunque el principio todavía tiene algún potencial.
El artículo de 2020 estudio StyleRig: Rigging StyleGAN for 3D Control over Portrait Images sigue un enfoque cada vez más popular, con el uso de modelos de cara morfables tridimensionales (3DMM) como proxies para alterar características en un entorno StyleGAN, en este caso a través de una red de ajuste llamada RigNet:

Los 3DMM se utilizan como proxies para interpretaciones del espacio latente en StyleRig. Fuente: https://arxiv.org/pdf/2004.00121.pdf
Sin embargo, como de costumbre con estas iniciativas, los resultados hasta la fecha parecen limitados a manipulaciones mínimas de pose y cambios de expresión o estado afectivo sin orientación específica.

StyleRig mejora el nivel de control, aunque el cabello temporalmente coherente sigue siendo un desafío sin resolver. Fuente: https://www.youtube.com/watch?v=eaW_P85wQ9k
Salida similar se puede encontrar en el MOST-GAN de Mitsubishi Research, un artículo de 2021 estudio que utiliza 3DMM no lineales como una arquitectura de desentanglement, pero que también lucha por lograr un movimiento dinámico y coherente.
La investigación más reciente que intenta el control y el desacoplamiento de factores es One-Shot Face Reenactment on Megapixels, que nuevamente utiliza cabezas paramétricas 3DMM como una interfaz amigable para StyleGAN.

En el flujo de trabajo de MegaFR de One-Shot Face Reenactment, la red realiza la síntesis facial combinando una imagen real invertida a su representación latente con parámetros tomados de un modelo 3DMM renderizado. Fuente: https://arxiv.org/pdf/2205.13368.pdf
OSFR pertenece a una clase creciente de editores de caras GAN que buscan desarrollar flujos de trabajo de edición lineales al estilo Photoshop/After Effects, donde el usuario puede ingresar una imagen deseada en la que se pueden aplicar transformaciones, en lugar de buscar a través del espacio latente para códigos latentes relacionados con una identidad.
Nuevamente, las expresiones paramétricas representan un método general y no personalizado para inyectar expresiones, lo que conduce a manipulaciones que parecen “inquietantes” de una manera no siempre positiva.

Expresiones inyectadas en OSFR.
Al igual que el trabajo anterior, OSFR puede inferir poses cercanas a las originales a partir de una sola imagen y también realizar “frontalización”, donde una imagen con pose descentrada se traduce en un retrato frontal:

Imagen original (arriba) y retratos frontales inferidos de una de las implementaciones de OSFR detalladas en el nuevo artículo.
En la práctica, este tipo de inferencia es similar a algunos de los principios de fotogrametría que subyacen a Neural Radiance Fields (NeRF), excepto que la geometría aquí debe definirse por una sola foto, en lugar de las 3-4 vistas que permiten a NeRF interpretar las poses intersticiales ausentes y crear escenas neurales 3D explorables que presentan humanos.
(Sin embargo, NeRF no es Todo lo que Necesitas ™ tampoco, ya que conlleva un conjunto casi completamente diferente de obstáculos para GAN en términos de producción de síntesis de video facial)
¿Tiene GAN un lugar en la síntesis de video facial?
Lograr expresiones dinámicas y poses fuera de la distribución de entrenamiento a partir de una sola imagen de origen parece ser una obsesión alquímica en la investigación de síntesis facial GAN en este momento, principalmente porque las GAN son el único método actualmente capaz de producir caras neurales de resolución bastante alta y fidelidad relativamente elevada: aunque los marcos de deepfake de autoencoder pueden entrenarse en una multitud de poses y expresiones del mundo real, deben operar en resoluciones de entrada/salida restringidas por VRAM, y requieren un “host”; mientras que NeRF está igualmente restringido, y – a diferencia de los otros dos enfoques – actualmente no tiene metodologías establecidas para cambiar expresiones faciales y sufre de una edición limitada en general.
Parece que la única forma de avanzar para un sistema de síntesis de caras CGI/GAN preciso es que una nueva iniciativa encuentre alguna forma de ensamblar una entidad de identidad de múltiples fotos dentro del espacio latente, donde un código latente para la identidad de una persona no tenga que viajar todo el camino a través del espacio latente para explotar parámetros de pose no relacionados, sino que pueda referirse a sus propias imágenes del mundo real como referencias para transformaciones.
Incluso en tal caso, o incluso si una red StyleGAN completa se entrenara en un conjunto de caras de una sola identidad (similar a los conjuntos de entrenamiento que utilizan los autoencoders), la lógica semántica que falta probablemente aún necesitaría ser proporcionada por tecnologías auxiliares como la segmentación semántica o las caras 3DMM paramétricas, que, en tal escenario, al menos tendrían más material con el que trabajar.


