
Grundlagen der KI
Was sind Vision-Language-Modelle (VLMs)? Wie KI Bilder und Wörter miteinander verbindet
Vision-Language-Modelle verbinden visuelle Merkmale mit Sprache, sodass ein System Bilder in Worten beschreiben, vergleichen und abrufen oder mithilfe von Sprache Schlussfolgerungen über sie ziehen kann. Dieser Leitfaden erläutert den Mechanismus, die Zielkonflikte, die Evaluierung und die Kontrollen, auf die es in der Praxis ankommt.

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
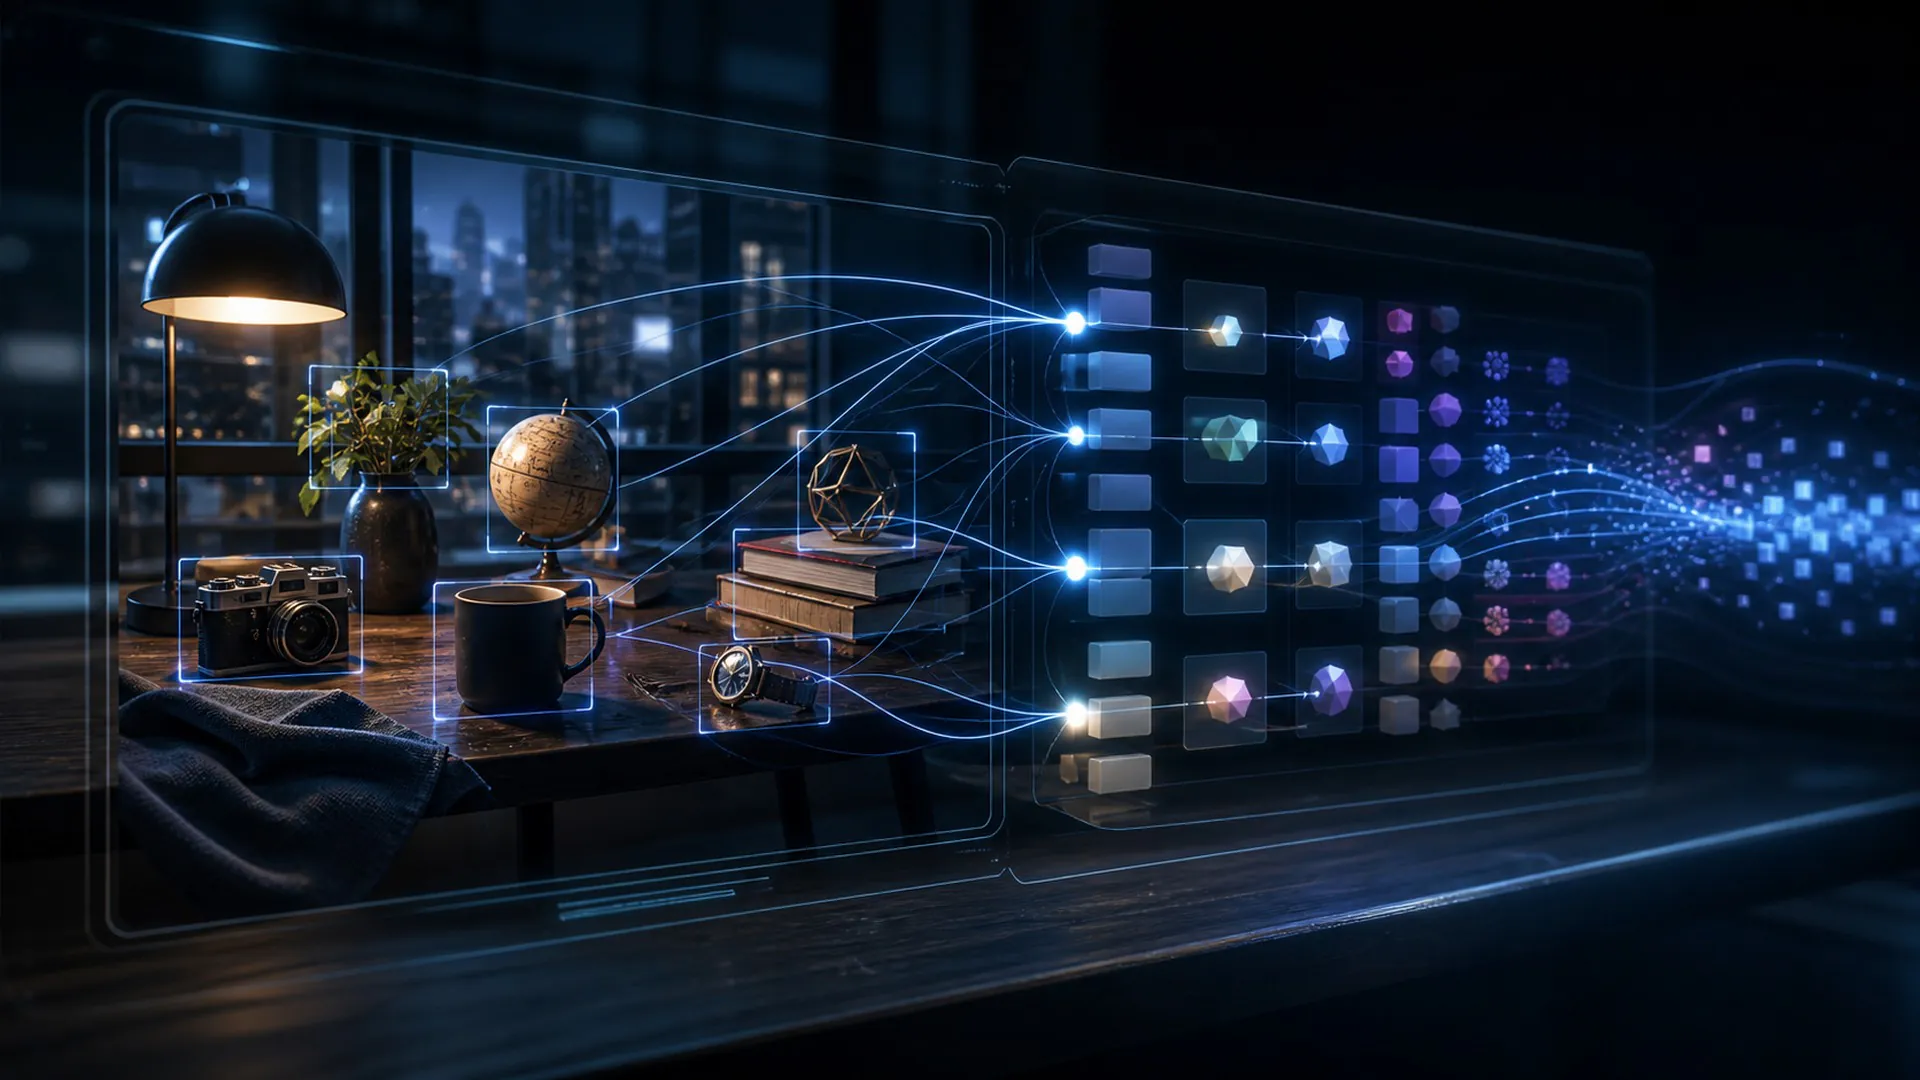
Vision-Language-Modelle verbinden visuelle Merkmale mit Sprache, sodass ein System Bilder in Worte fassen, vergleichen, abrufen oder über sie schlussfolgern kann.
Vision-Language-Modelle müssen präzise erklärt werden, denn ihre Bezeichnung steht für einen bestimmten Informationsfluss, eine bestimmte Trainingsentscheidung, einen Laufzeitmechanismus oder eine Governance-Grenze. Wer den Begriff als Synonym für „fortgeschrittene KI“ verwendet, macht Aussagen unüberprüfbar. Dieser Leitfaden führt vom Konzept, seinen Eingaben und Annahmen bis zu seinem beobachtbaren Ergebnis und prüft anschließend die naheliegendste Abgrenzung, mit der es verwechselt werden könnte.
Vision-Language-Modelle: Definition, Abgrenzung und Zweck
Vision-Language-Modelle verbinden visuelle Merkmale mit Sprache, sodass ein System Bilder in Worte fassen, vergleichen, abrufen oder über sie schlussfolgern kann. Die Definition umfasst drei praktische Voraussetzungen: eine klar bestimmbare Eingabe, eine für Vision-Language-Modelle charakteristische Transformation oder Entscheidung und ein Ergebnis, das sich anhand eines festgelegten Ziels bewerten lässt. Fehlt eines dieser Elemente, beschreibt die Bezeichnung möglicherweise eher ein angestrebtes Ziel als einen umgesetzten Mechanismus.
Multimodale Systeme müssen Signale aufeinander abstimmen, die sich in Auflösung, zeitlicher Einordnung, Rauschen und Mehrdeutigkeit unterscheiden. Ein Wort kann sich auf einen kleinen Bildbereich beziehen; ein Audiereignis kann dem Videobild vorausgehen, das es erklärt. Bei Vision-Language-Modellen ist diese Systemperspektive wichtig, weil die Leistung auch bei unverändertem Grundmodell von den umgebenden Daten, Schnittstellen, der Hardware, den Berechtigungen und den beteiligten Personen abhängen kann. Eine hilfreiche Erklärung unterscheidet daher zwischen dem erlernten Verhalten des Modells und dem Produkt, das darüber entscheidet, wann, wo und mit welcher Befugnis dieses Verhalten eingesetzt wird.
Die naheliegendste irreführende Vereinfachung ist Computervision, die ohne offene Sprachverarbeitung ein festes Label vorhersagt. Sie mag ein sichtbares Merkmal mit Vision-Language-Modellen gemeinsam haben, verändert aber die Kausalkette: Der Erfolg müsste anhand anderer Belege nachgewiesen werden, andere Ressourcen würden die Kosten maßgeblich bestimmen und andere Kontrollen wären nötig, um Schaden zu verhindern. Die Abgrenzung ist daher funktional und nicht terminologischer Art.
Eine Betriebskarte für Vision-Language-Modelle in fünf Phasen
Das Diagramm stellt eine kompakte Kausalkarte für Vision-Language-Modelle dar und behauptet nicht, dass jede Implementierung fünf Softwarekomponenten verwendet. Manche Systeme fassen Phasen zusammen, andere durchlaufen sie wiederholt in einer Schleife. Die Karte bleibt nützlich, weil sie sicherstellt, dass jeder Veränderung von Information oder Zuständigkeit eine verantwortliche Stelle sowie eine Eingabe, eine Ausgabe und ein Test zugeordnet werden.
1. Das Bild in visuelle Tokens aufteilen oder kodieren: Eingaben und Annahmen bei Vision-Language-Modellen
In dieser Phase von Vision-Language-Modellen muss das System das Bild in visuelle Tokens aufteilen oder kodieren. Entscheidend ist nicht nur, ob dieser Vorgang stattfindet, sondern auch, welche Informationen dabei verarbeitet werden, welcher Zustand sich ändert und welche Belege zeigen, dass die Änderung gültig war. Prüfende sollten den Vorgang von Computervision unterscheiden können, die ohne offene Sprachverarbeitung ein festes Label vorhersagt, und sein Ergebnis unter denselben angegebenen Bedingungen reproduzieren können.
Die Übergabe an diese Phase von Vision-Language-Modellen beginnt mit dem festgelegten Ziel und sollte mit einem Ergebnis enden, das die Kodierung des begleitenden Textes unterstützen kann. Halten Sie Unsicherheiten, verworfene Alternativen, den Ressourcenverbrauch sowie alle an dieser Schnittstelle angewandten menschlichen oder softwaregestützten Kontrollen fest. Anhand dieser Dokumentation können Teams erkennen, ob flüssig formulierte Beschreibungen Gegenstände oder Beziehungen benennen, die tatsächlich nicht zu sehen sind, bevor dieselbe Schwäche zu einem folgenreichen Ergebnis führt.
2. Den begleitenden Text kodieren: Repräsentation oder Entscheidung bei Vision-Language-Modellen
In dieser Phase von Vision-Language-Modellen muss das System den begleitenden Text kodieren. Entscheidend ist nicht nur, ob dieser Vorgang stattfindet, sondern auch, welche Informationen dabei verarbeitet werden, welcher Zustand sich ändert und welche Belege zeigen, dass die Änderung gültig war. Prüfende sollten den Vorgang von Computervision unterscheiden können, die ohne offene Sprachverarbeitung ein festes Label vorhersagt, und sein Ergebnis unter denselben angegebenen Bedingungen reproduzieren können.
Der Übergang zu dieser Phase der Bild-Sprach-Modelle beginnt damit, das Bild in visuelle Tokens zu zerlegen oder zu kodieren, und sollte mit einem Ergebnis enden, das die Verbindung beider Repräsentationen ermöglicht. Halten Sie Unsicherheiten, verworfene Alternativen, Ressourcenverbrauch und jede menschliche oder softwareseitige Kontrolle an dieser Schnittstelle fest. Anhand dieser Dokumentation können Teams erkennen, ob flüssig formulierte Beschreibungen Objekte oder Beziehungen benennen, die tatsächlich nicht sichtbar sind, bevor dieselbe Schwäche zu einer folgenreichen Ausgabe führt.
3. Beide Repräsentationen verbinden: die charakteristische Transformation in Bild-Sprach-Modellen
In dieser Phase der Bild-Sprach-Modelle muss das System beide Repräsentationen miteinander verbinden. Entscheidend ist nicht nur, ob dieser Vorgang stattfindet, sondern auch, welche Informationen er verarbeitet, welchen Zustand er verändert und welche Belege bestätigen, dass die Änderung gültig war. Eine prüfende Person sollte den Vorgang von Computervision unterscheiden können, die ohne offene Sprachgenerierung ein festes Label vorhersagt, und sein Ergebnis unter denselben angegebenen Bedingungen reproduzieren können.
Der Übergang zu dieser Phase der Bild-Sprach-Modelle beginnt damit, den begleitenden Text zu kodieren, und sollte mit einem Ergebnis enden, das es ermöglicht, Aufmerksamkeit auf Regionen und Phrasen zu richten. Halten Sie Unsicherheiten, verworfene Alternativen, Ressourcenverbrauch und jede menschliche oder softwareseitige Kontrolle an dieser Schnittstelle fest. Anhand dieser Dokumentation können Teams erkennen, ob flüssig formulierte Beschreibungen Objekte oder Beziehungen benennen, die tatsächlich nicht sichtbar sind, bevor dieselbe Schwäche zu einer folgenreichen Ausgabe führt.
4. Aufmerksamkeit auf Regionen und Phrasen richten: Begrenzungs- und Verifikationsgrenze in Bild-Sprach-Modellen
In dieser Phase der Bild-Sprach-Modelle muss das System seine Aufmerksamkeit auf Regionen und Phrasen richten. Entscheidend ist nicht nur, ob dieser Vorgang stattfindet, sondern auch, welche Informationen er verarbeitet, welchen Zustand er verändert und welche Belege bestätigen, dass die Änderung gültig war. Eine prüfende Person sollte den Vorgang von Computervision unterscheiden können, die ohne offene Sprachgenerierung ein festes Label vorhersagt, und sein Ergebnis unter denselben angegebenen Bedingungen reproduzieren können.
Der Übergang zu dieser Phase der Bild-Sprach-Modelle beginnt damit, beide Repräsentationen miteinander zu verbinden, und sollte mit einem Ergebnis enden, das die Dekodierung einer fundierten Antwort oder Handlung ermöglicht. Halten Sie Unsicherheiten, verworfene Alternativen, Ressourcenverbrauch und jede menschliche oder softwareseitige Kontrolle an dieser Schnittstelle fest. Anhand dieser Dokumentation können Teams erkennen, ob flüssig formulierte Beschreibungen Objekte oder Beziehungen benennen, die tatsächlich nicht sichtbar sind, bevor dieselbe Schwäche zu einer folgenreichen Ausgabe führt.
5. Eine fundierte Antwort oder Handlung dekodieren: Ausgabe, Feedback und Abbruchregel in Bild-Sprach-Modellen
In dieser Phase der Bild-Sprach-Modelle muss das System eine fundierte Antwort oder Handlung dekodieren. Entscheidend ist nicht nur, ob dieser Vorgang stattfindet, sondern auch, welche Informationen er verarbeitet, welchen Zustand er verändert und welche Belege bestätigen, dass die Änderung gültig war. Eine prüfende Person sollte den Vorgang von Computervision unterscheiden können, die ohne offene Sprachgenerierung ein festes Label vorhersagt, und sein Ergebnis unter denselben angegebenen Bedingungen reproduzieren können.
Der Übergang zu dieser Phase der Bild-Sprach-Modelle beginnt damit, Aufmerksamkeit auf Regionen und Phrasen zu richten, und sollte mit einem Ergebnis enden, das Überwachung oder eine abschließende Entscheidung ermöglicht. Halten Sie Unsicherheiten, verworfene Alternativen, Ressourcenverbrauch und jede menschliche oder softwareseitige Kontrolle an dieser Schnittstelle fest. Anhand dieser Dokumentation können Teams erkennen, ob flüssig formulierte Beschreibungen Objekte oder Beziehungen benennen, die tatsächlich nicht sichtbar sind, bevor dieselbe Schwäche zu einer folgenreichen Ausgabe führt.
Lesen Sie die Übersicht zu Bild-Sprach-Modellen vorwärts, um die Abläufe in der Produktion zu verstehen, und rückwärts, um Fehler zu diagnostizieren. Bei der Vorwärtsanalyse geht es darum, wie eine Phase die nächste mit Informationen versorgt. Die Rückwärtsanalyse setzt bei einem fehlerhaften, langsamen, kostspieligen oder unsicheren Ergebnis an und verfolgt zurück, welche frühere Annahme es ermöglicht hat. Oft entdeckt ein Team erst auf diesem umgekehrten Weg, dass der entscheidende Fehler auftrat, bevor das Modell überhaupt etwas ausgegeben hatte.
Ein durchgearbeitetes Beispiel für Bild-Sprach-Modelle
Ein VLM kann einen Screenshot eines Dashboards untersuchen und erklären, welches Diagramm eine schriftliche Behauptung stützt.
Dieses Beispiel ist aufschlussreich, weil sich Bild-Sprach-Modelle anhand beobachtbarer Eingaben, Zwischenzustände und Ergebnisse bewerten lassen, statt nur anhand einer ausgefeilten Demonstration. Für einen rigorosen Test würden gewöhnliche, schwierige und gezielt irreführende Fälle rund um das Szenario zusammengestellt, eine Ausgangsbasis ohne die Technik beibehalten und sowohl die durchschnittliche Leistung als auch den Schweregrad einzelner Fehler erfasst.
Ändern Sie eine Annahme im Beispiel zu Bild-Sprach-Modellen und wiederholen Sie die Analyse. Entfernen Sie eine erforderliche Eingabe, führen Sie ein widersprüchliches Signal ein, begrenzen Sie die Rechenleistung, ändern Sie die Nutzergruppe oder zwingen Sie das System, sich einer Antwort zu enthalten. Ein Mechanismus, der nur bei einer einzigen sorgfältig arrangierten Demonstration funktioniert, hat noch nicht gezeigt, dass er sich auf die Einsatzumgebung verallgemeinern lässt.
Bild-Sprach-Modelle und ihre häufigste Vereinfachung
Bild-Sprach-Modelle werden oft auf Computervision reduziert, die ohne offene Sprachgenerierung ein festes Label vorhersagt. Diese Vereinfachung beseitigt genau die Grenze, die das Konzept definiert. Sie kann dazu führen, dass Käufer ungleiche Produkte miteinander vergleichen, Forschende die Aussagekraft eines Experiments übertreiben und Betreiber nach der Einführung das falsche Signal überwachen.
| Betrachtungswinkel | Praktische Antwort |
|---|---|
| Definition | Vision-Language-Modelle verknüpfen visuelle Merkmale mit Sprache, sodass ein System Bilder mit Worten beschreiben, vergleichen, abrufen oder darüber schlussfolgern kann. |
| Verwechslung | Computer Vision, die ein festes Label vorhersagt, ohne offene Sprache zu verwenden. |
| Risiko | Flüssige Beschreibungen können Objekte oder Beziehungen benennen, die tatsächlich nicht zu sehen sind. |
Der Vergleich sollte auch die Analyseeinheit benennen. Eine wissenschaftliche Arbeit zu Vision-Language-Modellen kann ein Modell oder einen Algorithmus isoliert betrachten, während ein bereitgestellter Dienst zusätzlich Abruf, Routing, Caching, Richtlinien, Identitätsverwaltung, Benutzeroberflächen und Monitoring umfasst. Zwei Produkte können denselben Oberbegriff verwenden und dennoch unterschiedliche Teile dieses Technologie-Stacks umsetzen. Fragen Sie, welche Komponente die definierende Transformation ausführt und welche anderen Komponenten für das berichtete Ergebnis erforderlich sind.
Warum Vision-Language-Modelle in aktuellen KI-Systemen wichtig sind
Vision-Language-Modelle sind heute relevant, weil KI-Systeme größere Kontexte, mehr Modalitäten, mehr Rechenleistung zur Laufzeit, umfassenderen Werkzeugzugriff und engere Verbindungen zu organisatorischen Entscheidungen erhalten. Unter diesen Bedingungen kann ein Detail, das früher wie eine Forschungsspezialität wirkte, über Latenz, Sicherheit, Barrierefreiheit, Umweltkosten, Produktqualität oder rechtliche Rechenschaftspflicht entscheiden.
Entscheidend ist nicht, ob Vision-Language-Modelle ein einzelnes beeindruckendes Ergebnis erzielen können. Entscheidend ist vielmehr, ob die Technik unter repräsentativen Bedingungen ein relevantes Ergebnis verbessert und dabei wirksamer ist als eine einfachere Baseline. Berichten Sie Verteilungen, Fehlerkategorien, Latenzen im oberen Bereich, Ressourcenverbrauch und betroffene Untergruppen, statt alle Ergebnisse zu einem einzigen Durchschnittswert zusammenzufassen.
Bei der Evaluation sollten die einzelnen Modalitäten isoliert, widersprüchliche Eingaben getestet und die zeitliche oder räumliche Verankerung überprüft werden. Eine flüssige modalitätenübergreifende Antwort belegt nicht, dass das Modell das richtige Signal berücksichtigt hat. Wird diese Vorgehensweise gezielt auf Vision-Language-Modelle angewandt, lassen sich die Ergebnisse auf andere Kontexte übertragen: Ein anderes Team kann beurteilen, ob der behauptete Zugewinn voraussichtlich auch mit einem anderen Modell, einer anderen Sprache, einer anderen Hardwareplattform, einem anderen Datensatz, einer anderen Nutzergruppe oder einer anderen Risikotoleranz Bestand hat.
Welche Vorteile Vision-Language-Modelle bieten können
Der wichtigste Grund für den Einsatz von Vision-Language-Modellen ist, dass sie den vorgesehenen Engpass direkt angehen können. Je nach Implementierung kann sich der Nutzen in einer besseren Verankerung, einer wirklichkeitsgetreueren Repräsentation, einer verbesserten Verallgemeinerungsfähigkeit, geringerer Latenz, weniger Speicherbewegungen, klarerer Rechenschaftspflicht oder einer sichereren Abgrenzung zwischen einem Modellvorschlag und einer tatsächlichen Handlung zeigen.
Vorteile sollten anhand von Entscheidungen und Messwerten beschrieben werden. „Intelligenter“ ist kein Abnahmekriterium für Vision-Language-Modelle. Ein sinnvolles Ziel könnte die Fehlerquote bei schwierigen Fällen, die Wiederherstellung nach widersprüchlichen Hinweisen, die Kosten bei einem bestimmten Perzentil des Datenverkehrs, der Zeitaufwand für menschliche Prüfungen, die Kalibrierung oder der Anteil der Maßnahmen sein, der innerhalb einer festgelegten Befugnisgrenze bleibt.
Der Fehlermodus, der Vision-Language-Modelle kennzeichnet
Die zentrale Einschränkung besteht darin, dass flüssige Beschreibungen Objekte oder Beziehungen benennen können, die tatsächlich nicht zu sehen sind. Dieser Fehler ist kein nachträglicher Einfall, den man erst nach Abschluss der Entwicklung auflistet. Er sollte von Anfang an die Datenerhebung, die Architektur, die Berechtigungen, die Evaluation, die Freigabekriterien und das Monitoring von Vision-Language-Modellen prägen.
Eine Kontrollmaßnahme für Vision-Language-Modelle ist nur dann sinnvoll, wenn sie greift, bevor kostspielige oder irreversible Folgen eintreten. Ermitteln Sie den frühesten beobachtbaren Vorläufer des Fehlers, legen Sie einen Schwellenwert oder eine Regel fest, bestimmen Sie eine verantwortliche Person und testen Sie die Wiederherstellung. Je nach Anwendungsfall kann das bedeuten, keine Antwort zu geben, auf ein einfacheres System zurückzugreifen, weitere Nachweise anzufordern, an eine Person zu eskalieren, ein Modell zurückzusetzen oder eine Aktion vollständig abzubrechen.
Ein Evaluierungsplan für Vision-Language-Modelle
Beginnen Sie die Evaluierung von Vision-Language-Modellen damit, die Entscheidung zu formulieren, die durch die Nachweise gestützt werden soll. Definieren Sie die Einsatzpopulation, die Folgen eines falschen Ergebnisses, die zum Entscheidungszeitpunkt tatsächlich verfügbaren Informationen und die einfachste glaubwürdige Alternative. So wird verhindert, dass ein Benchmark allein deshalb zum Ziel wird, weil er sich leicht durchführen lässt.
Verwenden Sie für kontrollierte Vergleiche einen unberührten Testsatz und validieren Sie Vision-Language-Modelle anschließend in einer gestuften Betriebsumgebung. Offline-Evaluierungen machen Varianten vergleichbar; der Shadow-Modus, Canary-Tests, Ratenbegrenzungen oder Freigabeschranken zeigen, wie realer Datenverkehr, Rückkopplungsschleifen und Menschen das Verhalten verändern. Für die Bereitstellungsphase sollte eine klare Abbruchbedingung festgelegt werden, statt davon auszugehen, dass jede Verbesserung eine vollständige Einführung rechtfertigt.
Versionieren Sie die für die Reproduzierbarkeit von Vision-Language-Modellen erforderlichen Eingaben: Quelldaten, Vorverarbeitung, Tokenizer oder Encoder, Modellgewichte, Konfiguration, Prompt oder Richtlinie, Retrieval-Index, Evaluierungssatz, Hardwareannahmen und Serving-Code, sofern zutreffend. Ohne eine lückenlose Nachverfolgung der Herkunft kann ein Team nicht feststellen, ob ein verändertes Ergebnis auf die Technik, die Umgebung oder eine unbemerkte Änderung an der Pipeline zurückzuführen ist.
Fragen Sie abschließend, welcher Befund die Behauptung widerlegen würde, dass Vision-Language-Modelle hilfreich sind. Wenn kein Ergebnis die Entscheidung für eine Einführung umkehren könnte, ist die Evaluierung bloß Marketing. Vorab festgelegte Akzeptanzschwellen und ein aufbewahrter Bestätigungssatz machen die Untersuchung zu einem belastbaren Nachweis.
Fragen, die vor der Einführung von Vision-Language-Modellen zu stellen sind
- Ziel: Welchen messbaren Engpass sollen Vision-Language-Modelle beheben?
- Mechanismus: In welcher der fünf Phasen findet die entscheidende Transformation statt?
- Ausgangsbasis: Wie schneidet das System im Vergleich zu Computer Vision ab, das ohne offene Sprache ein festes Label vorhersagt, oder zu einer anderen einfacheren Alternative?
- Nachweise: Welche gewöhnlichen, schwierigen, adversarialen und Untergruppenfälle wurden getestet?
- Betrieb: Welche Kosten entstehen im großen Maßstab für Latenz, Speicher, Rechenleistung, Energie, Wartung und Überprüfung?
- Risiko: Wie wird das Team erkennen, dass flüssig formulierte Beschreibungen Objekte oder Beziehungen benennen können, die tatsächlich nicht zu sehen sind?
- Wiederherstellung: Kann das System vor einem Schaden keine Antwort geben, auf eine frühere Version zurücksetzen oder an eine Person eskalieren?
Primärquellen zur Untersuchung von Vision-Language-Modellen
Zu den maßgeblichen Ausgangspunkten für den Teil des KI-Stacks, der Vision-Language-Modelle umgibt, zählen die Forschungsarbeit zu CLIP und das verkörperte multimodale Modell PaLM-E. Lesen Sie diese Quellen zusammen mit der Dokumentation zum konkreten Modell, Datensatz, zur Hardware und zur jeweiligen Rechtsordnung. Eine allgemeine Quelle kann den Mechanismus erläutern; ob eine bestimmte Implementierung geeignet ist, lässt sich jedoch nur anhand von Nachweisen aus dem konkreten Einsatz feststellen.
Was Sie über Vision-Language-Modelle wissen sollten
Vision-Language-Modelle sind ein klar umrissener Mechanismus innerhalb eines größeren soziotechnischen Systems. Ihr Wert ergibt sich daraus, dass sie unter ausdrücklich festgelegten Bedingungen ein bestimmtes Ergebnis verbessern – nicht aus ihrer Bezeichnung. Die Darstellung der fünf Phasen macht den Informationsfluss sichtbar, der Vergleich zeigt, was sie nicht sind, und der Kontrollpfad zeigt, wo eine verantwortliche Person eingreifen kann.
Die praktische Faustregel für Vision-Language-Modelle lautet: Definieren Sie das Ziel, vergleichen Sie das Modell mit einer glaubwürdigen Ausgangsbasis, testen Sie den wichtigsten Fehlerfall und bewahren Sie die Nachweise auf, die zur Überwachung von Veränderungen erforderlich sind. Sind diese Voraussetzungen erfüllt, wird das Konzept zu einer technischen und organisatorischen Entscheidung, die sich evaluieren lässt. Fehlen sie, bleibt es ein vielversprechender Name, der mit einem unbekannten Betriebsrisiko verbunden ist.


