
Grundlagen der KI
Was sind KI-Leitplanken? Wie Produktionssysteme das Modellverhalten steuern
AI Guardrails sind geschichtete technische und prozedurale Kontrollen, die Eingaben, Aktionen, Ausgaben und Eskalationen rund um ein Modell oder einen Agenten einschränken. Dieser Leitfaden erklärt den Mechanismus, die Kompromisse, die Bewertung und die Kontrollen, die in der Praxis relevant sind.

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
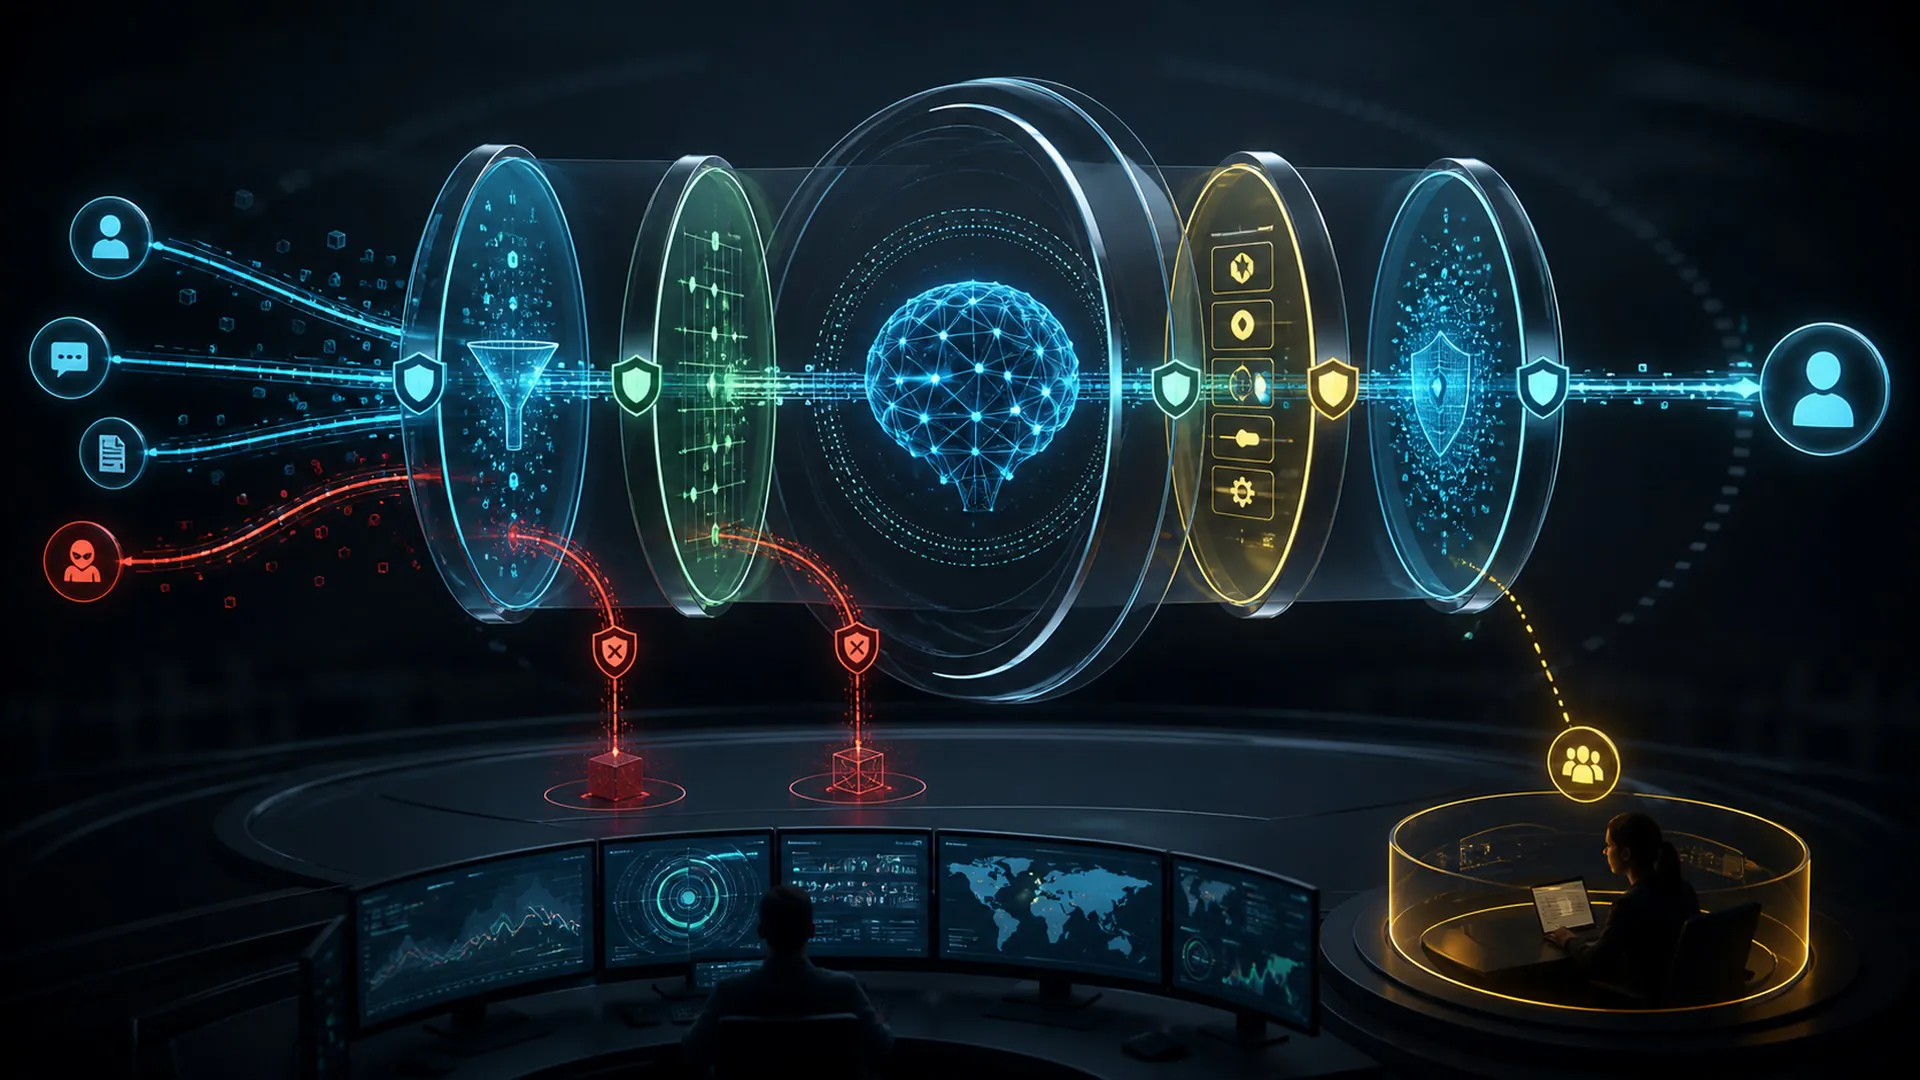
KI-Leitplanken sind geschichtete technische und prozedurale Kontrollen, die Eingaben, Aktionen, Ausgaben und Eskalationen rund um ein Modell oder einen Agenten einschränken.
KI-Leitplanken verdienen eine präzise Erklärung, weil ihr Name einen bestimmten Informationsfluss, eine Trainingswahl, einen Laufzeitmechanismus oder eine Governance‑Grenze identifiziert. Sie als Synonym für „fortgeschrittene KI“ zu behandeln, macht Behauptungen unmöglich zu prüfen. Dieser Leitfaden verfolgt das Konzept von den Eingaben und Annahmen bis zu seinem beobachtbaren Ergebnis und testet anschließend die Abkürzung, die am ehesten damit verwechselt wird.
KI-Leitplanken: Definition, Grenze und Zweck
KI-Leitplanken sind geschichtete technische und prozedurale Kontrollen, die Eingaben, Aktionen, Ausgaben und Eskalationen rund um ein Modell oder einen Agenten einschränken. Die Definition enthält drei praktische Verpflichtungen: Es gibt eine identifizierbare Eingabe, eine Transformation oder Entscheidung, die charakteristisch für KI-Leitplanken ist, und ein Ergebnis, das gegen ein angegebenes Ziel bewertet werden kann. Fehlt eines dieser Elemente, kann die Bezeichnung eher ein angestrebtes Ziel als einen implementierten Mechanismus beschreiben.
Vertrauenswürdige KI erfordert Evidenz über den gesamten Lebenszyklus. Eine Kontrolle ist nur dann bedeutsam, wenn ihr Eigentümer, ihr Umfang, ihr Auslöser, das erwartete Verhalten und die Verifizierungsmethode klar definiert sind. Für KI-Leitplanken ist diese systemische Sichtweise wichtig, weil die Leistung durch die umgebenden Daten, Schnittstellen, Hardware, Berechtigungen und Personen bestimmt werden kann, selbst wenn das zugrunde liegende Modell unverändert bleibt. Eine hilfreiche Erklärung trennt daher das erlernte Verhalten des Modells von dem Produkt, das entscheidet, wann, wo und mit welcher Autorität dieses Verhalten eingesetzt wird.
Die am nächsten liegende irreführende Abkürzung ist ein einzelner Systemprompt, von dem erwartet wird, dass er jede Grenze durchsetzt. Er kann ein sichtbares Merkmal mit KI-Leitplanken teilen, ändert jedoch die kausale Geschichte: Andere Evidenz würde den Erfolg nachweisen, andere Ressourcen würden die Kosten dominieren, und andere Kontrollen würden Schaden verhindern. Die Grenze ist daher operationell und nicht terminologisch.
Eine fünfstufige Betriebslandkarte für KI-Leitplanken
Das Diagramm ist eine kompakte kausale Karte für KI-Leitplanken, jedoch keine Behauptung, dass jede Implementierung fünf Softwarekomponenten verwendet. Einige Systeme kombinieren Phasen, andere wiederholen sie in einer Schleife. Die Karte bleibt nützlich, weil sie jede Änderung von Informationen oder Autorität dazu zwingt, einen Eigentümer, eine Eingabe, eine Ausgabe und einen Test zu haben.
1. Klassifizieren der Anfrage und anwendbare Richtlinie: Eingabe und Annahmen in KI-Leitplanken
In diesem Stadium der KI-Leitplanken muss das System die Anfrage und die anwendbare Richtlinie klassifizieren. Die entscheidende Frage ist nicht nur, ob dieser Vorgang stattfindet, sondern welche Informationen er verbraucht, welchen Zustand er ändert und welche Evidenz beweist, dass die Änderung gültig war. Ein Prüfer sollte in der Lage sein, den Vorgang von einem einzelnen Systemprompt zu unterscheiden, von dem erwartet wird, jede Grenze durchzusetzen, und dessen Ergebnis unter denselben Bedingungen zu reproduzieren.
Der Übergang in dieses KI-Leitplanken‑Stadium beginnt mit dem angegebenen Ziel und sollte mit einem Ergebnis enden, das die Einschränkung von Kontext, Werkzeugen und Datenzugriff unterstützen kann. Unsicherheit, verworfene Alternativen, Ressourcennutzung und jede menschliche oder softwarebasierte Kontrolle, die an der Grenze angewendet wurde, sollten dokumentiert werden. Diese Spur ermöglicht es Teams zu erkennen, ob Leitplanken legitime Arbeit blockieren, umgangen werden können oder ein falsches Sicherheitsgefühl erzeugen, bevor dieselbe Schwäche zu einem signifikanten Ergebnis führt.
2. Einschränken von Kontext, Werkzeugen und Datenzugriff: Repräsentation oder Entscheidung in KI-Leitplanken
In diesem Stadium der KI-Leitplanken muss das System Kontext, Werkzeuge und Datenzugriff einschränken. Die entscheidende Frage ist nicht nur, ob dieser Vorgang stattfindet, sondern welche Informationen er verbraucht, welchen Zustand er ändert und welche Evidenz beweist, dass die Änderung gültig war. Ein Prüfer sollte in der Lage sein, den Vorgang von einem einzelnen Systemprompt zu unterscheiden, von dem erwartet wird, jede Grenze durchzusetzen, und dessen Ergebnis unter denselben Bedingungen zu reproduzieren.
Der Übergang in dieses KI-Leitplanken‑Stadium beginnt mit der Klassifizierung der Anfrage und der anwendbaren Richtlinie und sollte mit einem Ergebnis enden, das die Validierung vorgeschlagener Aktionen vor der Ausführung unterstützen kann. Unsicherheit, verworfene Alternativen, Ressourcennutzung und jede menschliche oder softwarebasierte Kontrolle, die an der Grenze angewendet wurde, sollten dokumentiert werden. Diese Spur ermöglicht es Teams zu erkennen, ob Leitplanken legitime Arbeit blockieren, umgangen werden können oder ein falsches Sicherheitsgefühl erzeugen, bevor dieselbe Schwäche zu einem signifikanten Ergebnis führt.
3. Vorgeschlagene Aktionen vor der Ausführung validieren: Unterscheidende Transformation in AI Guardrails
In diesem Stadium der AI Guardrails muss das System vorgeschlagene Aktionen vor der Ausführung validieren. Die relevante Frage ist nicht nur, ob dieser Vorgang stattfindet, sondern welche Informationen er verbraucht, welchen Zustand er ändert und welche Belege belegen, dass die Änderung gültig war. Ein Prüfer sollte in der Lage sein, den Vorgang von einem einzelnen System‑Prompt zu unterscheiden, der jede Grenze durchsetzen soll, und dessen Ergebnis unter denselben angegebenen Bedingungen reproduzieren zu können.
Der Übergang in dieses AI Guardrails‑Stadium beginnt mit eingeschränktem Kontext, Werkzeugen und Datenzugriff und sollte mit einem Ergebnis enden, das die Inspektion von Ausgaben und geänderten Zuständen unterstützen kann. Unsicherheit, verworfene Alternativen, Ressourcennutzung und jede menschliche oder softwarebasierte Kontrolle, die an der Grenze angewendet wird, sollten dokumentiert werden. Diese Spur ermöglicht es Teams zu erkennen, ob Guardrails legitime Arbeit blockieren, umgangen werden können oder ein falsches Sicherheitsgefühl erzeugen, bevor dieselbe Schwäche zu einem bedeutenden Ergebnis führt.
4. Ausgaben und geänderten Zustand prüfen: Beschränkungs‑ und Verifizierungsgrenze in AI Guardrails
In diesem Stadium der AI Guardrails muss das System Ausgaben und den geänderten Zustand prüfen. Die relevante Frage ist nicht nur, ob dieser Vorgang stattfindet, sondern welche Informationen er verbraucht, welchen Zustand er ändert und welche Belege belegen, dass die Änderung gültig war. Ein Prüfer sollte in der Lage sein, den Vorgang von einem einzelnen System‑Prompt zu unterscheiden, der jede Grenze durchsetzen soll, und dessen Ergebnis unter denselben angegebenen Bedingungen reproduzieren zu können.
Der Übergang in dieses AI Guardrails‑Stadium beginnt mit der Validierung vorgeschlagener Aktionen vor der Ausführung und sollte mit einem Ergebnis enden, das Eskalation, Protokollierung und Verbesserung aus Vorfällen unterstützen kann. Unsicherheit, verworfene Alternativen, Ressourcennutzung und jede menschliche oder softwarebasierte Kontrolle, die an der Grenze angewendet wird, sollten dokumentiert werden. Diese Spur ermöglicht es Teams zu erkennen, ob Guardrails legitime Arbeit blockieren, umgangen werden können oder ein falsches Sicherheitsgefühl erzeugen, bevor dieselbe Schwäche zu einem bedeutenden Ergebnis führt.
5. Eskalieren, protokollieren und aus Vorfällen lernen: Ausgabe, Feedback und Stopp‑Regel in AI Guardrails
In diesem Stadium der AI Guardrails muss das System eskalieren, protokollieren und aus Vorfällen lernen. Die relevante Frage ist nicht nur, ob dieser Vorgang stattfindet, sondern welche Informationen er verbraucht, welchen Zustand er ändert und welche Belege belegen, dass die Änderung gültig war. Ein Prüfer sollte in der Lage sein, den Vorgang von einem einzelnen System‑Prompt zu unterscheiden, der jede Grenze durchsetzen soll, und dessen Ergebnis unter denselben angegebenen Bedingungen reproduzieren zu können.
Der Übergang in dieses AI Guardrails‑Stadium beginnt mit der Inspektion von Ausgaben und geänderten Zuständen und sollte mit einem Ergebnis enden, das Überwachung oder eine endgültige Entscheidung unterstützen kann. Unsicherheit, verworfene Alternativen, Ressourcennutzung und jede menschliche oder softwarebasierte Kontrolle, die an der Grenze angewendet wird, sollten dokumentiert werden. Diese Spur ermöglicht es Teams zu erkennen, ob Guardrails legitime Arbeit blockieren, umgangen werden können oder ein falsches Sicherheitsgefühl erzeugen, bevor dieselbe Schwäche zu einem bedeutenden Ergebnis führt.
Lesen Sie die AI Guardrails‑Karte vorwärts, um die Produktion zu verstehen, und rückwärts, um Fehler zu diagnostizieren. Vorwärts‑Analyse fragt, wie eine Stufe die nächste versorgt. Rückwärts‑Analyse beginnt bei einem falschen, langsamen, teuren oder unsicheren Ergebnis und verfolgt, welche frühere Annahme es ermöglicht hat. Der umgekehrte Pfad ist häufig der Ort, an dem ein Team entdeckt, dass der entscheidende Fehler bereits vor der Ausgabe des Modells aufgetreten ist.
Ein praktisches Beispiel für AI Guardrails
Ein Finanzassistent kann eine Überweisungsanweisung entwerfen, aber eine deterministische Regel und ein autorisierter Prüfer müssen die Ausführung genehmigen.
Dieses Beispiel ist aufschlussreich, weil AI Guardrails an beobachtbare Eingaben, Zwischenzustände und ein Ergebnis geknüpft werden können, anstatt durch eine ausgefeilte Demonstration beurteilt zu werden. Ein rigoroser Test würde gewöhnliche, schwierige und bewusst irreführende Fälle rund um das Szenario erstellen, eine Basislinie ohne die Technik beibehalten und sowohl die durchschnittliche Leistung als auch die Schwere einzelner Fehler dokumentieren.
Ändern Sie eine Annahme im AI Guardrails‑Beispiel und wiederholen Sie die Analyse. Entfernen Sie eine erforderliche Eingabe, führen Sie ein widersprüchliches Signal ein, begrenzen Sie die Rechenleistung, ändern Sie die Nutzerpopulation oder zwingen Sie das System zum Enthalten. Ein Mechanismus, der nur unter einer sorgfältig arrangierten Demonstration funktioniert, hat nicht gezeigt, dass er auf die Betriebsumgebung übertragbar ist.
AI Guardrails vs. ihr häufigster Shortcut
AI Guardrails werden häufig auf einen einzigen System‑Prompt reduziert, der jede Grenze durchsetzen soll. Diese Reduktion entfernt die eigentliche Grenze, die das Konzept definiert. Sie kann dazu führen, dass Käufer ungleiche Produkte vergleichen, Forschende die Aussagekraft eines Experiments überbewerten und Betreiber nach der Bereitstellung das falsche Signal überwachen.
| Linse | Praktische Antwort |
|---|---|
| Definition | KI‑Guardrails sind mehrschichtige technische und prozedurale Kontrollen, die Eingaben, Aktionen, Ausgaben und Eskalationen rund um ein Modell oder einen Agenten einschränken. |
| Verwirrung | ein einzelner System‑Prompt, der jede Grenze durchsetzen soll. |
| Risiko | Guardrails können legitime Arbeit blockieren, umgangen werden oder ein falsches Sicherheitsgefühl erzeugen. |
Der Vergleich sollte zudem die Analyseeinheit bestimmen. Ein Papier über KI‑Guardrails kann ein Modell oder einen Algorithmus isolieren, während ein eingesetzter Service Retrieval, Routing, Caching, Richtlinien, Identität, Benutzeroberflächen und Monitoring hinzufügt. Zwei Produkte können denselben Schlagwortbegriff verwenden, während sie unterschiedliche Teile dieses Stacks implementieren. Fragen Sie, welche Komponente die definierende Transformation ausführt und welche anderen Komponenten für das berichtete Ergebnis erforderlich sind.
Warum KI‑Guardrails in heutigen KI‑Systemen wichtig sind
KI‑Guardrails sind jetzt wichtig, weil KI‑Systemen größere Kontexte, mehr Modalitäten, mehr Laufzeit‑Rechenleistung, breiteren Werkzeugzugriff und tiefere Verbindungen zu organisatorischen Entscheidungen gegeben werden. Unter diesen Bedingungen kann das, was einst wie ein Forschungsdetail wirkte, Latenz, Sicherheit, Zugänglichkeit, Umweltkosten, Produktqualität oder rechtliche Verantwortlichkeit bestimmen.
Das relevante Maß ist nicht, ob KI‑Guardrails ein einziges beeindruckendes Ergebnis erzielen können. Es geht darum, ob die Technik ein Ergebnis verbessert, das unter repräsentativen Bedingungen von Bedeutung ist, und dies effektiver als ein einfacherer Ausgangspunkt tut. Berichten Sie Verteilungen, Fehlkategorien, Tail‑Latenz, Ressourcennutzung und betroffene Untergruppen, anstatt jedes Ergebnis in einen einzigen Durchschnitt zu komprimieren.
Überwachen Sie sowohl technische Kennzahlen als auch Auswirkungen auf Menschen. Dokumentieren Sie Unsicherheiten, bewahren Sie die Herkunft, ermöglichen Sie Eskalationen und entwerfen Sie Wiederherstellungen, bevor das System realen, sich ändernden Bedingungen ausgesetzt wird. Speziell auf KI‑Guardrails angewandt, macht diese Disziplin die Evidenz portabel: Ein anderes Team kann beurteilen, ob der behauptete Gewinn wahrscheinlich auch bei einem anderen Modell, einer anderen Sprache, Hardware‑Plattform, Datensatz, Nutzerpopulation oder Risikotoleranz bestehen bleibt.
Vorteile, die KI‑Guardrails bieten können
Der stärkste Grund für den Einsatz von KI‑Guardrails ist, dass sie das beabsichtigte Engpassproblem direkt adressieren können. Je nach Implementierung kann der Nutzen als besseres Grounding, eine treuere Darstellung, verbesserte Generalisierung, geringere Latenz, reduzierte Speicherbewegungen, klarere Verantwortlichkeit oder eine sicherere Grenze zwischen einem Modellvorschlag und einer realen Aktion erscheinen.
Vorteile sollten als Entscheidungen und Messungen ausgedrückt werden. „Intelligenter“ ist kein Akzeptanzkriterium für KI‑Guardrails. Ein nützliches Ziel könnte die Fehlerrate bei schwierigen Fällen, die Wiederherstellung nach widersprüchlichen Beweisen, die Kosten bei einem bestimmten Traffic‑Perzentil, die Zeit für menschliche Überprüfung, die Kalibrierung oder den Prozentsatz der Aktionen innerhalb einer definierten Autoritätsgrenze spezifizieren.
Der Fehlermodus, der KI‑Guardrails definiert
Die zentrale Einschränkung ist, dass Guardrails legitime Arbeit blockieren, umgangen werden oder ein falsches Sicherheitsgefühl erzeugen können. Dieses Versagen ist kein nachträglicher Gedanke, der nach Abschluss der Entwicklung einmal aufgelistet wird. Es sollte von Anfang an Datenerhebung, Architektur, Berechtigungen, Evaluation, Release‑Gates und Monitoring für KI‑Guardrails prägen.
Eine Kontrolle für KI‑Guardrails ist nur dann nützlich, wenn sie vor einer teuren oder irreversiblen Konsequenz wirkt. Identifizieren Sie den frühesten beobachtbaren Vorläufer des Fehlers, setzen Sie einen Schwellenwert oder eine Regel, weisen Sie einen verantwortlichen Eigentümer zu und testen Sie die Wiederherstellung. Je nach Anwendungsfall kann Wiederherstellung bedeuten, sich zurückzuziehen, zu einem einfacheren System zu fallbacken, mehr Evidenz anzufordern, an eine Person zu eskalieren, ein Modell zurückzurollen oder eine Aktion vollständig zu stoppen.
Ein Evaluationsplan für KI‑Guardrails
Beginnen Sie die Bewertung von AI Guardrails, indem Sie die Entscheidung formulieren, die die Evidenz unterstützen muss. Definieren Sie die Zielpopulation, die Konsequenz eines falschen Ergebnisses, die zum Entscheidungszeitpunkt tatsächlich verfügbaren Informationen und die einfachste glaubwürdige Alternative. Dies verhindert, dass ein Benchmark zum Ziel wird, nur weil er leicht durchzuführen ist.
Verwenden Sie ein unbehandeltes Testset für kontrollierte Vergleiche und validieren Sie anschließend AI Guardrails in einer gestuften Betriebsumgebung. Offline‑Bewertung macht Varianten vergleichbar; Shadow‑Mode, Canary‑Tests, Rate‑Limits oder Genehmigungstore zeigen, wie realer Datenverkehr, Feedback‑Schleifen und Menschen das Verhalten ändern. Die Bereitstellungsphase sollte eine explizite Stopp‑Bedingung besitzen, anstatt anzunehmen, dass jede Verbesserung eine vollständige Ausrollung rechtfertigt.
Versionieren Sie die Eingaben, die zur Reproduktion von AI Guardrails erforderlich sind: Quelldaten, Vorverarbeitung, Tokenizer oder Encoder, Modellgewichte, Konfiguration, Prompt oder Richtlinie, Retrieval‑Index, Evaluations‑Set, Hardware‑Annahmen und Bereitstellungscode, sofern zutreffend. Ohne Nachverfolgbarkeit kann ein Team nicht feststellen, ob ein geändertes Ergebnis von der Technik, der Umgebung oder einer unbemerkten Pipeline‑Änderung stammt.
Fragen Sie schließlich, welche Erkenntnis die Behauptung, dass AI Guardrails helfen, widerlegen würde. Wenn kein Ergebnis die Adoptionsentscheidung umkehren könnte, ist die Bewertung Marketing. Vorgegebene Akzeptanzschwellen und ein erhaltenes Bestätigungs‑Set verwandeln die Übung in Evidenz.
Fragen, die vor der Einführung von AI Guardrails gestellt werden sollten
- Ziel: Welcher messbare Engpass soll mit AI Guardrails gelöst werden?
- Mechanismus: Welche der fünf Phasen enthält die charakteristische Transformation?
- Grundlage: Wie schneidet es im Vergleich zu einem einzelnen System‑Prompt ab, das jede Grenze durchsetzen soll, oder einer anderen einfacheren Alternative?
- Evidenz: Welche normalen, schwierigen, adversarialen und Subgruppen‑Fälle wurden getestet?
- Operationen: Welche Latenz‑, Speicher‑, Rechen‑, Energie‑, Wartungs‑ und Prüfkosten entstehen im großen Maßstab?
- Risiko: Wie wird das Team erkennen, dass Guardrails legitime Arbeit blockieren, umgangen werden können oder ein falsches Sicherheitsgefühl erzeugen?
- Wiederherstellung: Kann das System sich enthalten, zurückfallen, zurückrollen oder eskalieren, bevor Schaden entsteht?
Primärquellen zum Studium von AI Guardrails
Autoritative Ausgangspunkte für den Teil des KI‑Stacks, der AI Guardrails umgibt, umfassen NIST AI Risk Management Framework, C2PA specifications, NIST Privacy Framework. Lesen Sie sie zusammen mit der Dokumentation für das genaue Modell, den Datensatz, die Hardware und die betroffene Rechtsordnung. Eine allgemeine Quelle kann den Mechanismus definieren, aber nur deploymentspezifische Evidenz kann nachweisen, dass eine bestimmte Implementierung geeignet ist.
Wichtige Punkte zu AI Guardrails
AI Guardrails ist ein definiertes Verfahren innerhalb eines größeren soziotechnischen Systems. Sein Wert ergibt sich daraus, ein spezifisches Ergebnis unter klaren Bedingungen zu verbessern, nicht aus der Bezeichnung selbst. Die Fünf‑Stufen‑Karte macht den Informationsfluss sichtbar, der Vergleich zeigt, was es nicht ist, und der Kontrollpfad verdeutlicht, wo ein verantwortlicher Betreiber eingreifen kann.
Die praktische Regel für AI Guardrails lautet, das Ziel zu definieren, es mit einer glaubwürdigen Basislinie zu vergleichen, den wichtigsten Ausfall zu testen und die Evidenz zu bewahren, die zur Überwachung von Änderungen nötig ist. Mit diesen Bausteinen wird das Konzept zu einer ingenieurtechnischen und governance‑technischen Entscheidung, die bewertet werden kann. Ohne sie bleibt es ein vielversprechender Begriff, der an ein unbekanntes Betriebsrisiko geknüpft ist.


