
Andersons Blickwinkel
Echtzeitfähige KI-Menschen dank Neural Lumigraph Rendering

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Wichtige PunkteNeural Lumigraph Rendering verbessert NeRF um etwa zwei Größenordnungen.
Mehr anzeigen
- Neural Lumigraph Rendering verbessert NeRF um etwa zwei Größenordnungen.
- NLR verwendet SIREN-Netzwerke, um die Stärken von NeRF und IDR für Echtzeitgrafiken zu kombinieren.
- NLR fehlen dynamische Beleuchtung und Relighting-Fähigkeiten, wodurch die Ausgabe auf die Beleuchtung zum Aufnahmezeitpunkt beschränkt ist.
Trotz des aktuellen Interesses an neuronalen Strahlungsfeldern (NeRF), einer Technologie zur Erzeugung KI-generierter 3D-Umgebungen und -Objekte, erfordert dieser neue Ansatz der Bildsynthese weiterhin einen erheblichen Trainingsaufwand. Außerdem fehlt eine Implementierung, die echtzeitfähige, hochreaktive Schnittstellen ermöglicht.
Eine Zusammenarbeit namhafter Vertreter aus Industrie und Wissenschaft bietet jedoch einen neuen Ansatz für diese Herausforderung, die allgemein als Novel View Synthesis (NVS) bezeichnet wird.
Die Forschungsarbeit mit dem Titel Neural Lumigraph Rendering beansprucht, den Stand der Technik um etwa zwei Größenordnungen zu verbessern. Das ist ein weiterer Schritt auf dem Weg zu echtzeitfähigem CG-Rendering mithilfe von Machine-Learning-Pipelines.

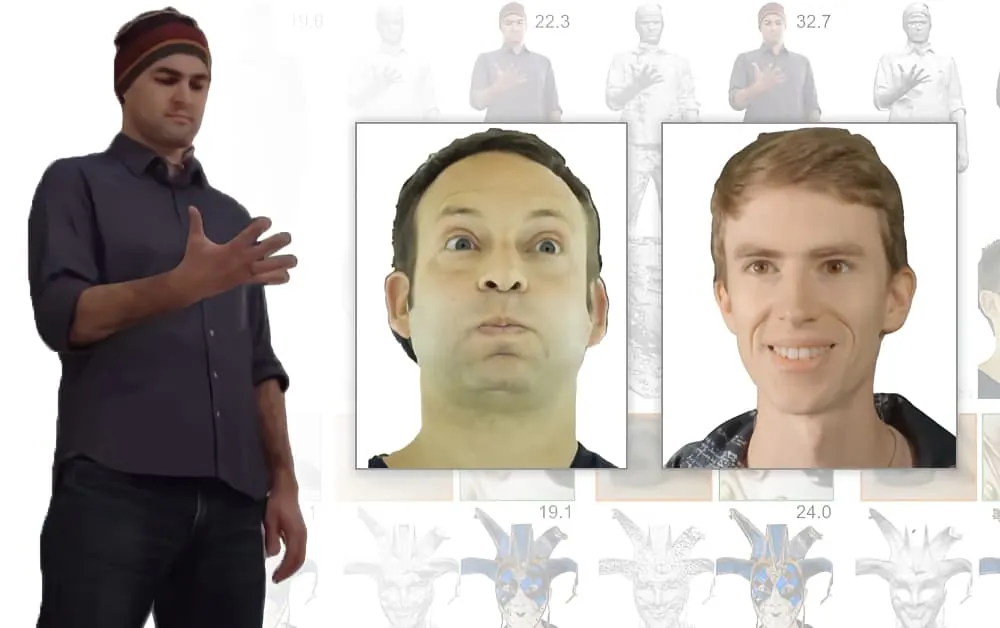
Neural Lumigraph Rendering (rechts) löst Überblendungsartefakte besser auf und behandelt Verdeckungen besser als frühere Methoden. Quelle.
Obwohl im Quellenverzeichnis der Arbeit nur die Stanford University und das auf holografische Displaytechnologie spezialisierte Unternehmen Raxium (derzeit im Tarnmodus) genannt werden, gehören zu den Mitwirkenden ein leitender Machine-Learning-Architekt bei Google und ein Informatikwissenschaftler bei Adobe (ADBE ), und der Technikchef bei StoryFile (das kürzlich mit einer KI-Version von William Shatner Schlagzeilen machte).
Im Zusammenhang mit der jüngsten Publicity-Offensive rund um Shatner scheint StoryFile NLR in seinem neuen Verfahren zur Entwicklung interaktiver, KI-generierter Figuren einzusetzen, die auf den Eigenschaften und Erzählungen einzelner Personen basieren.
StoryFile sieht Einsatzmöglichkeiten für diese Technologie in Museumsausstellungen, interaktiven Online-Erzählungen, holografischen Displays, Augmented Reality (AR) und der Dokumentation des kulturellen Erbes. Außerdem scheint das Unternehmen mögliche neue Anwendungen von NLR bei Vorstellungsgesprächen und virtuellen Dating-Apps ins Auge zu fassen:

Vorgeschlagene Anwendungsbereiche aus einem Online-Video von StoryFile.
Volumetrische Erfassung für Novel-View-Synthesis-Schnittstellen und Videos
Das Prinzip der volumetrischen Erfassung, das in den zahlreichen Arbeiten zu diesem Thema behandelt wird, besteht darin, Standbilder oder Videos eines Motivs aufzunehmen und mithilfe von Machine Learning die Ansichten zu ergänzen, die von der ursprünglichen Kamerakonfiguration nicht erfasst wurden.
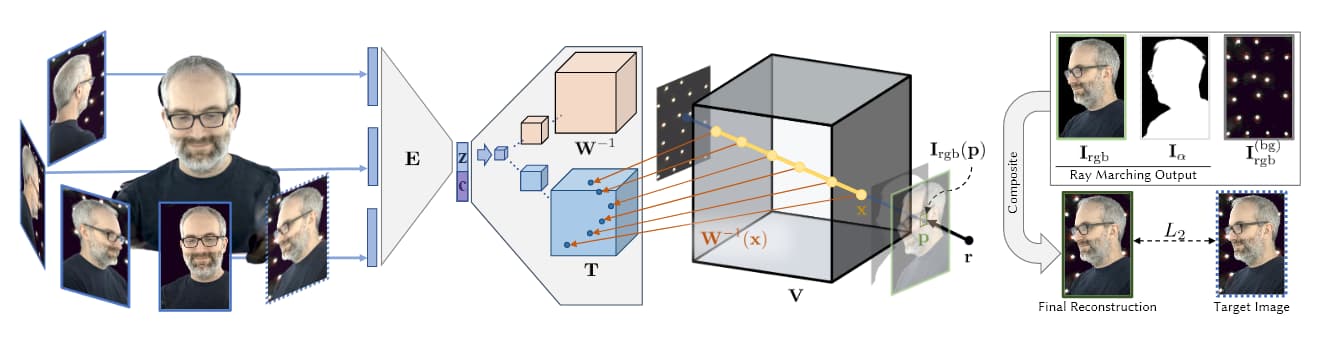
Quelle: https://research.fb.com/wp-content/uploads/2019/06/Neural-Volumes-Learning-Dynamic-Renderable-Volumes-from-Images.pdf
Im obigen Bild aus Facebooks KI-Forschung von 2019 (siehe unten) sind die vier Phasen der volumetrischen Erfassung zu sehen: Mehrere Kameras nehmen Bilder und Videomaterial auf; Encoder-Decoder-Architekturen (oder andere Architekturen) berechnen die Beziehungen zwischen den Ansichten und fügen sie zusammen; Ray-Marching-Algorithmen berechnen die Voxel (oder andere räumliche geometrische Einheiten in XYZ-Koordinaten) jedes Punkts im Volumenraum; und in den meisten neueren Arbeiten wird das Training genutzt, um ein vollständiges Objekt zu synthetisieren, das sich in Echtzeit manipulieren lässt.
Diese oft umfangreiche und datenintensive Trainingsphase hat bislang verhindert, dass die Synthese neuartiger Ansichten in den Bereich echtzeitfähiger oder hochreaktiver Erfassung vordringt.
Da bei der Novel View Synthesis eine vollständige 3D-Karte eines Volumenraums erstellt wird, lassen sich diese Punkte relativ einfach zu einem herkömmlichen computergenerierten Netz verbinden. So kann ein CGI-Mensch (oder ein anderes räumlich begrenztes Objekt) praktisch in Echtzeit erfasst und animiert werden.
NeRF-basierte Ansätze nutzen Punktwolken und Tiefenkarten, um zwischen den wenigen Blickwinkeln der Erfassungsgeräte zu interpolieren:
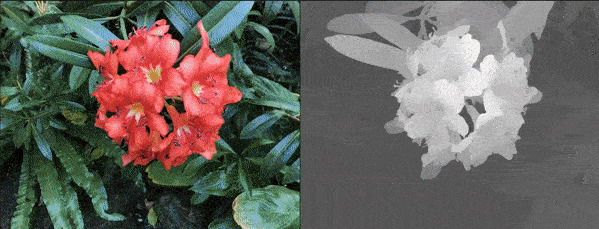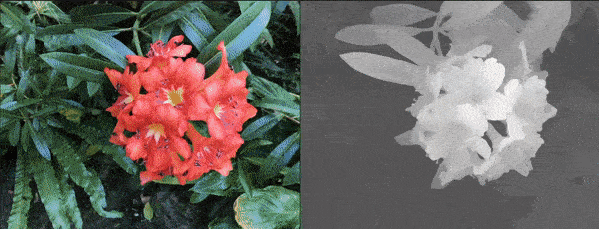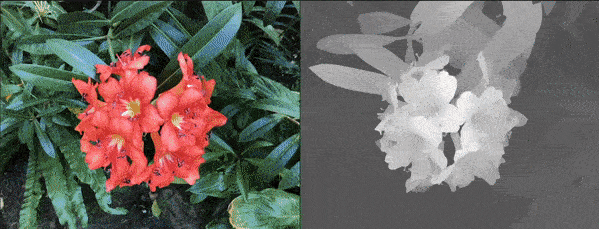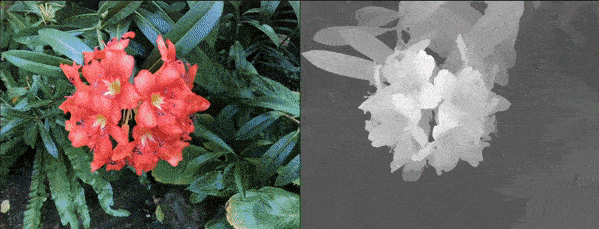
NeRF kann volumetrische Tiefe durch die Berechnung von Tiefenkarten statt durch die Erzeugung von CG-Netzen darstellen. Quelle: https://www.youtube.com/watch?v=JuH79E8rdKc
NeRF ist zwar in der Lage, Netze zu berechnen, doch die meisten Implementierungen nutzen diese Möglichkeit nicht, um Volumenszenen zu erzeugen.
Der Ansatz des Implicit Differentiable Renderer (IDR), der im Oktober 2020 vom Weizmann Institute of Science veröffentlicht wurde, beruht dagegen darauf, 3D-Netzinformationen zu nutzen, die automatisch aus Kameraaufnahmen generiert werden:
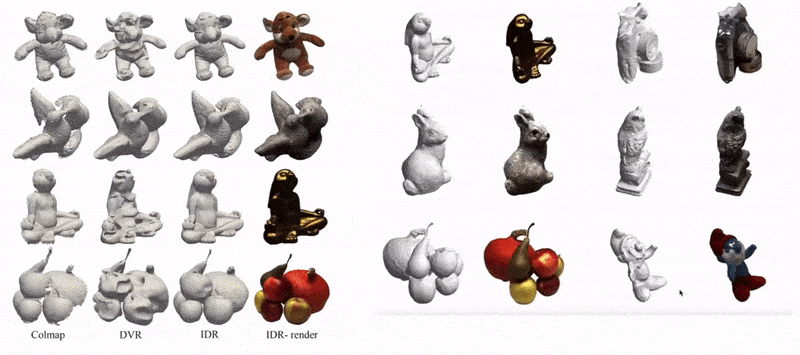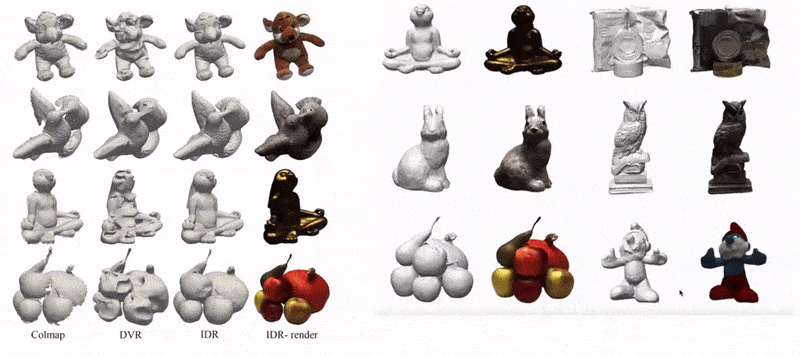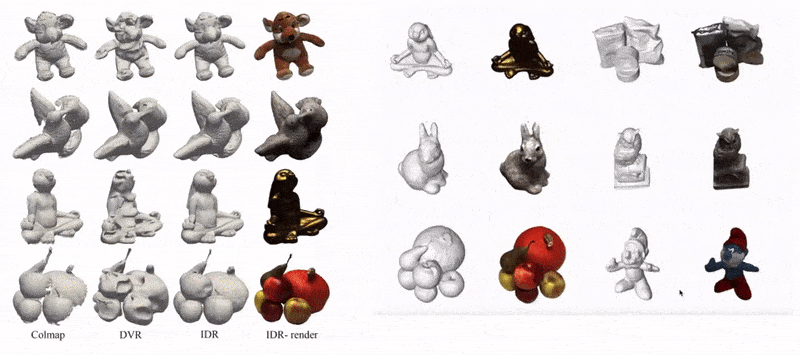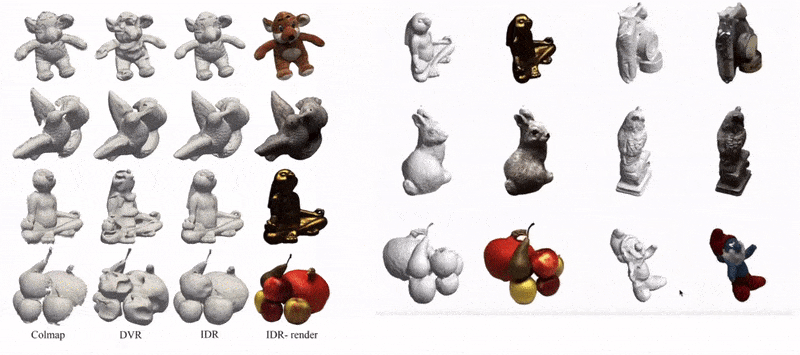
Beispiele für IDR-Aufnahmen, die in interaktive CGI-Netze umgewandelt wurden. Quelle: https://www.youtube.com/watch?v=C55y7RhJ1fE
Während NeRF nicht über IDRs Fähigkeit zur Formschätzung verfügt, kann IDR nicht mit der Bildqualität von NeRF mithalten, und beide erfordern umfangreiche Ressourcen für Training und Zusammenstellung (auch wenn jüngste Innovationen bei NeRF nun damit beginnen, dieses Problem anzugehen).

NLRs maßgeschneidertes Kamerarig mit 16 GoPro HERO7 und 6 zentral angeordneten Back-Bone H7PRO-Kameras. Für das Rendering in „Echtzeit“ arbeiten diese mit mindestens 60 fps. Quelle: https://arxiv.org/pdf/2103.11571.pdf
Stattdessen nutzt Neural Lumigraph Rendering SIREN (sinusförmige Repräsentationsnetzwerke), um die Stärken beider Ansätze in einem eigenen Framework zu vereinen. Dieses soll Ergebnisse erzeugen, die sich direkt in vorhandenen Echtzeit-Grafikpipelines verwenden lassen.
SIREN wurde im vergangenen Jahr für ähnliche Implementierungen eingesetzt und ist inzwischen ein beliebter API-Aufruf für Colabs von Hobbyisten in Bildsynthese-Communitys. Die Neuerung bei NLR besteht jedoch darin, SIREN-Netzwerke auf die zweidimensionale Mehransichts-Bildüberwachung anzuwenden. Das ist problematisch, weil SIREN in hohem Maße überangepasste statt verallgemeinerbare Ergebnisse erzeugt.
Nachdem das CG-Mesh aus den Arraybildern extrahiert wurde, wird es mit OpenGL rasterisiert und werden die Scheitelpunktpositionen des Meshes den entsprechenden Pixeln zugeordnet. Anschließend wird die Überblendung der verschiedenen beitragenden Karten berechnet.
Das resultierende Mesh ist allgemeiner und repräsentativer als das von NeRF (siehe Abbildung unten), erfordert weniger Rechenaufwand und weist Bereichen, die davon nicht profitieren können – etwa glatter Gesichtshaut –, keine übermäßigen Details zu:

Quelle: https://arxiv.org/pdf/2103.11571.pdf
Nachteilig ist, dass NLR bislang keine dynamische Beleuchtung oder nachträgliche Änderung der Beleuchtung unterstützt. Die Ausgabe ist auf Schattenkarten und andere Beleuchtungsinformationen beschränkt, die zum Zeitpunkt der Aufnahme erfasst wurden. Die Forschenden wollen sich in künftigen Arbeiten damit befassen.
Außerdem räumt die Arbeit ein, dass die von NLR erzeugten Formen weniger genau sind als die mancher alternativen Ansätze, etwa pixelweise Ansichtsselektion für unstrukturiertes Mehransichts-Stereo, oder der zuvor erwähnten Forschung des Weizmann-Instituts.
Der Aufstieg der volumetrischen Bildsynthese
Die Idee, mithilfe neuronaler Netze aus einer begrenzten Reihe von Fotos 3D-Objekte zu erzeugen, gab es bereits vor NeRF; wegweisende Arbeiten dazu reichen bis ins Jahr 2007 oder noch weiter zurück. 2019 veröffentlichte die KI-Forschungsabteilung von Facebook eine bahnbrechende Forschungsarbeit mit dem Titel Neuronale Volumina: Lernen dynamisch renderbarer Volumina aus Bildern, die erstmals reaktionsfähige Benutzeroberflächen für synthetische Menschen ermöglichte, die durch volumetrische, auf maschinellem Lernen basierende Erfassung erzeugt wurden.
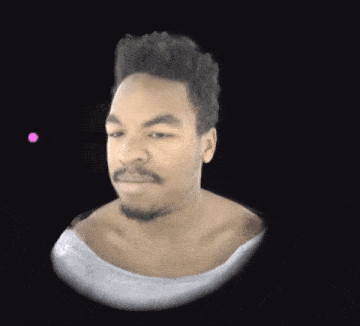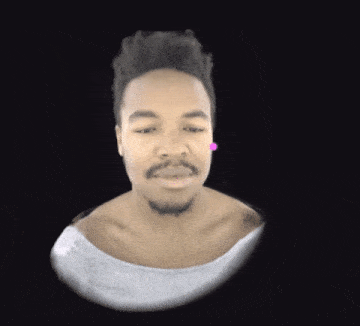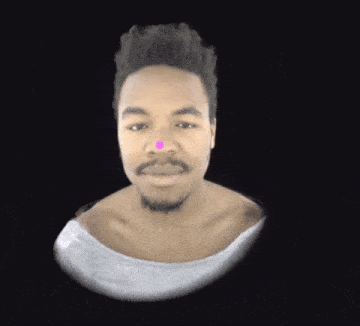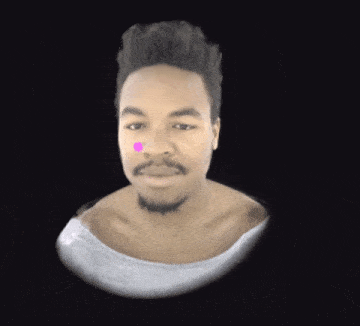
Facebooks Forschung aus dem Jahr 2019 ermöglichte die Erstellung einer reaktionsfähigen Benutzeroberfläche für eine volumetrische Person. Quelle: https://research.fb.com/publications/neural-volumes-learning-dynamic-renderable-volumes-from-images/


