
Interviews
Simon Poghosyan, Gründer und CEO von GSpeech – Interview-Serie

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
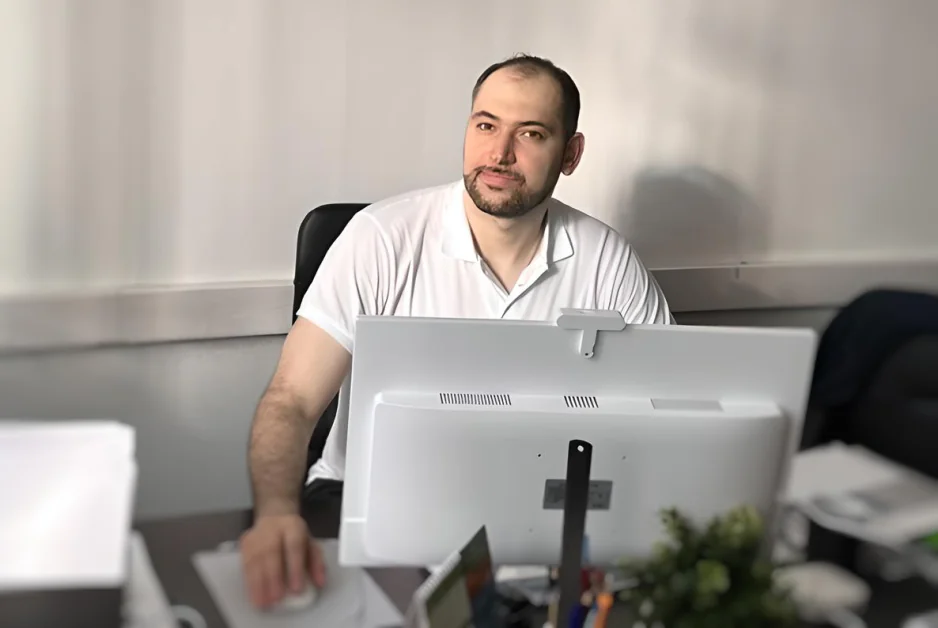
Simon Poghosyan ist der Gründer und CEO von GSpeech, einer webbasierten KI-Plattform, die Online-Inhalte zugänglicher macht, indem sie Text in natürliche, klangvolle Audio-Dateien in über 70 Sprachen umwandelt. Mit einer Ausbildung in VLSI-Design und einem starken Interesse an Programmierung und Benutzererfahrung entwickelte Simon GSpeech, um die Art und Weise zu vereinfachen, wie Websites voice-aktivierte Inhalte anbieten können.
Heute generiert GSpeech etwa 200 Millionen Zeichen Audio pro Monat und wird in über 70 Ländern verwendet, wobei die anpassbaren Audio-Player monatlich über 200.000 Mal abgespielt werden. Nachdem GSpeech kürzlich 1 Milliarde Zeichen Audio generiert hat, wächst die Plattform weiterhin rasant. Die Plattform ist so konzipiert, dass sie leicht zu integrieren ist – nur eine Codezeile ist erforderlich – und unterstützt Ersteller, Bildungseinrichtungen und Unternehmen bei der Erstellung zugänglicher und ansprechender Inhalte.
GSpeech wird auch auf all unseren englischen Seiten verwendet, Sie können diesen Artikel anhören und sehen, wie gut GSpeech funktioniert, indem Sie auf die Wiedergabetaste klicken.
Ihre Ausbildung in VLSI-Design (Very Large Scale Integration) und Ihre frühen Programmiererfahrungen legten eine starke technische Grundlage. Was hat Sie dazu inspiriert, von der Mikroelektronik zur Entwicklung von KI-gesteuerter Software zu wechseln, und wie hat dies zur Entstehung von GSpeech geführt?
Meine Leidenschaft für die Lösung von Problemen begann in der High School, getrieben von einer Liebe zu Mathematik und Physik. Dieses Interesse führte mich dazu, einen Bachelor- (2009) und Master-Abschluss (2011) in VLSI-Design an der State Engineering University of Armenia, in Zusammenarbeit mit Synopsys Armenia, zu erwerben. Das Studium der Physik hat mich in Präzision und analytischem Denken ausgebildet, aber es war während meines zweiten Studienjahres, dass ich die Programmierung entdeckte – beginnend mit der Pascal-Sprache – und mich sofort dafür begeisterte. Mein Freund und ich haben die Aufgabenstellungen für die Kurse sofort bearbeitet, sobald wir sie erhalten hatten, obwohl wir sechs Monate Zeit hatten, um sie abzuschließen. Dann haben wir, nur zum Spaß, die Aufgabenstellungen anderer Studenten bearbeitet.
Diese Leidenschaft führte mich tiefer in die Software-Entwicklung. Ich begann mit der Erstellung von Webseiten, dann baute ich mein eigenes CMS. Nachdem ich mehrere Projekte in der Prozessautomatisierung und der Gestaltung von Datenmanagement-Architekturen abgeschlossen hatte, erkannte ich, wie sehr ich es liebe, digitale Lösungen für Web-Schnittstellen zu entwickeln. Durch das 2GLux-Projekt arbeitete ich mit Edvard Ananyan zusammen – dem Ersteller des beliebten GTranslate-Übersetzungs-Dienstes und einem Schulfreund aus dem Quant-Gymnasium. Er stellte mich den WordPress- und Joomla-Ökosystemen vor und das Konzept für GSpeech entstand bei ihm. Diese frühe Arbeit führte zur ersten Version unseres Tools, das es Benutzern ermöglichte, Text auf einer Webseite anzuhören, und den Samen für das legte, was später eine umfassende KI-Plattform werden sollte. Im Jahr 2023 gründete ich Smarts Club LLC, um GSpeech in eine globale KI-Audio-Lösung zu verwandeln, die 70 Sprachen unterstützt. Die Anerkennung der Humanity Union für die Rolle von GSpeech bei der Verbesserung ihrer Plattform für soziale Verantwortung spiegelt meine Mission wider, digitale Kluft durch KI zu überbrücken – eine Vision, die in meinen frühen Programmier-Tagen verwurzelt ist.
GSpeech begann ursprünglich als Tool, um sehbehinderte Benutzer zu unterstützen. Wie hat diese frühe Mission die Entwicklung der Plattform zu einer umfassenden KI-Text-to-Speech-Lösung beeinflusst?
Der Fokus auf Zugänglichkeit trieb die Entwicklung von hochwertigem, Echtzeit-KI-Audio, der Übersetzung in 70 Sprachen und der nahtlosen Integration in Webseiten durch einen einfachen Code-Snippet voran. Diese Mission führte zu Funktionen wie anpassbaren Audio-Playern, Sprach- und Stimmauswahl-Panelen, kontextbewusster Wiedergabe, Audio-Downloads und detaillierten Nutzungsstatistiken – einschließlich Länder-, Stadt-, Geräte-Daten und Wiedergabe-Analytics im Laufe der Zeit – allesamt konzipiert, um Inhalte zugänglicher und ansprechender zu machen. Nachdem ich über 100.000 Zeilen Code geschrieben hatte, veröffentlichte ich 2023 die GSpeech Cloud-Konsole – eine skalierbare Lösung, die Inklusivität mit fortschrittlicher Funktionalität ausgleicht, um Unternehmen und Erstellern zu ermöglichen, ihre Inhalte zugänglicher, mehrsprachig und interaktiv im Web zu machen.
Welche waren einige der größten technischen Herausforderungen, denen Sie während der Entwicklung der GSpeech Cloud-Konsole gegenüberstanden?
Eine der größten Herausforderungen bei der Entwicklung der GSpeech Cloud-Konsole bestand darin, eine skalierbare Architektur für Echtzeit-, sichere, hochwertige KI-Audio-Generierung zu entwerfen. Dies erforderte innovative Lösungen, um relevante Inhalte aus dem Web abzurufen, Audio auf unseren Servern zu verarbeiten und es in der Cloud für eine schnelle, zuverlässige Lieferung zu speichern. Die Implementierung robuster Sicherheitsmaßnahmen wie Verschlüsselung und Zugriffskontrollen war entscheidend, um dynamische, benutzererzeugte Inhalte zu schützen.
Ein weiteres Hindernis war die Ermöglichung von Echtzeit-Übersetzungen mithilfe fortschrittlicher neuronaler Motoren. Wir mussten sicherstellen, dass die Übersetzungen niedrige Latenzzeiten und hohe Genauigkeit aufwiesen, während wir gleichzeitig eine intuitive Oberfläche entwickelten, die es Benutzern ermöglichte, Sprachen und bevorzugte Stimmen für die Wiedergabe auszuwählen, wobei wir den Benutzerkomfort und die Personalisierung priorisierten. Schließlich entwickelten wir einen Audio-Vorlagen-Ersteller-Assistenten mit mehreren anpassbaren Player-Ansichten, der es Benutzern ermöglichte, einzigartige, visuell ansprechende Player zu entwerfen, die auf ihre Webseiten zugeschnitten sind. Die Balance zwischen Flexibilität, Leistung und Benutzerfreundlichkeit über verschiedene Geräte hinweg war eine lohnende Herausforderung.
Mit Echtzeit-Übersetzungen in 70 Sprachen und über 230 natürlichen Stimmen. Wie stellen Sie sicher, dass die Stimmenqualität und die Genauigkeit über ein so vielfältiges Sprachspektrum hinweg aufrechterhalten werden?
Um eine konsistente Stimmenqualität zu gewährleisten, integrieren wir mehrere fortschrittliche Text-to-Speech-Modelle, die kontinuierlich optimiert und aktualisiert werden. Diese mehrsprachigen Motoren können gemischte Sprachinhalte mit hoher Genauigkeit verarbeiten. Wir rollen auch über 100 neue Stimmen-Varianten aus, um den Benutzern noch mehr ausdrucksstarke und natürliche Klangoptionen zu bieten. Jeden Monat generiert GSpeech über 200 Millionen Zeichen Audio, um Benutzern in über 70 Ländern zu dienen, und unsere Online-Player werden monatlich über 200.000 Mal verwendet – und wachsen weiter. Diese Größe stellt sicher, dass wir kontinuierlich Feedback und Echtzeit-Tests erhalten, die direkt unsere Feinabstimmung und Qualitätskontrollen beeinflussen.
Können Sie uns durch die Art und Weise führen, wie GSpeech KI und maschinelles Lernen nutzt, um lebensnahe Stimmen-Synthese zu liefern? Wie halten Sie Schritt mit den rasanten Fortschritten in der neuronalen Stimmen-Technologie?
GSpeech nutzt fortschrittliche KI und maschinelles Lernen, indem es mehrere state-of-the-art-Text-to-Speech-Modelle integriert, um lebensnahe Stimmen-Synthese zu erzeugen. Diese Modelle, die für Natürlichkeit und Mehrsprachigkeit optimiert sind, verarbeiten Texteingaben, um hochwertiges Audio mit realistischer Intonation und Rhythmik zu generieren, sogar für gemischte Sprachinhalte. Wir verbessern die Benutzererfahrung, indem wir anpassbare Stimmen-Stile für verschiedene Sprachen anbieten. Wir haben auch TTS-Aliase integriert, die es Benutzern ermöglichen, benutzerdefinierte Regeln für die Wiedergabe bestimmter Wörter oder Phrasen im Audio festzulegen – beispielsweise durch Ersetzen bestimmter Begriffe, um eine genauere Aussprache oder Phrasierung zu erreichen. Um mit den Fortschritten in der neuronalen Stimmen-Technologie Schritt zu halten, bewerten wir kontinuierlich die neuesten Entwicklungen, arbeiten mit Branchenführern zusammen und planen, in Zukunft eigene Modelle zu entwickeln, um sicherzustellen, dass GSpeech an der Spitze der Stimmen-Synthese-Innovation bleibt.
Wie wichtig sind Stimmen-Feinabstimmung, Tonhöhenkontrolle und Wiedergabe-Anpassung für Ihre Benutzer – und welches ist das Einsatzszenario, auf das Sie am meisten stolz sind, in dem diese Funktionen wirklich glänzen?
Stimmen-Feinabstimmung, Tonhöhenkontrolle und Wiedergabe-Anpassung sind für unsere Benutzer von entscheidender Bedeutung, da sie es ihnen ermöglichen, einzigartige, hochwertige Stimmen-Stile zu erstellen, die auf ihre spezifischen Bedürfnisse zugeschnitten sind, von News- und Blog-Webseiten bis hin zu zugänglichen E-Learning-Inhalten. Die laufende Integration von über 100 neuen Stimmen-Varianten verbessert dies noch weiter, indem sie den Benutzern eine beispiellose Flexibilität bietet, um wirklich einzigartige Voiceovers zu erstellen. Ich bin am meisten stolz auf GSpeech Studio, eine neue Audio-Bearbeitungs- und -Generierungsplattform, die ich entwickle. Sie ermöglicht es Benutzern, mehrere Audio-Kanäle zu erstellen, sie mit Hintergrundmusik zu mischen und polierte Voiceovers zu exportieren, um Kreativen zu ermöglichen, professionelle Audio-Inhalte für verschiedene Anwendungen zu produzieren. Ein Brief eines sehbehinderten Schülers, der GSpeech dankt, weil es ihm ermöglicht, unabhängig zu studieren, hat mich tief berührt. Dieses Einsatzszenario zeigt, wie diese Funktionen Inhalte zugänglicher und transformierender machen, ein Ziel, das ich seit meinen frühen Programmier-Tagen verfolge.
GSpeech bietet nahtlose Integrationen mit WordPress, Shopify , Wix und mehr. Was war Ihre Strategie, um die Plattform für Ersteller und Unternehmen in verschiedenen Ökosystemen plug-and-play zu machen?
Unsere Strategie für die GSpeech-Integrationen mit Plattformen wie WordPress, Shopify und Wix konzentrierte sich auf Einfachheit, Kompatibilität und Skalierbarkeit. Wir entwickelten leichtgewichtige, modulare Plugins und Code-Snippets, die nahtlos integriert werden können, oft nur durch einige Klicks. Dies bedeutet, dass Tausende von Artikeln und dynamischen Inhalten sofort Sprachunterstützung erhalten können – ohne manuelle Anstrengung. Wir bieten hochflexible, schön gestaltete Player, die sich über verschiedene Geräte hinweg anpassen, einschließlich Mobilgeräten, Tablets und Desktop-Computern. Unsere Player sind nicht nur anpassbar, sondern auch für Zugänglichkeit und Benutzerengagement optimiert. Für WordPress haben wir das GSpeech-Cloud-Dashboard direkt in das Admin-Panel über unser Plugin integriert, um die Verwaltung für Benutzer zu vereinfachen. Detaillierte Dokumentation und intuitive Dashboards führen nicht-technische Benutzer durch die Installation und Anpassung. Regelmäßige Tests stellen konsistente Leistung über verschiedene Ökosysteme hinweg sicher, um Kreativen und Unternehmen zu ermöglichen, KI-gesteuerte Text-to-Speech-Funktionen mühelos hinzuzufügen.
Blicken Sie zurück auf die Reise von 2012 bis heute, was war der größte Meilenstein für Sie persönlich oder beruflich bei der Entwicklung von GSpeech?
Der größte Meilenstein für GSpeech war die Generierung von 1 Milliarde Zeichen hochwertigem KI-Audio, was unsere globale Auswirkung auf die Zugänglichkeit unterstreicht. Ebenso bedeutend war das Feedback, das wir von Organisationen wie der Humanity Union erhalten haben, die GSpeech für die Verbesserung ihrer Plattform für soziale Verantwortung gelobt haben, und von Blog-Besitzern, die es als “Spielveränderer” für die Benutzerbindung bezeichneten. Über 110 Fünf-Sterne-Bewertungen auf Plattformen wie WordPress und AppSumo in den letzten Monaten spiegeln dies wider.
GSpeech wird jetzt auch aktiv von der Namangan regionalen Statistikabteilung in Usbekistan – einer Regierungsbehörde mit erheblichem Verkehr und nationaler Sichtbarkeit – verwendet. Die Tatsache, dass eine öffentliche Einrichtung unsere Technologie so umfassend angenommen hat, ist ein bedeutender Meilenstein und ein starker Beweis für das Vertrauen in unsere Lösung.
Als Christ und jemand, der in der armenischen Kirche dient, versuche ich auch, andere kirchliche Initiativen zu unterstützen, wo immer möglich. Ich biete GSpeech oft kostenlos an christlichen Webseiten an, um ihnen zu helfen, ihre Botschaft effektiver zu verbreiten und die Heilige Schrift durch Audio zugänglicher zu machen. Es ist mein kleiner Beitrag zu etwas Größerem. Gleichzeitig bin ich geehrt, mit engagierten Ministern wie The Cord – einer messianischen Gemeinde und geschätzten GSpeech-Kunden – zusammenzuarbeiten, deren Mission und Inhalt die Kraft der Heiligen Schrift in Aktion widerspiegeln.
Diese Momente – wenn Technologie zu einer Brücke für Glauben, Verständnis und Inklusion wird – erinnern mich daran, warum wir GSpeech überhaupt entwickelt haben.
Welche Rolle sehen Sie GSpeech in der Zukunft der digitalen Medien spielen, insbesondere wenn Audio-Inhalte und Sprach-Schnittstellen immer dominanter werden?
Ich sehe GSpeech als Vorreiter bei der Erstellung digitaler Medien, die zugänglicher und ansprechender sind, indem es KI-gesteuerte Sprach-Zugriff auf das Web ermöglicht. Unser Ziel ist es, die gesamte Online-Erfahrung zu transformieren, sodass Webseiten von Natur aus sprachinteraktiv, inklusiv und mehrsprachig werden. Mit nur einer Codezeile können Seitenbesitzer Tausende von Artikeln in gesprochene Inhalte umwandeln. Im Hinblick auf die Zukunft entwickeln wir GSpeech Studio zu einer leistungsstarken und einzigartigen Plattform für Audio-Generierung und -Bearbeitung, die es Benutzern ermöglicht, mehrschichtige Audio-Inhalte mit Hintergrundmusik, Effekten und präziser Feinabstimmung zu erstellen. Wir möchten das Web wirklich hörbar, intuitiv und universell zugänglich machen.
GSpeech wurde kürzlich auf AppSumo veröffentlicht und hat bereits eine nahezu perfekte Bewertung von frühen Anwendern erhalten. Was bedeutet die Resonanz der AppSumo-Community für Sie, und wie planen Sie, auf dieser Dynamik aufzubauen?
Der AppSumo-Start stellte GSpeech Millionen von Menschen vor, und die nahezu perfekte Bewertung ist unglaublich bestätigend. Benutzer, wie diejenigen, die Online-Kurse betreiben, loben unsere intuitiven Tools und unsere reaktionsfreudige Unterstützung, was das Feedback der Humanity Union widerspiegelt. Ein Blog-Besitzer nannte unsere Stimmen “genuin ansprechend” und die Übersetzungen “beeindruckend”. Ihr positives Feedback bestätigt den Wert unserer KI-gesteuerten Text-to-Speech-Lösung und feuert meine Leidenschaft für das Projekt an. Die Unterstützung von Kunden während des Starts hat auch neue Ideen angeregt, insbesondere für GSpeech Studio, das durch Benutzeranfragen für erweiterte Audio-Bearbeitungs- und Export-Funktionen inspiriert wurde. Im Hinblick auf die Zukunft plane ich, auf dieser Dynamik aufzubauen, indem ich aktiv auf unsere Community höre, ihr Feedback integriere und innovative Funktionen entwickle, um Zugänglichkeit und Engagement zu verbessern, um sicherzustellen, dass GSpeech weiterhin als transformierendes Werkzeug für Kreative und Unternehmen evolviert.
Zum Schluss, was raten Sie jungen Entwicklern oder Unternehmern, die zugängliche, KI-gesteuerte Werkzeuge in der heutigen sich schnell bewegenden Technologie-Landschaft entwickeln möchten?
Jungen Entwicklern und Unternehmern rate ich, ihr Herz in ihre Arbeit zu legen und ein reales Problem zu identifizieren, bei dem sie eine einzigartige, intelligente Lösung anbieten können. Fangen Sie klein an, gehen Sie schrittweise vorwärts und hören Sie genau auf das Feedback der Kunden – sie werden Ihren Weg weisen. Behandeln Sie Ihre Benutzer wie vertrauenswürdige Freunde, geben Sie Ihr Bestes und bleiben Sie geduldig. Nutzen Sie KI-Technologien als mächtige Verbündete; wenn sie weise eingesetzt werden, verstärken sie Ihre Fähigkeit, wirksame, zugängliche Werkzeuge zu erstellen. Bauen Sie mit Leidenschaft, Ausdauer und dem Engagement, einen Unterschied zu machen, und Sie werden Lösungen schaffen, die wirklich zählen.
Vielen Dank für das großartige Interview, wir haben uns für die GSpeech-Lösung für unsere Website entschieden, weil sie leicht zu integrieren ist. Um mehr zu erfahren, besuchen Sie GSpeech.


