
Interviews
Ron Reiter, CTO und Mitgründer von Sentra – Interview-Serie

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
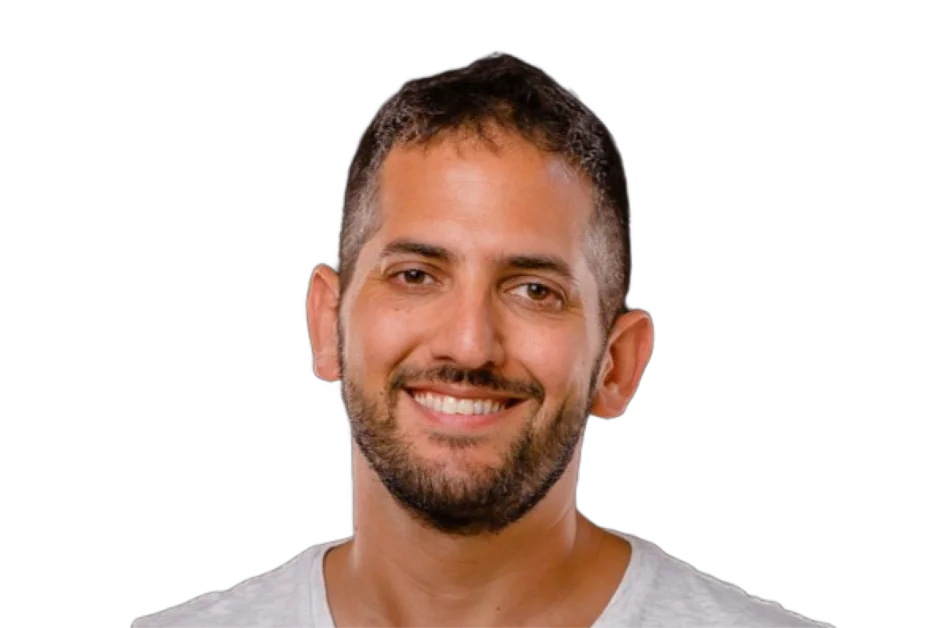
Ron Reiter, CTO und Mitgründer von Sentra, ist ein erfahrener Unternehmer und Cybersicherheitsexperte mit tiefen Kenntnissen in der Cloud, der innovative Technologielösungen während seiner mehr als zwei Jahrzehnte langen Karriere im Softwareentwicklungsbereich entwickelt hat; er gründete und leitet die Technologie bei Sentra, einem Daten-Cybersicherheitsunternehmen, das sich auf die Unterstützung von Unternehmen bei der Sicherung ihrer Cloud-Daten konzentriert, und gründete zuvor Crosswise (das von Oracle (ORCL ) für 50 Mio. US-Dollar übernommen wurde), während er auch über sechs Jahre als technischer Leiter bei Oracle/Crosswise tätig war und die Oracle Data Cloud-Produkte und -Teams beaufsichtigte.
Sentra ist eine cloudbasierte Daten-Sicherheitsplattform, die AI-gesteuerte Entdeckung, Klassifizierung und kontextuelle Analyse verwendet, um Organisationen eine vollständige Sichtbarkeit und Kontrolle über sensible Daten in Cloud-, Hybrid- und On-Premises-Umgebungen zu geben, ihnen dabei hilft, Risiken zu bewerten, Governance durchzusetzen, Compliance zu erfüllen und Datenexpositionen im großen Maßstab über moderne Multi-Cloud- und AI-Workflows zu verhindern.
Sie haben mehrere Unternehmen im Bereich Cybersicherheit und Daten-Infrastruktur gegründet. Was hat Sie dazu inspiriert, Sentra zu gründen, und wie hat Ihre Erfahrung bei Crosswise und Oracle die frühe Richtung des Unternehmens beeinflusst?
Was mich dazu gebracht hat, Sentra zu gründen, war ein Muster, das ich immer wieder sah. Bei Crosswise und später bei Oracle war Daten immer der Mittelpunkt. Dort lebte der Wert, aber auch das Risiko. Die meisten Sicherheitstools behandelten Daten jedoch als etwas Statisches, etwas, das man einmal entdeckt und dann als unter Kontrolle annimmt.
Als die Cloud-Adoption beschleunigte und Unternehmen begannen, mit AI zu experimentieren, hielt diese Annahme nicht mehr. Daten bewegten sich ständig, wurden kopiert, transformiert und von Systemen zugänglich gemacht, die niemand vollständig verfolgte. Ich wollte ein Unternehmen aufbauen, das mit Daten als lebendigem Vermögen begann, etwas, das man kontinuierlich versteht und regiert, anstatt etwas, das man einmal inventarisiert und dann vergisst. Diese Idee prägte Sentra von Anfang an.
Sentra konzentriert sich darauf, Organisationen eine vollständige Kontrolle und Sichtbarkeit über ihre Cloud-Daten zu geben. Welches Kernproblem wollten Sie am meisten lösen, als Sie die Plattform entwickelten?
Das Kernproblem war falsches Vertrauen. Viele Organisationen glaubten, sie verstünden ihre Datenlage, aber dieses Vertrauen basierte auf partieller Sichtbarkeit. Sie wussten, wo einige sensible Daten lagen, aber nicht alle, und sie hatten selten ein klares Bild davon, wie diese Daten zugänglich gemacht oder wiederverwendet wurden.
Wir setzten uns das Ziel, diese Lücke zu schließen. Nicht nur, indem wir Daten entdecken, sondern indem wir ein kontinuierliches Verständnis dafür entwickeln, welche Daten existieren, wie sensibel sie sind und wer oder was Zugriff darauf hat. Ohne diese Grundlage wird alles andere in der Sicherheit reaktiv.
Sie haben die Bedeutung von Genauigkeit in der modernen Daten-Sicherheit betont. Was macht es so schwierig, eine hohe Genauigkeit bei großer Cloud-Skala zu erreichen, und wie hat Ihr Team dieses Problem anders angegangen?
Genauigkeit wird bei großer Skala schwierig, weil Kontext wichtig ist. Wenn Umgebungen wachsen, werden Daten unstrukturierter und spezifischer für die Art und Weise, wie ein Unternehmen tatsächlich operiert. Einfaches Mustererkennen und allgemeine Modelle funktionieren vernünftig in kleineren Umgebungen, brechen aber zusammen, wenn Datenmengen wachsen und Anwendungsfälle komplexer werden.
Wir sahen dies bei Unternehmensbewertungen, bei denen die Genauigkeit nachließ, wenn Kunden von Zehnern von Terabyte auf Petabyte unstrukturierter Daten umstellten. Unser Ansatz bestand darin, die Klassifizierung um Kontext herum zu entwerfen und bei der Effizienz diszipliniert zu sein. Genauigkeit, die nur bei kleiner Skala funktioniert oder exzessive Rechenleistung erfordert, ist in realen Unternehmensumgebungen nicht nützlich.
Das Scannen und Sichern von Daten in verteilten Cloud-Umgebungen ist bekanntermaßen schwierig. Welche architektonischen Entscheidungen ermöglichen es Sentra, effizient über mehrere Clouds und Daten-Speicher zu operieren?
Wir gingen von Anfang an davon aus, dass Kunden über mehrere Clouds, SaaS-Plattformen und Hybrid-Umgebungen operieren würden. Das zwang uns, Designs zu vermeiden, die von intensivem Datenverschieben oder ständigen vollständigen Neu-Scans abhängig sind, was bei wachsenden Umgebungen nicht gut funktioniert.
Stattdessen konzentrierten wir uns darauf, Sichtbarkeit aufrechtzuerhalten, während Umgebungen sich ändern, und unnötigen Overhead zu minimieren. Diese Designentscheidung zeigt sich in Zuverlässigkeit und Kostenvorhersehbarkeit, insbesondere in großen, komplexen Umgebungen.
Wenn Unternehmen dezentralisierte Architekturen, autonome AI-Systeme und zunehmend komplexe Datenflüsse einführen, welche neuen Kategorien von Daten-Sicherheitsrisiken glauben Sie, dass Unternehmen immer noch unterschätzen?
Der größte Blindpunkt ist der nicht-menschliche Zugriff. AI-Agents, Integrationen und automatisierte Workflows greifen kontinuierlich auf sensible Daten zu, oft außerhalb der Kontrollen, die für menschliche Benutzer entwickelt wurden.
Diese Systeme melden sich nicht auf die gleiche Weise an wie Menschen, und sie lösen keine herkömmlichen Warnungen aus. Sie als einfach einen weiteren Benutzer zu behandeln, ist ein Fehler. Unternehmen müssen verstehen, auf welche Systeme diese Systeme zugreifen können, und sicherstellen, dass diese Berechtigungen mit der Absicht übereinstimmen, andernfalls wächst das Risiko schneller, als Teams reagieren können.
Sentra verwendet einen modellgetriebenen Ansatz, um sensible Daten zu klassifizieren und zu sichern. Wie balancieren Sie Modellleistung, Betriebskosten und Skalierbarkeit, wenn Sie für Unternehmens-Workloads bauen?
Das Gleichgewicht kommt von der bewussten Verwendung von Modellen. Nicht jedes Problem erfordert das größte oder allgemeinste Modell. Wir konzentrieren uns auf die Verwendung kleiner Sprachmodelle (SLMs), die für Klassifizierungsaufgaben gut geeignet sind und in großen Umgebungen effizient arbeiten können.
Dadurch können wir eine starke Genauigkeit beibehalten, während wir die Betriebskosten niedrig und vorhersehbar halten. Für Unternehmens-Sicherheitsteams sind Konsistenz und Zuverlässigkeit ebenso wichtig wie rohe Leistung.
Was ist der größte Irrtum, den Sie bei CISOs über die Sicherung von Cloud-Daten im Zeitalter von AI sehen, und wie sollten ihre Strategien sich entwickeln?
Ein häufiger Irrtum ist, dass die einmalige Entdeckung von Daten ausreicht. In Wirklichkeit ändern sich Cloud- und AI-Umgebungen ständig. Daten bewegen sich, Berechtigungen ändern sich, und neue Systeme kommen jede Woche online.
Strategien müssen sich von periodischen Bewertungen zu kontinuierlicher Governance verschieben. Das bedeutet, Daten-Sicherheit als kontinuierliche Disziplin und nicht als Projekt zu behandeln. Das Ziel ist nicht nur, Risiken zu finden, sondern auch zu verhindern, dass Risiken wieder auftauchen, während sich die Umgebung entwickelt.
Daten-Sicherheits-Posture-Management (DSPM) ist zu einer zentralen Schicht der modernen Cloud-Sicherheits-Architektur geworden. Welche Merkmale definieren Ihrer Meinung nach eine wirklich reife DSPM-Plattform?
Eine reife DSPM-Plattform tut drei Dinge gut. Sie muss Daten genau verstehen, sie muss zuverlässig in großen Skalen arbeiten und sie muss Handlungen und nicht nur Berichte unterstützen.
Was wir derzeit sehen, ist, dass viele Plattformen in POVs oder frühen Bereitstellungen stark aussehen, aber bei wachsenden Umgebungen und dynamischeren Zugriffsmustern Schwierigkeiten haben. Scans verlangsamen sich, Kosten steigen, und die Genauigkeit verschlechtert sich, insbesondere bei unstrukturierten Daten. Eine reife DSPM-Plattform ist eine, der Sicherheitsteams auch bei Produktions-Skalen und kontinuierlichem Zugriff von AI-Systemen auf Daten vertrauen. Vertrauen in der Skala ist das, was zwischen verwendbaren Plattformen und theoretischen unterscheidet.
Sie haben auch in mehrere Cybersicherheits-Startups investiert. Aus dieser Perspektive, was unterscheidet Ihrer Meinung nach Gründer, die in dieser Branche erfolgreich sind, von denen, die kämpfen?
Die Gründer, die erfolgreich sind, sind sehr nah an den realen Schmerzpunkten der Kunden. Sie widerstehen der Versuchung, nach Modewörtern zu jagen oder für Randfälle zu überbauen, und konzentrieren sich stattdessen darauf, Probleme zu lösen, die sich in Produktionsumgebungen wiederholen.
Sie denken auch frühzeitig an Nachhaltigkeit. In der Sicherheit ist es leicht, ein Proof-of-Concept zu gewinnen. Zuverlässig über Jahre hinweg in großen Skalen zu arbeiten, ist viel schwieriger. Gründer, die von Anfang an für diese Realität entwerfen, neigen dazu, länger zu überleben.
Wie erwarten Sie, dass sich die Anforderungen an die Daten-Sicherheit in den Jahren 2026 und darüber hinaus ändern werden, wenn Unternehmen dezentralisierte Architekturen, autonome AI-Systeme und zunehmend komplexe Datenflüsse einführen?
Die Daten-Sicherheit wird sich von der Sicherung von Orten zur Regulierung von Bewegungen verlagern. Wenn Architekturen dezentralisiert werden und AI-Systeme autonom handeln, wird die Frage nicht mehr sein, wo Daten gespeichert sind, sondern wie sie fließen und wer oder was sie nutzen kann.
Unternehmen werden kontinuierliche Sichtbarkeit und Richtlinien-Durchsetzung benötigen, die mit den Daten selbst reist. Diejenigen, die dies nicht erreichen können, werden ihre AI-Initiativen durch Risiken und Compliance-Bedenken verlangsamen. Diejenigen, die es können, werden schneller vorankommen, mit Vertrauen.
Vielen Dank für das großartige Interview. Leser, die mehr erfahren möchten, sollten Sentra besuchen.


