
Interviews
Ofir Mulla, Mitgründer und CTO von Lumana – Interview-Serie

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
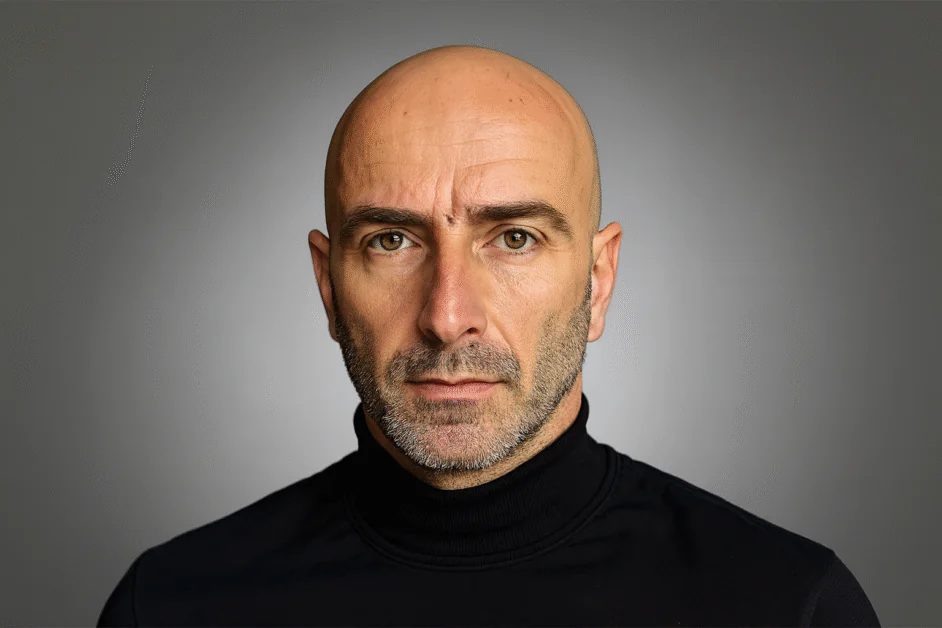
Ofir Mulla, Mitgründer und CTO von Lumana, bringt über ein Jahrzehnt tiefe Expertise in 3D- und Computer-Vision-Technologien mit, nachdem er Lösungen in den Bereichen coded-light, Stereo und LiDAR entwickelt und skaliert hat, während er die interdisziplinäre Entwicklung in Software, elektrischen Systemen, Robotik, ML/AI und Medizinprodukten leitete. Vor seiner aktuellen Position bei Lumana verbrachte er fast 15 Jahre bei Intel (INTC ), wo er die RealSense-3D-Plattform architektierte und Teams aus Hardware, Firmware und Systemarchitektur leitete.
Lumana ist ein fortschrittliches Video-Sicherheits- und visuelles Intelligenzunternehmen, dessen Plattform bestehende Kameras in intelligente, wahrnehmende Agenten umwandelt, indem sie KI nutzt, um realweltliche Ereignisse in Echtzeit zu erkennen und zu reagieren – von unbefugtem Zugriff und Sicherheitsverletzungen bis hin zu betrieblichen Erkenntnissen – und es Unternehmen in den Bereichen Bildung, Regierung, Einzelhandel, Fertigung und Gastgewerbe ermöglicht, Kameras zu integrieren, Überwachung zu automatisieren und handlungsfähige Analysen aus ihrer Video-Infrastruktur zu gewinnen.
Wie haben Ihre Erfahrungen bei Intel Sie auf Lumana und die Gründung des Unternehmens vorbereitet?
LiDAR-Technologie war ein Kernbestandteil von RealSense, einer aktiven Methode, Laserlicht zu projizieren, um die Geometrie der Welt zu erfassen. Es ist eine schöne Technologie aus kodiertem Licht, die unsere brillanten Ingenieure bei Intel erfanden. Geometriesensoren sind für bewegte Objekte wie Roboter und Autos entscheidend, weshalb die meisten Robotersysteme heute auf RealSense-Geräte zurückgreifen.
Aber eine Frage tauchte auf: Was passiert, wenn die Sensoren stationär sind, wo Navigation und Zeit bis zum Aufprall nicht die Hauptaufgaben sind? Wir fragten uns, welche Technologie den größten Nutzen für die Benutzer in diesem Kontext bieten könnte.
Durch tiefe Diskussionen erkannten wir, dass die meisten bestehenden stationären Kamerasysteme nicht natürlich skaliert werden können. Die Überwachung jedes Systems ist umständlich. Gleichzeitig hatte die KI ein Stadium erreicht, in dem wir uns fragten: Wie kann ein erschwingliches System am Kundenstandort die dringendsten, zuverlässigsten Sicherheitsreaktionen auf kritische Alarme liefern?
Wir bauten ein starkes KI-Team auf, das diese Vision schnell in ein funktionierendes Produkt umsetzte. Die Erkenntnis war einfach: Bewegliche Fahrzeuge erfordern geometrische Sensoren, aber stationäre Sensoren, die sich auf das Verhalten konzentrieren, anstatt auf die Bewegungsplanung, profitieren mehr von fortgeschrittener Videoanalyse ohne explizite Geometrierekonstruktion.
Die RealSense-Reise lehrte mich, dass jedes Problem seine eigene Lösung erfordert und wahre Disruption Innovation erfordert. Mein Team bei Lumana verkörpert dieses Prinzip: professionell, innovativ und engagiert. Zusammen haben wir ein On-Premise-System in Echtzeit entwickelt, das Cloud-ähnliche Leistung an den Rand bringt, erschwinglich, skalierbar und reaktionsfähig ist.
Wie geht Physical AI über traditionelle Videoanalyse wie Objekterkennung und Musterkennung hinaus?
Wenn wir von Physical AI sprechen, meinen wir ein KI-System, das nicht bei der Wahrnehmung stoppt, sondern aktiv mit der realen Welt interagiert. Traditionelle Videoanalyse, wie Objekterkennung oder Musterkennung, sind nur die erste Ebene. Die tiefere Herausforderung ist, was danach kommt: Anordnen, Verfolgen, Aggregieren, Identifizieren, Abrufen, Suchen und Verifizieren der erkannten Objekte und Beschleunigen der Reaktion. Dazu gehören auch die Aktivierung von textbasiertem Zugriff und sogar die Suche nach Objekten, die das System ursprünglich nicht erkennen sollte.
All dies muss innerhalb eines kompakten, erschwinglichen Rechengeräts erreicht werden. Das ist der Punkt, an dem Physical AI über traditionelle Analyse hinausgeht: Es verwandelt rohe Erkennung in handlungsfähige, zugängliche Intelligenz. Es geht nicht darum, die Gesetze der Physik zu entdecken, ein wissenschaftliches Vorhaben, das noch diskutiert wird, sondern um praktische, effiziente Wege zu finden, um auf visuelle und audiovisuelle Inhalte in realen Umgebungen zuzugreifen und zu reagieren.
Was sind die technischen Säulen, die es Lumana ermöglichen, Daten aus mehreren Kameras zu fusionieren, Verhalten in Echtzeit zu interpretieren und kontinuierlich basierend auf kontextuellen und historischen Eingaben anzupassen?
Gute Frage. Eine unserer Kernsäulen ist die Fähigkeit des On-Premise-Systems, sich kontinuierlich an die Szene anzupassen, die es beobachtet, was oft als kontinuierliches Lernen bezeichnet wird. Sie können sich das als ein System vorstellen, das mit seiner Umgebung evolviert und sich über die Zeit verbessert. Dieser Ansatz ermöglichte es uns, hohe Leistung bei sehr geringen Kosten und außergewöhnlicher Agilität zu liefern.
Ein weiterer wichtiger Pfeiler ist unsere hierarchische Architektur, die computationallyen Aufwand nur dann eskaliert, wenn dies erforderlich ist. Dies stellt sicher, dass komplexe Aktionen die Ressourcen erhalten, die sie benötigen, ohne das gesamte System zu belasten.
Wenn man diese Prinzipien zusammenfasst, entsteht eine Plattform, die einfach, effizient und hochskalierbar ist und es Benutzern ermöglicht, leistungsstarke Echtzeit-Erkenntnisse und Verhaltensinterpretationen zum niedrigsten möglichen Preis zu erleben.
Können Sie ein oder zwei reale Einsatzszenarien von Lumanas System nennen, in denen Ereignisse wie Gewalteskalation, Sicherheitsverletzungen oder Herumlungern erkannt wurden, und erklären, welche Auswirkungen diese auf die Sicherheit oder betriebliche Reaktion hatten?
Lumana-Einsätze in Städten zeigen deutliche Verbesserungen in Echtzeit-Bewusstsein und Reaktion. In einer großen Stadt in Israel verwandelte das System ein bestehendes Video-Netzwerk in eine intelligente Frühwarnschicht, die Herumlungern in gesperrten Zonen, Menschenansammlungen, Nachteinbrüche und ungewöhnliche Bewegungen erkannte. Dies führte zu weniger Einbrüchen, weniger Vandalismus und schnellerer Intervention in Hochrisikogebieten.
Ein US-amerikanischer Gemeindebezirk sah ähnliche Gewinne in einem historischen Viertel, das mit Vandalismus, Autoeinbrüchen, Störungen und Herumlungern zu kämpfen hatte. Lumana lieferte kontinuierliche Überwachung und sofortige Alarme, die es ermöglichten, proaktive Patrouillen und schnelle Reaktionen durchzuführen. Dies führte zu sichereren öffentlichen Räumen und weniger betrieblichem Aufwand für die Stadt.
Diese Beispiele veranschaulichen, wie die Echtzeit-Erkennung von Verhaltensweisen wie Herumlungern und Sicherheitsverletzungen die öffentliche Sicherheit stärkt und den Betrieb strafft.
Wie sind die Datenschutzsicherheitsmaßnahmen in Ihrem Design- und Einsatzprozess integriert, da KI-Systeme sensibles physisches Verhalten interpretieren?
Lumana-Technologie und -Design betonen starke Governance und minimale Datenbewegung. Die Verarbeitung erfolgt, wenn möglich, am Rand, um die Exposition zu begrenzen und die Privatsphäre zu stärken. Der Zugriff ist durch klare Kontrollen und Audit- Trails eingeschränkt, sodass Teams jeden Arbeitsablauf verfolgen können. Das System hält das Video lokal und teilt nur die notwendigen Metadaten, was die Privatsphäre in regulierten Umgebungen unterstützt.
Diese Sicherheitsmaßnahmen stellen sicher, dass sensible visuelle Daten verantwortungsvoll gehandhabt werden, während die erforderliche Leistung für Echtzeit-Betrieb aufrechterhalten wird.
Was treibt Ihre Hybrid-Cloud-Architektur an, und wie unterstützt sie Echtzeit-Verarbeitung und kontinuierliches Lernen?
Lumana nutzt einen Hybrid-Ansatz, um die Leistung von On-Premise-Systemen mit Cloud-Flexibilität zu kombinieren. Edge-Verarbeitung liefert Echtzeit-KI, Speicher und Video-Management lokal standardmäßig. Dies reduziert die Bandbreitenanforderungen und stärkt die Privatsphäre, während gleichzeitig Cloud-Unterstützung ermöglicht wird, wenn dies für eine breitere Koordination oder Lernen über Einsatzorte hinweg erforderlich ist.
Diese Architektur bietet Benutzern sofortige Reaktionsfähigkeit, während sie die Fähigkeit aufrechterhält, durch kontinuierliche Anpassung über Standorte hinweg zu skalieren und zu verbessern.
Wie wurde die Selbstlernfähigkeit architektiert, und wie verbessert sie sich über die Zeit in Multi-Site-Einsätzen?
Die Architektur unserer Selbstlernfähigkeit basiert auf Skalierbarkeit. Je mehr Standorte wir einsetzen, desto breiter wird unsere Perspektive über die Landschaft der Edge-Geräte. Jede neue Umgebung trägt frische Daten bei, die Vielfalt der Szenarien und Szenen, die das System lernen kann, erweitern.
Unsere kontinuierliche Lernmethodik nutzt diese kollektive Kenntnis. Wenn das System sich über die Einsatzorte hinweg verfeinert, wird der Prozess des Online-Trainings einfacher und effizienter. In praktischer Hinsicht wird die breitere Einsatz, desto schneller und genauer die Anpassung, was zu einem System führt, das sich kontinuierlich über die Zeit hinweg über alle Standorte hinweg verbessert.
Wer sehen Sie als Ihre Hauptkonkurrenten oder Partner in diesem Bereich, und was macht Lumana einzigartig?
Unsere wahre Einzigartigkeit liegt in unseren Menschen. Hinter Lumana steht ein Team von brillanten Ingenieuren und Innovatoren, beginnend mit unserer KI-Gruppe, unterstützt von unseren Cloud-Spezialisten, UX/UI-Designern und gestärkt durch Kundensupport und Vertrieb. Während KI die Rückgrat unserer Technologie bildet, ist es unser menschlicher Motor, der Lumana zum Erfolg treibt. Die Kreativität, Professionalität und Hingabe unseres Teams sind es, was Lumana von anderen unterscheidet, sei es im Wettbewerb oder in der Zusammenarbeit.
Lumana betont „Denken in großen Dimensionen“, „Kundenorientierung“, „Ein Team“ und „Meister deines Handwerks“. Wie operationalisieren Sie diese Werte in der Personalbeschaffung, Produktentwicklung und im täglichen Leben?
Wir stellen Innovatoren ein, die groß denken, Probleme lösen, zusammenarbeiten und sich zum Wachstum verpflichten.
Produktteams entwickeln skalierbare KI mit einer ambitionierten Vision, iterieren über Kundenfeedback, fördern Zusammenarbeit und streben nach Exzellenz.
Tägliche Operationen nutzen agile Methoden, um mutige Ideen zu ermöglichen, Kundenbedürfnisse zu priorisieren, Team-Einheit aufzubauen und professionelle Entwicklung zu unterstützen.
Diese Praktiken treiben Innovation, Kundenerfolg und Auswirkungen in der KI-Video-Sicherheit voran.
Wenn Sie in fünf Jahren nach vorne blicken, wie sehen Sie die Rolle von Lumana in der breiteren KI-Ökosystem-Landschaft, und welche Auswirkungen hoffen Sie, dass Physical AI auf Branchen wie Sicherheit, Fertigung oder Smart Cities haben wird?
Wenn wir fünf Jahre vorausblicken, sehen wir Lumanas Rolle als wichtigen Enabler von praktischer Physical AI über Branchen hinweg. Während das Entschlüsseln der fundamentalen Gesetze der Physik ein wissenschaftliches Rätsel bleibt, konzentrieren wir uns heute auf Kundenwert, indem wir Tools entwickeln, die es Organisationen ermöglichen, die Welt um sie herum besser zu überwachen und zu reagieren, unabhängig von der Anwendung.
Wir unterhalten bereits langfristige Zusammenarbeiten mit medizinischen Zentren und erkunden die Expansion in bewegliche Plattformen wie Robotik und Transport. Im Laufe der Zeit, wenn wir wachsen und skaliert werden, beabsichtigen wir auch, in grundlegende Forschungsfragen zu investieren: Kann KI tiefere Muster in der Natur entdecken oder sogar helfen, neue Theorien über die Gesetze der Physik zu formulieren? Könnten Konzepte wie die Dimensionalität der Zeit durch Lernsysteme erhellt werden?
Unsere Ambition ist es, Auswirkungen auf Sicherheit, Fertigung und Smart Cities zu haben, während wir den größeren Horizont im Auge behalten und die Grenzen dessen, was KI letztendlich helfen kann, zu entdecken, erweitern.
Vielen Dank für das großartige Interview. Leser, die mehr erfahren möchten, sollten Lumana besuchen: Lumana.


