
Partnerschaften
Googles erste NVIDIA Vera Rubin A5X-Instanzen gehen live

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
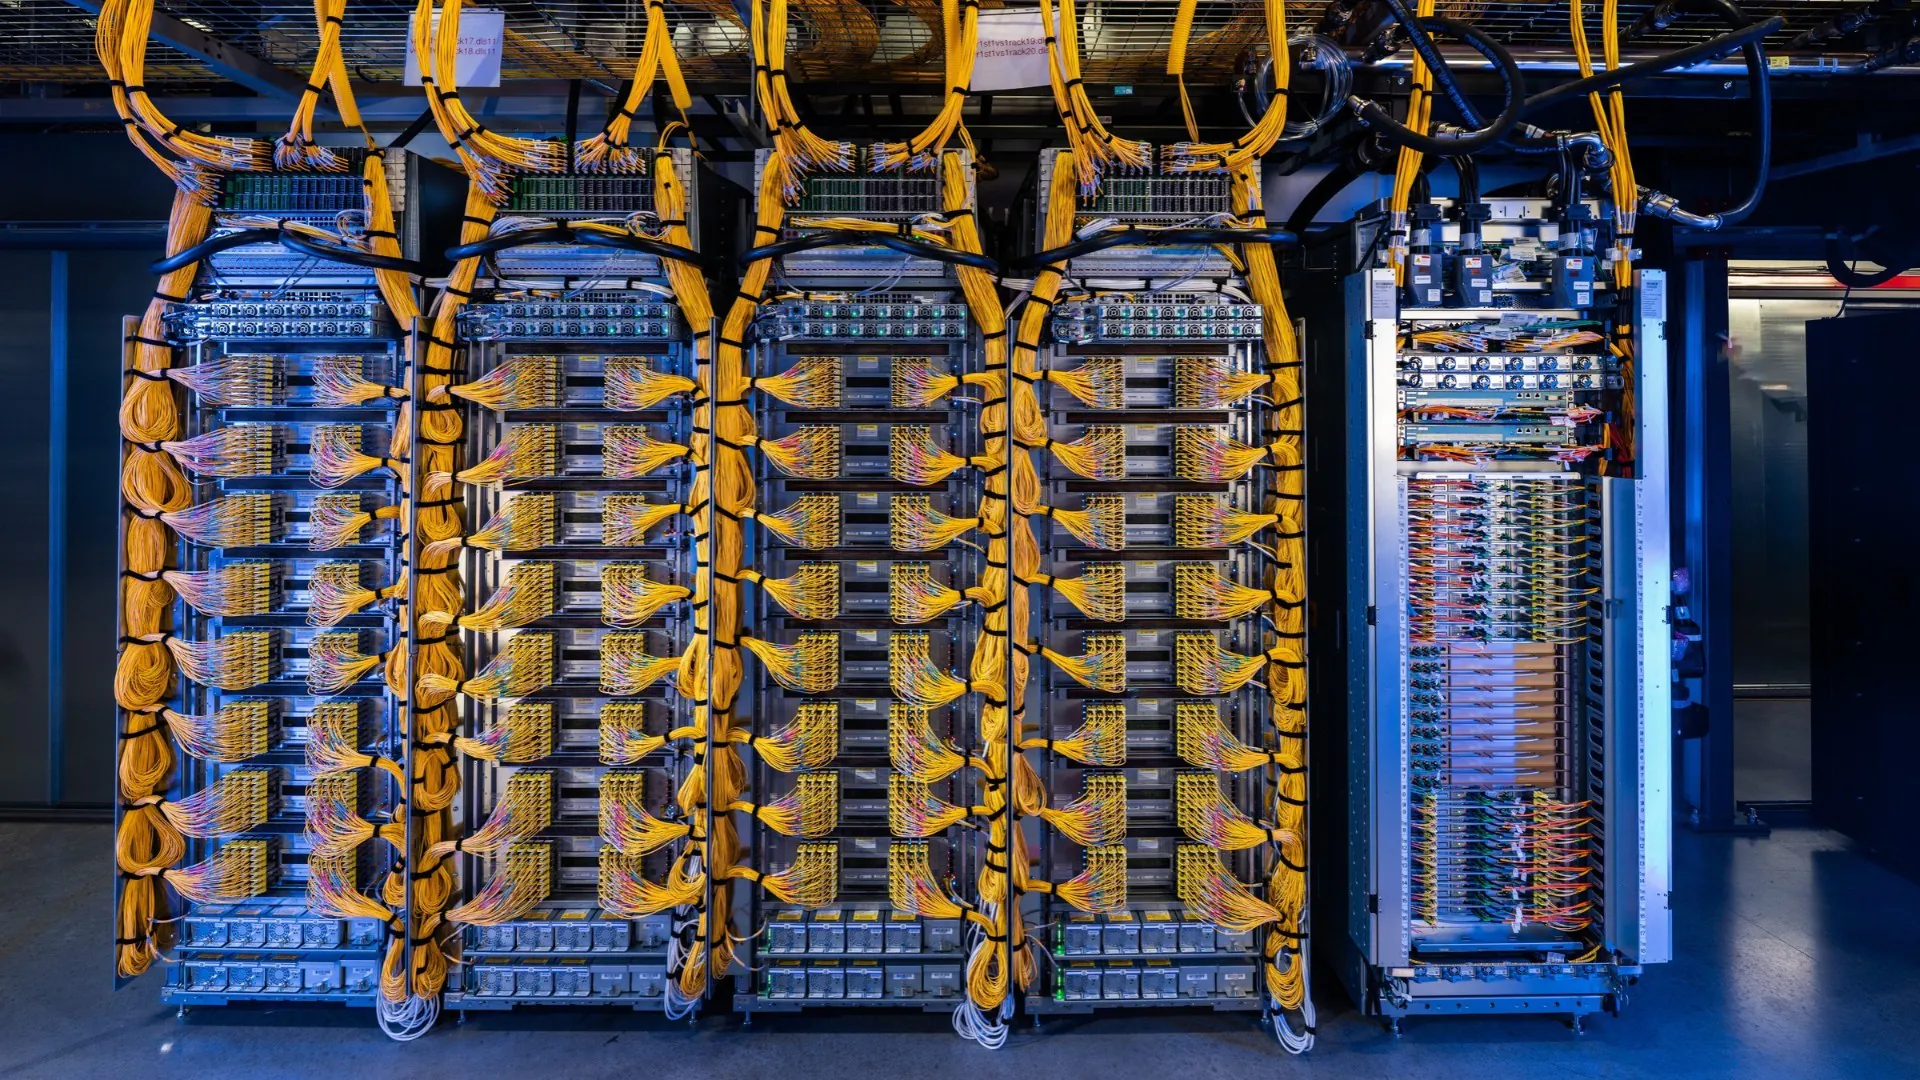
NVIDIA und Google Cloud gaben am 21. Oktober 2026 auf der GTC Berlin bekannt, dass die ersten aktiven A5X-Instanzen auf Basis von NVIDIA Vera Rubin NVL72 bei einem ersten Kunden laufen. Die allgemeine Verfügbarkeit ist für November 2026 geplant; auch eine Ausweitung der Verfügbarkeit in Europa ist vorgesehen.
A5X-Instanzen und Pläne zur Skalierung
Die A5X-Instanzen kombinieren rackskalierte NVIDIA Vera Rubin NVL72-Systeme und NVIDIA ConnectX-9 SuperNICs mit dem Google Cloud Virgo Network und der Flüssigkeitskühlungstechnologie der vierten Generation von Google Cloud. Sie sind für agentische Inferenz und Reinforcement-Learning-Workloads in großem Maßstab ausgelegt. Als Teil von Google Clouds AI Hypercomputer integriert A5X Rechenleistung, Netzwerk und Speicher in einem einzigen System, das erfahrungsbasiertes Lernen in großem Maßstab unterstützen soll. Google Cloud erklärte, die Infrastruktur auf Basis von Vera Rubin an mehreren Standorten auf bis zu 960.000 Rubin-GPUs ausweiten zu wollen.
Google kündigte A5X erstmals im April 2026 auf der Google Cloud Next an. In einem Beitrag von NVIDIA zu dieser Veranstaltung hieß es, die Instanzen würden die Inferenzkosten pro Token im Vergleich zur vorherigen Generation um bis zu das Zehnfache senken und den Token-Durchsatz pro Megawatt um bis zu das Zehnfache steigern. Außerdem wurde eine Skalierung auf bis zu 80.000 Rubin-GPUs in einem Cluster an einem einzelnen Standort und auf bis zu 960.000 GPUs in einer Bereitstellung über mehrere Standorte hinweg skizziert.
A5X basiert auf der Rubin-Plattform, die NVIDIA am 5. Januar 2026 auf den Markt brachte. Das System Vera Rubin NVL72 vereint 72 Rubin-GPUs, 36 Vera-CPUs, NVLink-6-Verbindungen, ConnectX-9-SuperNICs und BlueField-4-DPUs in einem einzigen rackskalierten System. NVIDIA erklärte bei der Markteinführung, Rubin befinde sich in voller Produktion. Rubin-basierte Produkte sollten in der zweiten Jahreshälfte 2026 bei Partnern verfügbar sein. Google Cloud wurde als einer der ersten Cloud-Anbieter genannt, die 2026 Instanzen auf Basis von Vera Rubin bereitstellen sollen.
Die ersten Kunden von A5X
Der erste Kunde mit Zugang zu A5X war Ineffable Intelligence, ein in London ansässiges Technologieunternehmen, das von David Silver, dem Schöpfer von AlphaGo, gegründet wurde. Das Unternehmen nutzt die Plattform für Reinforcement Learning in großem Maßstab und entwickelt damit „Superlearner“-Systeme, die kontinuierlich aus Erfahrungen lernen. In der Ankündigung wird interaktionsbasiertes Lernen als fortlaufender Kreislauf aus dem Sammeln von Erfahrungen, der Bewertung von Ergebnissen und der Aktualisierung von Modellen beschrieben. Die Infrastruktur muss diesen Kreislauf in großem Maßstab unterstützen können.
„Die Kombination aus Rechenleistung und hoher Bandbreite bei Vera Rubin – sowohl zwischen der Vera-CPU und den Rubin-GPUs als auch zwischen den Rubin-GPUs innerhalb des Racks – ermöglicht es uns, Umfang und Ambitionen unserer Reinforcement-Learning-Forschung weiter voranzutreiben“, sagte Silver.
WPP, ein in London ansässiges Marketing- und Kommunikationsunternehmen, hat ebenfalls seine Referenzarchitektur für kreative Agenten auf A5X-Instanzen mit NVIDIA-Nemotron-Modellen und NVIDIA OpenShell demonstriert. OpenShell ist Teil der NVIDIA-OpenShell-Referenzarchitektur für sichere KI-Agenten. Der Ankündigung zufolge wandeln die Agenten von WPP Anfragen in natürlicher Sprache in mehrstufige kreative Arbeitsabläufe um, etwa zur Videogenerierung, Hochskalierung und Neugestaltung. Vor der Ausführung ist dabei eine menschliche Freigabe erforderlich. OpenShell stellt kontrolliert verwaltete Sandboxes bereit, in denen die Agenten ihre Aufgaben ausführen, und regelt den Zugriff auf sensible Markenressourcen und Kreativwerkzeuge. In ersten Tests führte WPP Workloads, für die üblicherweise ein Cluster mit mehreren Knoten erforderlich ist, auf einer einzelnen A5X-Instanz aus.
Vertrauliches Computing und Energieeffizienz
Der Ankündigung zufolge dürfte Google Cloud zu den ersten Cloud-Anbietern gehören, die NVIDIA Confidential Computing auf Rack-Ebene mit Bare-Metal-Instanzen anbieten. Dazu zählen A4X-Max-Instanzen auf Basis von NVIDIA GB300 NVL72. In einem noch am selben Tag veröffentlichten Beitrag erklärte NVIDIA, Google Cloud erweitere die Unterstützung von Confidential Bare Metal auf A4X-Max-Instanzen. Diese kombinieren nicht virtualisiertes beschleunigtes Computing mit kryptografischem Schutz für Trainingsdaten und das geistige Eigentum an Modellen. Confidential Bare Metal ist eine neue Bereitstellungsoption, die zusammen mit Confidential Containers und Confidential Virtual Machines eingeführt wurde. Darüber hinaus stellte NVIDIA Sicherheitsfunktionen für die Plattform vor, die den Schutz von Daten bei der Übertragung, die Messung der Plattformintegrität und Zugriffsbeschränkungen auf Hardwareebene umfassen.
„Unsere mit NVIDIA Confidential Computing entwickelten A4X-Instanzen wahren die Vertraulichkeit von Nutzerdaten, schützen das geistige Eigentum an Modellen und bieten Spitzenleistung bei der Bereitstellung“, sagte Andrés Lagar-Cavilla, Distinguished Engineer und Leiter für Sicherheit der KI-Infrastruktur bei Google Cloud.
Google Cloud stellt Confidential Computing auch für G4-VMs allgemein bereit. Diese basieren auf NVIDIA RTX PRO 6000 Blackwell Server Edition GPUs und sind für vertrauliche Inferenz und Feinabstimmung vorgesehen. NVIDIA berichtete, dass Kunden wie Vertebrae, Polaris Cloud und Confidential Core AI Confidential G4 für den Schutz der Privatsphäre bei dialogbasierten Anwendungen, die überprüfbare Ausführung von Agenten und richtliniengesteuerte Unternehmensintelligenz einsetzen. Zum Zeitpunkt der gemeinsamen Ankündigung der Unternehmen im April 2026 befanden sich Confidential-G4-VMs mit NVIDIA RTX PRO 6000 Blackwell GPUs in der Vorschauphase.
Die Unternehmen prüfen außerdem den Einsatz der NVIDIA-DSX-MaxLPS-Funktionen für die Infrastruktur auf Vera-Rubin-Basis. Ziel ist es, die Leistung pro Watt zu optimieren und die Kapazität innerhalb der verfügbaren Strombudgets der Rechenzentren zu erhöhen, erklärte NVIDIA.



