
Interviews
Gil Elbaz, Mitgründer und CTO von Datagen – Interviewreihe

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
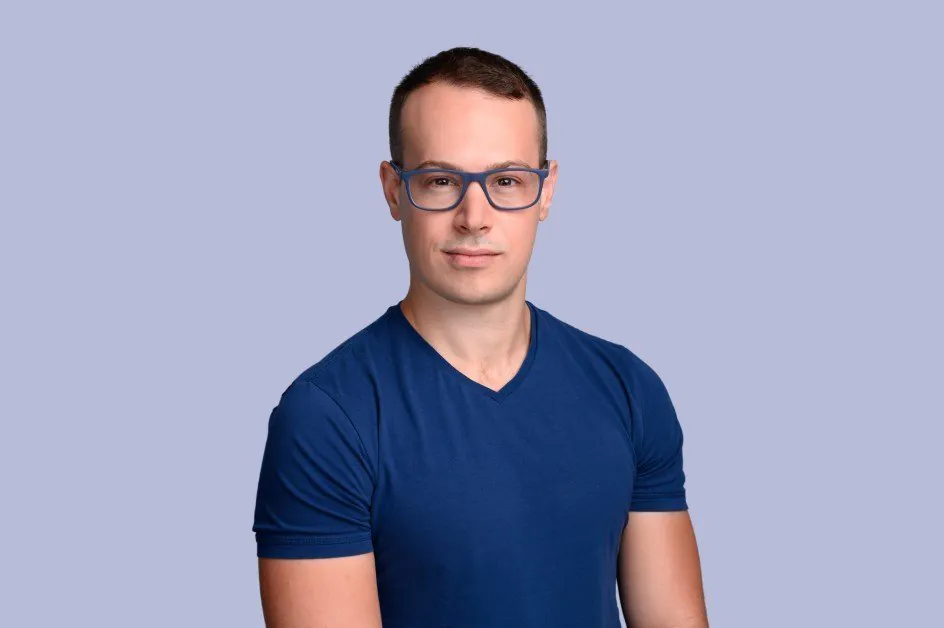
Gil Elbaz ist Datagens CTO und Mitgründer, der in Tel Aviv ansässig ist. Er hat seinen B.Sc. und M.Sc. am Technion erworben. Gil’s Diplomarbeit konzentrierte sich auf 3D-Computer-Vision und wurde auf der CVPR, der führenden Computer-Vision-Forschungskonferenz der Welt, veröffentlicht. Datagen ist ein Pionier auf dem neuen Gebiet der simulierten Daten, einem Teilbereich der synthetischen Daten, das sich auf die photorealistische Nachbildung der Welt um uns herum konzentriert. Das Unternehmen startete im März 2021 mit über 18 Millionen Dollar an Finanzierung aus der Stillphase und arbeitet nun mit einer Reihe von Fortune-100-Unternehmen in den Bereichen erweiterte und virtuelle Realität, Robotik und Automotive zusammen, darunter die meisten der führenden US-Technologie-Unternehmen.
Was hat Sie ursprünglich zur Robotik und künstlichen Intelligenz hingezogen?
Science-Fiction-Bücher wie Isaac Asimovs Foundation-Serie und iRobot haben mich immer dazu gebracht, über eine Zukunft nachzudenken, in der Roboter ein integraler Teil unseres täglichen Lebens sind. Es gibt so viele langweilige, wiederkehrende Aufgaben, die Menschen erledigen; ich wusste, dass ich sie nicht erledigen wollte, und ich konnte mir nicht vorstellen, dass jemand anderes sie erledigen wollte. Da die Robotik eine technologische Notwendigkeit ist, dachte ich, dass es eine gute, “zukunftssichere” Karriereentscheidung wäre, in diese Richtung zu gehen.
Also näherte ich mich dem Fachgebiet anfangs mit dem Fokus auf die physischen Aspekte des Themas und erwarb meinen Abschluss in Maschinenbau am Technion in Haifa, Israel. Gegen Ende meines Studiums begann ich, mich tief in die Welt der CAD-Tools und -Fähigkeiten zu vertiefen. Diese Tools ermöglichen es Maschinenbauingenieuren, Strukturen und mechanische Geräte zu entwerfen (alles von einer Brücke bis hin zu einem Auto). Ich sah eine enorme Gelegenheit, einen großen Einfluss ohne die langsamen Iterationen der physischen Welt auszuüben. In der Praxis hatten diese Programme sehr wenig, wenn überhaupt, maschinelles Lernen/Computer-Vision-Fähigkeiten integriert, die Ingenieuren halfen, einfachere, günstigere und stabilere mechanische Systeme zu erstellen (das war 2015). Ich begann, mich in Richtung Computer-Vision auf 3D-Daten mit Deep Learning (sehr neu damals) zu bewegen, mit dem Ziel, intelligentere CAD-Programme zu erstellen. Die Arbeit in den frühen Tagen des modernen Deep Learning fühlte sich an, als wäre man Teil von etwas, das wirklich groß sein könnte – ähnlich wie das Internet.
In der Praxis war meine Forschung die erste, die die Deep-Learning-Revolution an unsere Fakultät am Technion brachte. Dies führte später zu einem Paper, das auf der führenden Computer-Vision-Konferenz der Welt, CVPR, angenommen wurde, und ich flog nach Hawaii zur CVPR 2017. Die Präsentation meines Papers und das Treffen mit den Menschen öffneten mir die Augen für das Ausmaß der Computer-Vision-Community (die heute mindestens 10-mal größer ist), Tausende von Teilnehmern, die alle leidenschaftlich an Forschung auf diesem Gebiet arbeiten. Diese Veranstaltung hat mich letztendlich in meine Richtung bestärkt und mir die Macht der Computer-Vision und das Potenzial gezeigt, das darauf wartet, freigesetzt zu werden.
Könnten Sie die Entstehungsgeschichte hinter Datagen teilen?
Datagen wurde 2018 mit der Mission gegründet, die Art und Weise zu revolutionieren, wie Teams ihre Daten für die Ausbildung von Computer-Vision-Netzwerken erhalten. Im Jahr zuvor sahen wir eine Demo der Oculus Rift, die aus einer VR-Brille und einem Handheld-Remote-Control-Gerät bestand. Nach der Demo fragten wir uns, “Warum wurde ein Handheld-Gerät benötigt, um den virtuellen Raum mit dem physischen Raum zu verbinden (d. h. die Handbewegung zu verfolgen)?” Die neuronalen Netze waren bereits ausreichend fortgeschritten, um es zu bewältigen, also was war das Problem?” Und das war der Moment, in dem uns die Erleuchtung kam – Daten! Wir sahen sofort die enorme Gelegenheit, 3D-räumliche Präsenzherausforderungen mithilfe fortschrittlicher Computer-Vision und 3D-Metadaten zu lösen. Anstatt uns ausschließlich auf VR/AR zu konzentrieren, gingen wir einen holistischeren Ansatz, indem wir uns auf das scheinbar unlösbare Problem konzentrierten, ausreichend (und genaue) Trainingsdaten zu generieren, um realweltliche 3D-KI-Anwendungen zu ermöglichen.
Mit dem Fokus auf Menschen und menschliche Umgebungsinteraktion ist Datagen ein Pionier auf dem neuen Gebiet der simulierten Daten, einem Teilbereich der synthetischen Daten, das sich auf die photorealistische Nachbildung der Welt um uns herum konzentriert. Heute arbeiten wir mit den innovativsten Unternehmen der Welt zusammen, um ihre Computer-Vision-Entwicklung zu beschleunigen und zu fördern und werden von einigen der angesehensten Investoren in diesem Bereich unterstützt.
Für Leser, die nicht vertraut sind, könnten Sie erklären, was speziell synthetische Daten sind?
Synthetische Daten sind alle Trainingsdaten, die – anstatt durch direkte Messung oder Beobachtung der realen Welt – algorithmisch oder durch Simulation generiert werden. Im Kontext der Computer-Vision sind synthetische Daten computererzeugte Bilder mit den erforderlichen Metadaten für die Ausbildung künstlicher Intelligenzen. Aufgrund von Datenschutzproblemen und realen physischen und wirtschaftlichen Einschränkungen bei realen Weltbildern ist es schwer, die Bedeutung von synthetischen Daten für maschinelles Lernen und KI zu überschätzen. In einem aktuellen Bericht prognostizierte Gartner, dass bis 2024 die meisten der Daten, die im Bereich KI verwendet werden, künstlich generiert werden, und zwar aus diesen Gründen.
Was sind einige Vorteile von synthetischen Daten im Vergleich zur manuellen Datenerfassung?
Die kurze Antwort lautet: Denken Sie an jeden Aspekt der manuellen Datenerfassung, der unerwünscht ist, und entfernen Sie diese aus dem Prozess – das sind die Vorteile von synthetischen Daten.
Das Erzeugen vielfältiger Datensätze im großen Maßstab für die Computer-Vision-Ausbildung ist ein teurer und zeitaufwändiger Prozess, und die Varianz ist sehr begrenzt durch die bloße Tatsache, dass Menschen an bestimmten Orten platziert und fotografiert werden, was ein viel komplizierterer und teurerer Prozess ist als das Erstellen in einer simulierten Umgebung. Ein weiterer großer Vorteil ist die effektive Beseitigung der Notwendigkeit für manuelle Annotation, die langweilig, zeitaufwändig und anfällig für menschliche Fehler ist.
Datagen bezeichnet simulierte Daten als Teilbereich von synthetischen Daten. Könnten Sie erläutern, was simulierte Daten sind?
Simulierte Daten sind synthetische Daten, die durch Simulation generiert werden. Wir verwenden GANs (sowie einige andere fortschrittliche maschinelle Lernmethoden) zum Erzeugen von 3D-Objekten und platzieren sie in hochrealistischen 3D-Simulationen der realen Welt. Das sieht aus wie ein first-person-“virtuelles Fotoprozess”, aber in einem photorealistischen, physikbasierten System. Diese Simulationen erzeugen visuelle Daten (als ob sie in der realen Welt gesammelt worden wären) zusammen mit einer vollständigen Reihe von Annotationen (Physik, Beleuchtung usw.). Simulierte Daten sind also synthetische Daten, die photorealistisch, kontextuell generiert, 3D-Bilder sind, die in einer simulierten Umgebung gesammelt werden.
Wie generiert Datagen maßgeschneiderte simulierte Daten?
Datagens Technologie generiert simulierte Daten, die sowohl skalierbar als auch maßgeschneidert sind, um die spezifischen Bedürfnisse jedes Kundenanwendungsfalls zu erfüllen. Wir tun dies, indem wir jeden Aspekt jedes Projekts berücksichtigen – von dem verwendeten Computer-Vision-System bis hin zur demografischen Zusammensetzung der Region, in der es eingesetzt wird. Ob wir direkt mit unseren Kunden zusammenarbeiten oder einfach ihre eigenen Ingenieure ermöglichen, beginnt der Datagen-Prozess mit der Festlegung von Schlüsselparametern für jeden spezifischen Anwendungsfall, wie z. B. Linsenspezifikationen, Beleuchtung, Umgebung, demografische Verteilung usw. Datagen verwendet GANs und andere fortschrittliche Tools und Techniken, um eine enorme Vielfalt an Assets zu erzeugen, darunter alles von menschlichen Köpfen mit dynamischen Gesichtsausdrücken, um KI im emotionalen Analysebereich zu trainieren, bis hin zu Fahrzeuginterieurs für die Überwachung von Insassen im Fahrzeug und Haushaltsumgebungen für Videokonferenzanwendungen, um nur einige Beispiele zu nennen. Für jeden Asset-Typ führt Datagen Varianz über unzählige diskrete Achsen ein (von Hautfarbe und Augenbrauenhöhe bis hin zu Größe, Farbe und Form von Haushaltsmöbeln), die mit Parametern fein abgestimmt sind, um den spezifischen Anwendungsfall widerzuspiegeln.
Vielen Dank für das großartige Interview. Leser, die mehr erfahren möchten, sollten Datagen besuchen.


