
KI-Modelle und Plattformen
Kompletter Leitfaden zu Gemma 2: Googles neuem Open-Source-Large-Language-Modell

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Gemma 2 baut auf seinem Vorgänger auf und bietet verbesserte Leistung und Effizienz, sowie eine Reihe von innovativen Funktionen, die es besonders attraktiv für Forschung und praktische Anwendungen machen. Was Gemma 2 von anderen Modellen unterscheidet, ist seine Fähigkeit, eine Leistung zu erzielen, die mit viel größeren proprietären Modellen vergleichbar ist, aber in einem Paket, das für eine breitere Zugänglichkeit und Nutzung auf bescheideneren Hardware-Konfigurationen konzipiert ist.
Als ich mich mit den technischen Spezifikationen und der Architektur von Gemma 2 auseinandersetzte, war ich immer wieder von der Ingeniosität seines Designs beeindruckt. Das Modell integriert mehrere fortschrittliche Techniken, einschließlich neuer Aufmerksamkeitsmechanismen und innovativer Ansätze zur Trainingsstabilität, die zu seinen bemerkenswerten Fähigkeiten beitragen.

Google [securities_stock_price_tag symbol="GOOGL" exchange="NASDAQ"] Open Source LLM Gemma
In diesem umfassenden Leitfaden werden wir Gemma 2 ausführlich untersuchen, seine Architektur, Schlüsselfunktionen und praktische Anwendungen betrachten. Egal, ob Sie ein erfahrener AI-Praktiker oder ein begeisterter Neuling auf dem Gebiet sind, dieses Artikel soll wertvolle Einblicke in die Funktionsweise von Gemma 2 und die Möglichkeiten bieten, seine Leistung in Ihren eigenen Projekten zu nutzen.
Was ist Gemma 2?
Gemma 2 ist Googles neuestes Open-Source-Large-Language-Modell, das leichtgewichtig und leistungsstark konzipiert ist. Es basiert auf der gleichen Forschung und Technologie, die für die Entwicklung von Googles Gemini-Modellen verwendet wurde, und bietet damit Spitzenleistungen in einem zugänglicheren Paket. Gemma 2 ist in zwei Größen erhältlich:
Gemma 2 9B: Ein Modell mit 9 Milliarden Parametern
Gemma 2 27B: Ein größeres Modell mit 27 Milliarden Parametern
Jede Größe ist in zwei Varianten erhältlich:
Basis-Modelle: Vorab trainiert auf einer umfangreichen Textdatenmenge
Instruction-tuned (IT)-Modelle: Feinabgestimmt für bessere Leistung bei spezifischen Aufgaben
Zugriff auf die Modelle in Google AI Studio: Google AI Studio – Gemma 2
Lesen Sie den technischen Bericht hier: Gemma 2 Technischer Bericht
Schlüsselfunktionen und Verbesserungen
Gemma 2 bietet mehrere bedeutende Neuerungen im Vergleich zu seinem Vorgänger:
1. Erhöhte Trainingsdaten
Die Modelle wurden auf wesentlich mehr Daten trainiert:
Gemma 2 27B: Trainiert auf 13 Billionen Token
Gemma 2 9B: Trainiert auf 8 Billionen Token
Diese erweiterte Datenmenge, die hauptsächlich aus Webdaten (meist Englisch), Code und Mathematik besteht, trägt zu den verbesserten Leistungen und der Vielseitigkeit der Modelle bei.
2. Sliding Window Attention
Gemma 2 implementiert einen neuen Ansatz für Aufmerksamkeitsmechanismen:
Jedes andere Layer verwendet eine Sliding Window Attention mit einem lokalen Kontext von 4096 Token
Alternierende Layer verwenden vollständige quadratische globale Aufmerksamkeit über den gesamten Kontext von 8192 Token
Dieser hybride Ansatz zielt darauf ab, Effizienz mit der Fähigkeit zu balancieren, langfristige Abhängigkeiten in der Eingabe zu erfassen.
3. Soft-Capping
Um die Trainingsstabilität und Leistung zu verbessern, führt Gemma 2 einen Soft-Capping-Mechanismus ein:
<p>def soft_cap(x, cap):
return cap * torch.tanh(x / cap)</p>

<p># Angewendet auf Attention-Logits
attention_logits = soft_cap(attention_logits, cap=50.0)</p>

# Angewendet auf die Endlogits

<p>final_logits = soft_cap(final_logits, cap=30.0)
Diese Technik verhindert, dass Logits übermäßig groß werden, ohne eine harte Trunkierung durchzuführen, und bewahrt so mehr Informationen, während die Trainingsstabilität verbessert wird.
- Gemma 2 9B: Ein Modell mit 9 Milliarden Parametern
- Gemma 2 27B: Ein größeres Modell mit 27 Milliarden Parametern
Jede Größe ist in zwei Varianten erhältlich:
- Basis-Modelle: Vorab trainiert auf einer umfangreichen Textdatenmenge
- Instruction-tuned (IT)-Modelle: Feinabgestimmt für bessere Leistung bei spezifischen Aufgaben
4. Wissensdestillation
Für das 9B-Modell verwendet Gemma 2 Wissensdestillationstechniken:
- Vorab-Training: Das 9B-Modell lernt von einem größeren Lehrer-Modell während des initialen Trainings
- Nach-Training: Sowohl das 9B- als auch das 27B-Modell verwenden on-policy-Destillation, um ihre Leistung zu verfeinern
Dieser Prozess hilft dem kleineren Modell, die Fähigkeiten größerer Modelle effektiver zu erfassen.
5. Modell-Merging
Gemma 2 nutzt eine neuartige Modell-Merging-Technik namens Warp, die mehrere Modelle in drei Stufen kombiniert:
- Exponential Moving Average (EMA) während des Reinforcement-Learning-Feinabstimmungsprozesses
- Spherical Linear intERPolation (SLERP) nach der Feinabstimmung mehrerer Richtlinien
- Linear Interpolation Towards Initialization (LITI) als letzter Schritt
Dieser Ansatz zielt darauf ab, ein robustes und leistungsfähiges Endmodell zu erstellen.
Leistungsbewertung
Gemma 2 zeigt eine beeindruckende Leistung in verschiedenen Bewertungen:
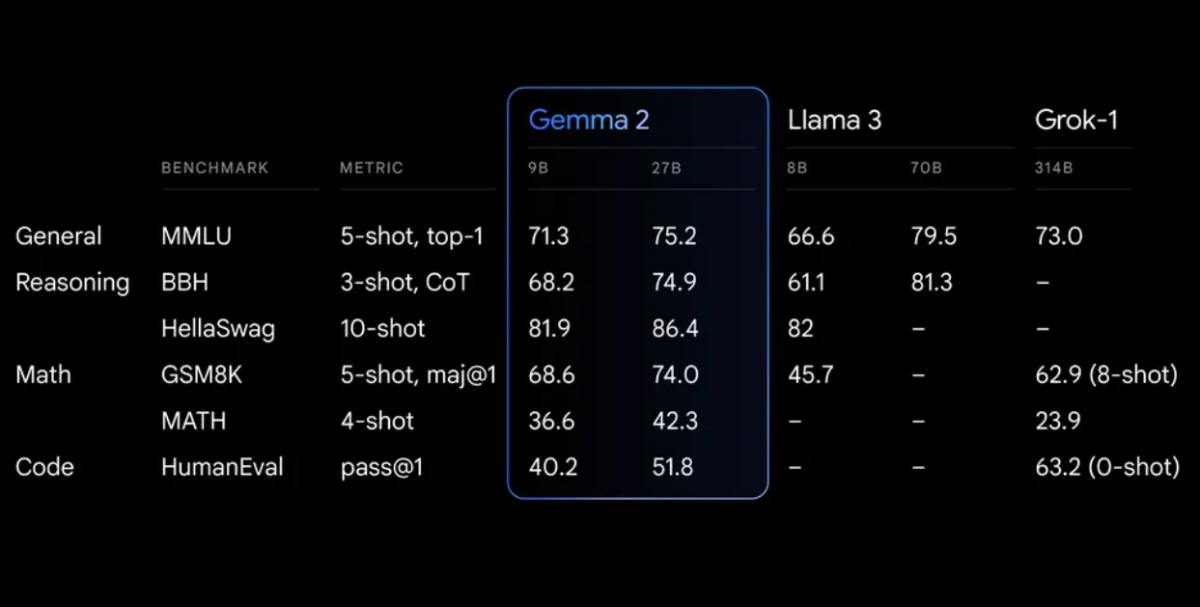
Gemma 2 auf einer neu konzipierten Architektur, die für außergewöhnliche Leistung und Inferenz-Effizienz konzipiert ist
Erste Schritte mit Gemma 2
Um mit Gemma 2 in Ihren Projekten zu beginnen, haben Sie mehrere Optionen:
1. Google AI Studio
Für schnelles Experimentieren ohne Hardware-Anforderungen können Sie auf Gemma 2 über Google AI Studio zugreifen.
2. Hugging Transformers
Gemma 2 ist in die beliebte Hugging Face Transformers-Bibliothek integriert. Hier erfahren Sie, wie Sie es nutzen können:
<p>from transformers import AutoTokenizer, AutoModelForCausalLM</p>

<p># Laden Sie das Modell und den Tokenizer
model_name = "google/gemma-2-27b-it" # oder "google/gemma-2-9b-it" für die kleinere Version
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)</p>

<p># Vorbereiten der Eingabe
prompt = "Erklären Sie das Konzept der Quantenverschränkung in einfachen Worten."
inputs = tokenizer(prompt, return_tensors="pt")</p>

<p># Generieren von Text
outputs = model.generate(**inputs, max_length=200)
response = tokenizer.decode(outputs[0], skip_special_tokens=True)</p>

print(response)
3. TensorFlow/Keras
Für TensorFlow-Benutzer ist Gemma 2 über Keras verfügbar:
<p>import tensorflow as tf
from keras_nlp.models import GemmaCausalLM</p>

<p># Laden Sie das Modell
model = GemmaCausalLM.from_preset("gemma_2b_en")</p>

<p># Generieren von Text
prompt = "Erklären Sie das Konzept der Quantenverschränkung in einfachen Worten."
output = model.generate(prompt, max_length=200)</p>

print(output)
Erweiterte Verwendung: Erstellen eines lokalen RAG-Systems mit Gemma 2
Eine leistungsstarke Anwendung von Gemma 2 ist das Erstellen eines Retrieval Augmented Generation (RAG)-Systems. Lassen Sie uns ein einfaches, vollständig lokales RAG-System mit Gemma 2 und Nomic-Embeddings erstellen.
Schritt 1: Einrichten der Umgebung
Zunächst müssen Sie sicherstellen, dass Sie die notwendigen Bibliotheken installiert haben:
<p>pip install langchain ollama nomic chromadb</p>
Schritt 2: Indexieren von Dokumenten
Erstellen Sie einen Indexer, um Ihre Dokumente zu verarbeiten:
<p>import os
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.document_loaders import DirectoryLoader
from langchain.vectorstores import Chroma
from langchain.embeddings import HuggingFaceEmbeddings</p>

<p>class Indexer:
def __init__(self, directory_path):
self.directory_path = directory_path
self.text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
self.embeddings = HuggingFaceEmbeddings(model_name="nomic-ai/nomic-embed-text-v1")</p>

<p>def load_and_split_documents(self):
loader = DirectoryLoader(self.directory_path, glob="**/*.txt")
documents = loader.load()
return self.text_splitter.split_documents(documents)</p>

<p>def create_vector_store(self, documents):
return Chroma.from_documents(documents, self.embeddings, persist_directory="./chroma_db")</p>

<p>def index(self):
documents = self.load_and_split_documents()
vector_store = self.create_vector_store(documents)
vector_store.persist()
return vector_store</p>

<p># Verwendung
indexer = Indexer("path/to/your/documents")
vector_store = indexer.index()</p>
Schritt 3: Einrichten des RAG-Systems
Jetzt können wir das RAG-System mit Gemma 2 erstellen:
<p>from langchain.llms import Ollama
from langchain.chains import RetrievalQA
from langchain.prompts import PromptTemplate</p>

<p>class RAGSystem:
def __init__(self, vector_store):
self.vector_store = vector_store
self.llm = Ollama(model="gemma2:9b")
self.retriever = self.vector_store.as_retriever(search_kwargs={"k": 3})</p>

<p>self.template = """Verwenden Sie den folgenden Kontext, um die Frage am Ende zu beantworten.
Wenn Sie die Antwort nicht kennen, sagen Sie einfach, dass Sie sie nicht kennen, versuchen Sie nicht, eine Antwort zu erfinden.</p>

{context}

<p>Frage: {question}
Antwort: """</p>

<p>self.qa_prompt = PromptTemplate(
template=self.template, input_variables=["context", "question"]
)</p>

<p>self.qa_chain = RetrievalQA.from_chain_type(
llm=self.llm,
chain_type="stuff",
retriever=self.retriever,
return_source_documents=True,
chain_type_kwargs={"prompt": self.qa_prompt}
)</p>

<p>def query(self, question):
return self.qa_chain({"query": question})</p>

<p># Verwendung
rag_system = RAGSystem(vector_store)
response = rag_system.query("Was ist die Hauptstadt von Frankreich?")
print(response["result"])</p>
Dieses RAG-System verwendet Gemma 2 über Ollama für das Sprachmodell und Nomic-Embeddings für die Dokumentenrückgewinnung. Es ermöglicht es Ihnen, Fragen auf der Grundlage der indizierten Dokumente zu stellen und Antworten mit Kontext aus den relevanten Quellen zu erhalten.
Feinabstimmung von Gemma 2
Für spezifische Aufgaben oder Domänen möchten Sie möglicherweise Gemma 2 feinabstimmen. Hier ist ein grundlegender Beispiel mit der Hugging Face Transformers-Bibliothek:
from transformers import AutoTokenizer, AutoModelForCausalLM, TrainingArguments, Trainer
from datasets import load_dataset

<p># Laden Sie das Modell und den Tokenizer
model_name = "google/gemma-2-9b-it"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)</p>

<p># Vorbereiten des Datensatzes
dataset = load_dataset("your_dataset")</p>

<p>def tokenize_function(examples):
return tokenizer(examples["text"], padding="max_length", truncation=True)</p>

<p>tokenized_datasets = dataset.map(tokenize_function, batched=True)</p>

<p># Einrichten der Trainingsargumente
training_args = TrainingArguments(
output_dir="./results",
num_train_epochs=3,
per_device_train_batch_size=4,
per_device_eval_batch_size=4,
warmup_steps=500,
weight_decay=0.01,
logging_dir="./logs",
)</p>

<p># Initialisieren des Trainers
trainer = Trainer(
model=model,
args=training_args,
train_dataset=tokenized_datasets["train"],
eval_dataset=tokenized_datasets["test"],
)</p>

# Starten der Feinabstimmung
trainer.train()

<p># Speichern des feinabgestimmten Modells
model.save_pretrained("./fine_tuned_gemma2")
tokenizer.save_pretrained("./fine_tuned_gemma2")</p>
Denken Sie daran, die Trainingsparameter basierend auf Ihren spezifischen Anforderungen und Rechenressourcen anzupassen.
Ethische Überlegungen und Einschränkungen
Während Gemma 2 beeindruckende Fähigkeiten bietet, ist es wichtig, sich seiner Einschränkungen und ethischen Überlegungen bewusst zu sein:
- Vorurteile: Wie alle Sprachmodelle kann Gemma 2 Vorurteile widerspiegeln, die in seinen Trainingsdaten vorhanden sind. Bewerten Sie seine Ausgaben immer kritisch.
- Sachliche Genauigkeit: Obwohl Gemma 2 hochleistungsfähig ist, kann es manchmal falsche oder inkonsistente Informationen generieren. Überprüfen Sie wichtige Fakten aus zuverlässigen Quellen.
- Kontextlänge: Gemma 2 hat eine Kontextlänge von 8192 Token. Für längere Dokumente oder Gespräche müssen Sie möglicherweise Strategien zur Kontextverwaltung implementieren.
- Rechenressourcen: Insbesondere für das 27B-Modell können erhebliche Rechenressourcen für effiziente Inferenz und Feinabstimmung erforderlich sein.
- Verantwortungsvolle Nutzung: Halten Sie sich an Googles Grundsätze für verantwortungsvolle KI und stellen Sie sicher, dass Ihre Nutzung von Gemma 2 mit ethischen KI-Prinzipien übereinstimmt.
Schlussfolgerung
Gemma 2 bietet fortschrittliche Funktionen wie Sliding Window Attention, Soft-Capping und neuartige Modell-Merging-Techniken, die es zu einem leistungsstarken Werkzeug für eine breite Palette von Aufgaben im Bereich der natürlichen Sprachverarbeitung machen.
Indem Sie Gemma 2 in Ihren Projekten nutzen, egal ob durch einfache Inferenz, komplexe RAG-Systeme oder feinabgestimmte Modelle für spezifische Domänen, können Sie die Leistung von SOTA-KI nutzen, während Sie die Kontrolle über Ihre Daten und Prozesse behalten.


