KI-Modelle und Plattformen
Code-Einbettung: Ein umfassender Leitfaden

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen

Code-Einbettungen sind eine transformative Möglichkeit, Code-Snippets als dichte Vektoren in einem kontinuierlichen Raum darzustellen. Diese Einbettungen erfassen die semantischen und funktionalen Beziehungen zwischen Code-Snippets, was leistungsstarke Anwendungen in der AI-gestützten Programmierung ermöglicht. Ähnlich wie Wort-Einbettungen in der natürlichen Sprachverarbeitung (NLP) positionieren Code-Einbettungen ähnliche Code-Snippets nahe beieinander im Vektorraum, was es Maschinen ermöglicht, Code besser zu verstehen und zu manipulieren.
Was sind Code-Einbettungen?
Code-Einbettungen konvertieren komplexe Code-Strukturen in numerische Vektoren, die die Bedeutung und Funktionalität des Codes erfassen. Im Gegensatz zu herkömmlichen Methoden, die Code als Sequenzen von Zeichen behandeln, erfassen Einbettungen die semantischen Beziehungen zwischen Teilen des Codes. Dies ist für verschiedene AI-gesteuerte Software-Entwicklungsaufgaben wie Code-Suche, Vervollständigung, Fehlererkennung und mehr von entscheidender Bedeutung.
Ein Beispiel sind diese beiden Python-Funktionen:
def add_numbers(a, b):
return a + b
<p>def sum_two_values(x, y):
result = x + y
return result</p>
Obwohl diese Funktionen syntaktisch unterschiedlich aussehen, führen sie die gleiche Operation aus. Eine gute Code-Einbettung würde diese beiden Funktionen mit ähnlichen Vektoren darstellen, ihre funktionale Ähnlichkeit trotz ihrer textlichen Unterschiede erfassend.

Vektor-Einbettung
Wie werden Code-Einbettungen erstellt?
Es gibt verschiedene Techniken zur Erstellung von Code-Einbettungen. Eine gängige Methode umfasst die Verwendung von neuronalen Netzen, um diese Darstellungen aus einer großen Datenmenge von Code zu lernen. Das Netz analysiert die Code-Struktur, einschließlich Token (Schlüsselwörter, Bezeichner), Syntax (wie der Code strukturiert ist) und möglicherweise Kommentare, um die Beziehungen zwischen verschiedenen Code-Snippets zu lernen.
Lassen Sie uns den Prozess aufschlüsseln:
- Code als Sequenz: Zunächst werden Code-Snippets als Sequenzen von Token (Variablen, Schlüsselwörtern, Operatoren) behandelt.
- Neuronales Netz-Training: Ein neuronales Netz verarbeitet diese Sequenzen und lernt, sie auf feste Vektor-Darstellungen abzubilden. Das Netz berücksichtigt Faktoren wie Syntax, Semantik und Beziehungen zwischen Code-Elementen.
- Ähnlichkeiten erfassen: Das Training zielt darauf ab, ähnliche Code-Snippets (mit ähnlicher Funktionalität) nahe beieinander im Vektorraum zu platzieren. Dies ermöglicht Aufgaben wie das Finden ähnlichen Codes oder das Vergleichen von Funktionalitäten.
Hier ist ein vereinfachtes Python-Beispiel, wie man Code für die Einbettung vorbereiten könnte:
import ast

<p>def tokenize_code(code_string):
tree = ast.parse(code_string)
tokens = []
for node in ast.walk(tree):
if isinstance(node, ast.Name):
tokens.append(node.id)
elif isinstance(node, ast.Str):
tokens.append('STRING')
elif isinstance(node, ast.Num):
tokens.append('NUMBER')
# Weitere Knotentypen wie benötigt hinzufügen
return tokens</p>

<p># Beispiel-Anwendung
code = """
def greet(name):
print("Hallo, " + name + "!")
"""
</p>

<p>tokens = tokenize_code(code)
print(tokens)
# Ausgabe: ['def', 'greet', 'name', 'print', 'STRING', 'name', 'STRING']</p>
Diese tokenisierte Darstellung kann dann in ein neuronales Netz für die Einbettung eingespeist werden.
Bestehtende Ansätze für Code-Einbettungen
Bestehende Methoden für Code-Einbettungen können in drei Hauptkategorien eingeteilt werden:
Token-basierte Methoden
Token-basierte Methoden behandeln Code als Sequenz von lexikalischen Token. Techniken wie Term Frequency-Inverse Document Frequency (TF-IDF) und Deep-Learning-Modelle wie CodeBERT fallen in diese Kategorie.
Tree-basierte Methoden
Tree-basierte Methoden parsen Code in abstrakte Syntaxbäume (ASTs) oder andere Baumstrukturen, um die syntaktischen und semantischen Regeln des Codes zu erfassen. Beispiele umfassen tree-basierte neuronale Netze und Modelle wie code2vec und ASTNN.
Graph-basierte Methoden
Graph-basierte Methoden konstruieren Graphen aus Code, wie Kontrollflussgraphen (CFGs) und Datenflussgraphen (DFGs), um das dynamische Verhalten und die Abhängigkeiten des Codes darzustellen. GraphCodeBERT ist ein bemerkenswertes Beispiel.
TransformCode: Ein Framework für Code-Einbettungen
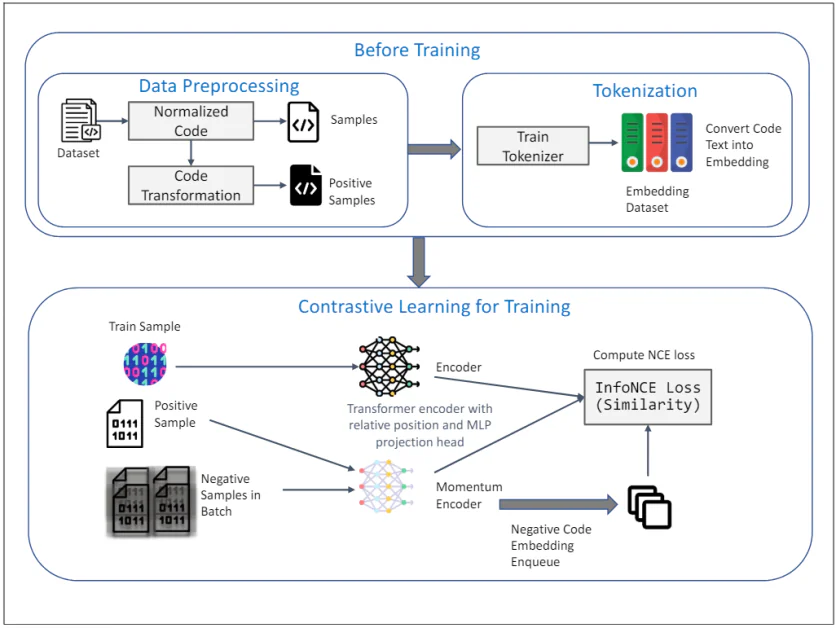
TransformCode: Unsupervised Learning of Code Embedding
TransformCode ist ein Framework, das die Einschränkungen bestehender Methoden durch das Lernen von Code-Einbettungen in einer kontrastiven Lernweise adressiert. Es ist encoder-agnostisch und sprachagnostisch, was bedeutet, dass es jeden Encoder-Modell nutzen und jede Programmiersprache verarbeiten kann.
Das Diagramm oben veranschaulicht das Framework von TransformCode für das unsupervised Learning von Code-Einbettungen unter Verwendung von kontrastivem Lernen. Es besteht aus zwei Hauptphasen: Vor dem Training und Kontrastives Lernen für das Training. Hier ist eine detaillierte Erklärung jeder Komponente:
Vor dem Training
1. Daten-Vorverarbeitung:
- Datensatz: Die anfängliche Eingabe ist ein Datensatz, der Code-Snippets enthält.
- Normalisierter Code: Die Code-Snippets werden normalisiert, um Kommentare zu entfernen und Variablen in einem Standardformat umzubenennen. Dies hilft dabei, den Einfluss der Variablen-Namensgebung auf den Lernprozess zu reduzieren und die Verallgemeinerungsfähigkeit des Modells zu verbessern.
- Code-Transformation: Der normalisierte Code wird dann mithilfe verschiedener syntaktischer und semantischer Transformationen transformiert, um positive Beispiele zu generieren. Diese Transformationen stellen sicher, dass die semantische Bedeutung des Codes unverändert bleibt und diverse und robuste Beispiele für das kontrastive Lernen bereitstellt.
2. Tokenisierung:
- Trainings-Tokenisierung: Ein Tokenisierer wird auf dem Code-Datensatz trainiert, um Code-Text in Einbettungen umzuwandeln. Dies beinhaltet das Aufbrechen des Codes in kleinere Einheiten, wie Token, die vom Modell verarbeitet werden können.
- Einbettungs-Datensatz: Der trainierte Tokenisierer wird verwendet, um den gesamten Code-Datensatz in Einbettungen umzuwandeln, die als Eingabe für die kontrastive Lernphase dienen.
Kontrastives Lernen für das Training
3. Trainings-Prozess:
- Trainings-Beispiel: Ein Beispiel aus dem Trainings-Datensatz wird als Abfrage-Code-Darstellung ausgewählt.
- Positives Beispiel: Das entsprechende positive Beispiel ist die transformierte Version des Abfrage-Codes, die während der Daten-Vorverarbeitungsphase erhalten wurde.
- Negative Beispiele im Batch: Negative Beispiele sind alle anderen Code-Beispiele im aktuellen Mini-Batch, die sich von dem positiven Beispiel unterscheiden.
4. Encoder und Momentum-Encoder:
- Transformer-Encoder mit relativer Position und MLP-Projektions-Kopf: Sowohl die Abfrage als auch die positiven Beispiele werden in einen Transformer-Encoder eingespeist. Der Encoder berücksichtigt relative Positionscodierung, um die syntaktische Struktur und die Beziehungen zwischen Token im Code zu erfassen. Ein MLP-Projektions-Kopf wird verwendet, um die codierten Darstellungen auf einen niedrigerdimensionalen Raum abzubilden, in dem das kontrastive Lernziel angewendet wird.
- Momentum-Encoder: Ein Momentum-Encoder wird auch verwendet, der durch einen gleitenden Durchschnitt der Parameter des Abfrage-Encoders aktualisiert wird. Dies hilft dabei, die Konsistenz und Vielfalt der Darstellungen zu bewahren und den Kollaps des kontrastiven Verlusts zu verhindern. Die negativen Beispiele werden mithilfe dieses Momentum-Encoders codiert und für den kontrastiven Lernprozess in eine Warteschlange eingereiht.
5. Kontrastives Lernziel:
- Berechnung von InfoNCE-Verlust (Ähnlichkeit): Der InfoNCE-Verlust (Noise Contrastive Estimation) wird berechnet, um die Ähnlichkeit zwischen der Abfrage und den positiven Beispielen zu maximieren, während die Ähnlichkeit zwischen der Abfrage und den negativen Beispielen minimiert wird. Dieses Ziel stellt sicher, dass die gelernten Einbettungen diskriminativ und robust sind und die semantische Ähnlichkeit der Code-Snippets erfassen.
Das gesamte Framework nutzt die Stärken des kontrastiven Lernens, um sinnvolle und robuste Code-Einbettungen aus unbezeichneten Daten zu lernen. Die Verwendung von AST-Transformationen und eines Momentum-Encoders verbessert die Qualität und Effizienz der gelernten Darstellungen weiter, was TransformCode zu einem leistungsstarken Werkzeug für verschiedene Software-Entwicklungsaufgaben macht.
Schlüsselmerkmale von TransformCode
- Flexibilität und Anpassungsfähigkeit: Kann auf verschiedene Downstream-Aufgaben mit Code-Darstellung erweitert werden.
- Effizienz und Skalierbarkeit: Erfordert kein großes Modell oder umfangreiche Trainingsdaten, unterstützt jede Programmiersprache.
- Unsupervised und Supervised Learning: Kann auf beide Lernszenarien angewendet werden, indem Aufgaben-spezifische Labels oder Ziele integriert werden.
- Anpassbare Parameter: Die Anzahl der Encoder-Parameter kann basierend auf den verfügbaren Rechenressourcen angepasst werden.
TransformCode führt eine Daten-Augmentierungstechnik namens AST-Transformation ein, die syntaktische und semantische Transformationen auf die ursprünglichen Code-Snippets anwendet. Dies generiert diverse und robuste Beispiele für das kontrastive Lernen.
Anwendungen von Code-Einbettungen
Code-Einbettungen haben verschiedene Aspekte der Software-Entwicklung revolutioniert, indem sie Code von einem textuellen Format in eine numerische Darstellung umwandeln, die von maschinellen Lernmodellen genutzt werden kann. Hier sind einige wichtige Anwendungen:
Verbesserte Code-Suche
Traditionell basierte die Code-Suche auf Schlüsselwort-Abgleich, was oft zu irrelevanten Ergebnissen führte. Code-Einbettungen ermöglichen semantische Suche, bei der Code-Snippets basierend auf ihrer Funktionsähnlichkeit bewertet werden, auch wenn sie unterschiedliche Schlüsselwörter verwenden. Dies verbessert die Genauigkeit und Effizienz der Suche nach relevantem Code in großen Codebasen erheblich.
Intelligente Code-Vervollständigung
Code-Vervollständigungstools schlagen relevante Code-Snippets basierend auf dem aktuellen Kontext vor. Durch die Nutzung von Code-Einbettungen können diese Tools genauer und hilfreichere Vorschläge liefern, indem sie die semantische Bedeutung des geschriebenen Codes verstehen. Dies führt zu schnelleren und produktiveren Codier-Erfahrungen.
Automatisierte Code-Korrektur und Fehler-Erkennung
Code-Einbettungen können Muster identifizieren, die oft auf Fehler oder Ineffizienzen im Code hinweisen. Durch die Analyse der Ähnlichkeit zwischen Code-Snippets und bekannten Fehlermustern können diese Systeme automatisch Korrekturen vorschlagen oder Bereiche hervorheben, die einer weiteren Untersuchung bedürfen.
Verbesserte Code-Zusammenfassung und Dokumenten-Generierung
Große Codebasen fehlen oft an angemessener Dokumentation, was es neuen Entwicklern erschwert, ihre Funktionsweise zu verstehen. Code-Einbettungen können präzise Zusammenfassungen erstellen, die die Essenz der Code-Funktionalität erfassen. Dies verbessert nicht nur die Code-Wartbarkeit, sondern erleichtert auch den Wissens-Transfer innerhalb der Entwickler-Teams.
Verbesserte Code-Überprüfungen
Code-Überprüfungen sind entscheidend für die Aufrechterhaltung der Code-Qualität. Code-Einbettungen können Überprüfern helfen, indem sie potenzielle Probleme hervorheben und Verbesserungsvorschläge machen. Darüber hinaus können sie den Vergleich zwischen verschiedenen Code-Versionen erleichtern, was den Überprüfungsprozess effizienter macht.
Über-sprachliche Code-Verarbeitung
Die Welt der Software-Entwicklung ist nicht auf eine einzige Programmiersprache beschränkt. Code-Einbettungen bieten die Möglichkeit, über-sprachliche Code-Verarbeitungsaufgaben zu erleichtern. Durch die Erfassung der semantischen Beziehungen zwischen in verschiedenen Sprachen geschriebenem Code könnten diese Techniken Aufgaben wie Code-Suche und -Analyse über Sprachgrenzen hinweg ermöglichen.