
Das Beste
10 beste KI-Web-Scraping-Tools (November 2026)

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Unite.AI kann eine Vergütung erhalten, wenn Sie Links zu getesteten Produkten nutzen. Unsere redaktionellen Bewertungen bleiben davon unberührt. Lesen Sie unsere Affiliate-Offenlegung.
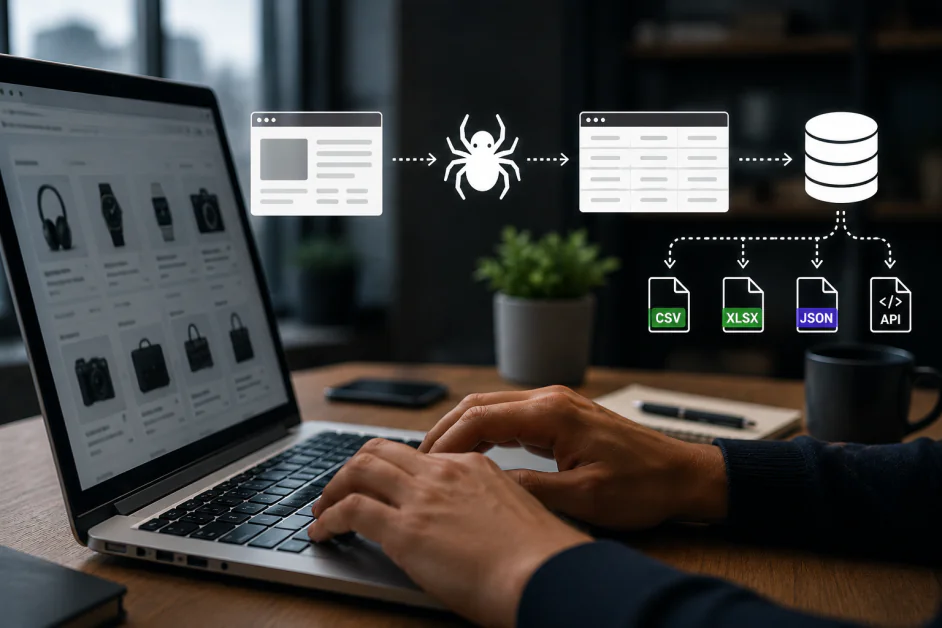
Wichtige PunkteWählen Sie das Scraping-Tool passend zur Aufgabe nach dem Laden aus, statt die gesamte…
Mehr anzeigen
- Wählen Sie das Scraping-Tool passend zur Aufgabe nach dem Laden aus, statt die gesamte Erfassung als ein einziges Problem zu behandeln.
- Übertragen Sie die Verantwortung für den Workflow an die Personen, die sowohl die Quellseiten als auch die erforderliche Ausgabe verstehen.
- Kalkulieren Sie mit nutzbaren Datensätzen statt mit den angegebenen Anfragezahlen, weil Rendering und Proxys die Gesamtsummen in die Höhe treiben.
Welches KI-Tool zum Web-Scraping am besten geeignet ist, hängt davon ab, was Sie nach dem Laden einer Seite tun möchten. Ein Rechercheassistent benötigt gut lesbare Inhalte und Links zu den Quellen. Ein Marktbeobachtungssystem braucht konsistente Datensätze in großem Umfang. Ein interaktiver Agent benötigt möglicherweise einen Browser, der mehrere Schritte ausführen und die Sitzung aufrechterhalten kann.
Dieser Leitfaden stellt zehn Tools für diese Aufgaben vor, darunter Plattformen für die Datenerfassung in Unternehmen, Content-APIs, Scraper ohne Programmierung, Suchdatendienste und verwaltete Browser. Wir bewerten, wie die einzelnen Produkte Informationen erfassen, wer den Workflow betreuen kann und welche Kompromisse wichtig werden, wenn aus einem Prototyp ein regelmäßig ablaufender Prozess wird.
Unser Team hat alle Lösungen in diesem Leitfaden unabhängig bewertet und ihre Funktionen, praktischen Stärken, Einschränkungen und Eignung für die Anwendungsfälle geprüft, die unseren Rankings zugrunde liegen.
Die besten KI-Web-Scraping-Tools im Vergleich
| KI-Tool | Am besten geeignet für | Wichtigste Stärken |
|---|---|---|
| Bright Data | Datenerfassung in Unternehmen und vielfältige Datenpipelines | Scraper-APIs, Browser-API, Scraper Studio, Datensätze, Proxys |
| Firecrawl | Webinhalte für KI-Anwendungen | Suchen, Scraping, Kartierung, Crawling, Markdown, JSON, Interaktion, MCP |
| Apify | Wiederverwendbare Scraping-Aufträge und Cloud-Orchestrierung | Actors, Crawlee, Zeitpläne, Speicher, Proxys, APIs, MCP |
| Browse AI | Datenerfassung ohne Programmierung und Überwachung von Änderungen | KI-gestützte Einrichtung, Robots, Benachrichtigungen, Zeitpläne, Integrationen |
| SearchAPI | Strukturierte Suchergebnisse und lokalisierte Recherche | Google, Maps, Shopping, Video, KI-Suchangebote, JSON |
| Octoparse | Visuelles Scraping mit wiederholbarer Ausführung in der Cloud | Vorlagen, KI-Assistent, automatische Erkennung, Cloud-Ausführungen, Exporte |
| Browserless | Verwaltete Browser für Puppeteer und Playwright | Gehostete Browser, dauerhafte Sitzungen, REST-APIs, MCP |
| ScrapingBee | Verwaltete Extraktion über eine Anwendungs-API | KI-gestützte Extraktion, CSS/XPath, Markdown, JS-Szenarien, MCP |
| Oxylabs | Verwalteter Datenabruf von anspruchsvollen öffentlichen Websites | Web-API /Scrape, Rendering, strukturierte Ausgabe, MCP |
| Diffbot | Automatische Extraktion und Informationen zu Entitäten | Extraktion, Standardschemata, Crawling, Knowledge Graph |
So wählen Sie ein KI-Tool zum Web-Scraping aus
Das Tool muss zur Aufgabe passen
Für eine KI-Wissensdatenbank sollten gut lesbare Texte, strukturierte Ausgaben und erhaltene Quell-URLs im Vordergrund stehen. Bei wiederkehrender Unternehmensrecherche können ein visueller Robot und Änderungsbenachrichtigungen wichtiger sein als eine Programmierschnittstelle. Bei einem interaktiven Agenten sollten Sie auf den Erhalt der Sitzung und die Browsersteuerung achten. APIs für Suchergebnisse lösen ein anderes Problem: Sie liefern Suchdaten, während das Erfassen der verlinkten Seiten ein separater Schritt ist.
Legen Sie fest, wer für den Workflow zuständig ist
Auf einer Plattform ohne Programmierung kann ein Analyst die Extraktionsschritte direkt anpassen. Eine API bietet Entwicklern eine übersichtliche Schnittstelle, um die Datenerfassung in eine Anwendung einzubinden. Eine Cloud-Plattform für Aufträge ergänzt Zeitplanung und Speicher, während bei einem verwalteten Browser mehr Logik für die Automatisierung in Ihrem Team verbleibt. Die richtige Wahl überträgt die Wartung an diejenigen, die sowohl die Quellwebsites als auch die benötigte Ausgabe verstehen.
Planen Sie das Budget anhand nutzbarer Datensätze, nicht anhand vollmundiger Angaben zu Anfragen
Vergleichen Sie die Kosten eines abgeschlossenen Auftrags mit den benötigten Feldern. Rendering, Premium-Proxys, Browserlaufzeit, KI-gestützte Extraktion, Speicher und wiederholte Versuche können die Gesamtkosten verändern. Ein kostenloses Guthaben, eine Browser-Einheit und eine Suchanfrage sind unterschiedliche Maßeinheiten. Bei regelmäßig anfallenden Aufgaben sollten Sie neben erfolgreichen Antworten auch Vollständigkeit, Duplikate, Aktualität und Kosten pro nutzbarem Datensatz erfassen.
Die 10 besten KI-Web-Scraping-Tools
1. Bright Data
Bright Data ist unsere allgemeine Empfehlung für Unternehmen, die über eine einzige Plattform auf mehrere Arten Webdaten erfassen möchten. Das Angebot umfasst vorgefertigte Scraper-APIs, bereits erhobene Datensätze, Scraper Studio, Web Unlocker und Proxy-Dienste. Ein Team für E-Commerce-Analysen kann beispielsweise strukturierte Feeds für bekannte Einzelhändler nutzen und zugleich eine eigene Datenerfassung für einen spezialisierten Marktplatz aufbauen. Diese Vielseitigkeit macht die Plattform besonders nützlich, wenn das Datenprogramm über eine einzelne Website oder Abteilung hinausgeht.
Für interaktive Seiten stellt die Browser API Browser bereit, die Entwickler mit Puppeteer, Playwright oder Selenium steuern können. Sie verbindet die Browserausführung mit Proxy-Verwaltung und CAPTCHA-Behandlung. Dank der Unterstützung für Chrome DevTools können Entwickler außerdem problematische Sitzungen untersuchen. Das ist hilfreich, wenn ein Arbeitsablauf eine Navigation oder Interaktion mit der Seite erfordert, bevor die gewünschten Informationen verfügbar werden, statt lediglich einen vorhandenen Datensatz herunterzuladen.
Der wichtigste Zielkonflikt besteht in der Auswahl der Produkte und der Kostenkontrolle. Browser-Traffic, Scraping-Ergebnisse und der Kauf von Datensätzen stehen für unterschiedliche Arbeitslasten. Ein einzelner Übersichtspreis kann daher nicht die gesamte Plattform abbilden. Bright Data eignet sich für Teams, in denen jemand die Verantwortung für die Qualität der Datenerfassung, die Abdeckung der Zielquellen und die Ausgaben übernimmt. Ein eng umrissenes Projekt lässt sich mit einer einfacheren Extraktions-API möglicherweise schneller in den Produktivbetrieb überführen.
Vorteile und Nachteile
- Vielfältige Möglichkeiten zur Datenerfassung auf einer Plattform
- Gehostete Browser unterstützen etablierte Automatisierungsbibliotheken
- Vorgefertigte APIs und Datensätze verkürzen die Einrichtungszeit
- Für verschiedene Produkte müssen die Kosten jeweils separat geplant werden
- Auch für eigene Pipelines muss die technische Verantwortung übernommen werden
2. Firecrawl
Firecrawl ist unsere Empfehlung für Entwickler, die Webinhalte in nützlichen Kontext für eine KI-Anwendung umwandeln. Die Such-, Scraping-, Mapping- und Crawl-Tools decken den gesamten Weg von der Suche nach einer Seite bis zur Erfassung einer Website ab. Markdown und strukturiertes JSON verringern den Bereinigungsaufwand nach dem Abruf. So kann ein Rechercheassistent oder ein Wissensdatenbankprodukt mehr Zeit für die Beantwortung von Fragen aufwenden und muss weniger Navigationsmenüs aus rohem HTML entfernen.
Das aktuelle Angebot Interact erweitert die Plattform um die Arbeit mit Live-Browsern. Agenten können Aktionen in natürlicher Sprache beschreiben oder Browser-Code ausführen, den Status zwischen Aufrufen beibehalten und authentifizierte Profile wiederverwenden. Das ist eine wichtige Ergänzung für Seiten, auf denen vor der Extraktion Klicks, Filter oder eine Anmeldung erforderlich sind. Dank MCP- und Kommandozeilenzugriff lässt sich Firecrawl auch gut in Entwicklungsabläufe für Agenten integrieren und ist nicht nur als herkömmliche Anwendungs-API geeignet.
Firecrawl eignet sich besonders, wenn die Beschaffung von Inhalten das unmittelbare Problem ist und die Anwendung Speicherung und Abruf bereits selbst verwaltet. Teams müssen weiterhin die Grenzen des Crawls festlegen, die Quell-URLs bewahren und zwischen einem fehlenden und einem leeren Feld unterscheiden. Der Open-Source-Code bietet eine weitere Bereitstellungsoption. Teams sollten jedoch die konkreten Funktionen und betrieblichen Anforderungen ihrer gewählten Bereitstellungsart prüfen, statt davon auszugehen, dass gehostete und selbst verwaltete Versionen identisch sind.
Vorteile und Nachteile
- Markdown und JSON eignen sich für KI-Pipelines
- Interact unterstützt zustandsbehaftete Browseraufgaben
- Zugriff über API, MCP und CLI
- Abgerufene Inhalte müssen weiterhin validiert werden
- Selbst verwaltete Bereitstellungen erfordern Betriebsaufwand
3. Apify
Apify ist hier die beste Wahl für Teams, die wiederverwendbare Scraping-Tools und eine Plattform für deren Betrieb suchen. Auf dem Marktplatz werden Actors angeboten: vorgefertigte Programme, die Eingaben entgegennehmen, in der Cloud ausgeführt werden und Ergebnisse zurückgeben. Vorhandene Actors können gängige Erfassungsaufgaben beschleunigen, während Entwickler mit eigenen Actors ihre individuelle Extraktionslogik beibehalten können. So bildet Apify eine nützliche Brücke zwischen einem Experiment und einem wiederholbaren Produktionsauftrag.
Die Plattform übernimmt wichtige betriebliche Aufgaben, darunter Zeitplanung, Ergebnisspeicherung, Proxy-Zugriff, Überwachung und Integrationen. Entwickler können außerdem mit Crawlee arbeiten, der Open-Source-Bibliothek für Crawling und Browserautomatisierung. Der MCP-Server von Apify stellt AI-Agenten Actors zur Verfügung. Dadurch kann dasselbe vorgefertigte Tool eine Anwendung, eine geplante Pipeline oder einen Assistenten bedienen, ohne dass für jede Schnittstelle eine separate Scraping-Lösung entwickelt werden muss.
Die Auswahl der Actors verdient ebenso viel Aufmerksamkeit wie die Wahl der Plattform. Verschiedene Anbieter können sich bei Preisen, Wartungsaufwand, Eingabemöglichkeiten und Ausgabequalität unterscheiden. Ein erfolgreicher Durchlauf beweist außerdem nicht, dass alle erwarteten Datensätze erfasst wurden. Apify überzeugt besonders dann, wenn jemand für das Schema des Auftrags verantwortlich ist, Änderungen überwacht und die Kosten für den ausgewählten Actor sowie die Infrastruktur einplant. Für eine manuelle Extraktion von nur einer Seite ist ein derart umfangreiches Orchestrierungssystem selten nötig.
Vorteile und Nachteile
- Vorgefertigte und eigene Actors nutzen dieselbe Plattform
- Zeitplanung, Speicherung und Überwachung unterstützen wiederholbare Aufträge
- MCP integriert Actors in Arbeitsabläufe von Agenten
- Wartungsaufwand und Qualität der Actors variieren
- Nutzungs- und Actor-Gebühren müssen eingeplant werden
4. Browse AI
Browse AI empfehlen wir Geschäftsanwendern, die regelmäßig Webdaten benötigen, ohne dafür ein Softwareprojekt aufsetzen zu müssen. Die aktuelle Einrichtung kann eine bereitgestellte Seite auslesen, eine Datenstruktur vorschlagen und es den Nutzern ermöglichen, die Felder zu prüfen oder anzupassen. Das Trainieren von Robotern bleibt entscheidend für wiederholbare Extraktionen. Dieser praktische Ansatz eignet sich für Betriebs- und Marketingteams, die Produktangebote, Verzeichniseinträge oder Informationen über Wettbewerber in vertraute Tabellen übernehmen.
Eine besondere Stärke ist die Überwachung. Roboter können Seiten nach einem Zeitplan prüfen, Ergänzungen oder Änderungen erkennen und Benachrichtigungen senden, aus denen hervorgeht, was sich geändert hat. Workflows können die Datenerfassung über mehrere Seiten hinweg verknüpfen, während API-, Webhook- und Tabellenkalkulationsintegrationen dafür sorgen, dass die Ergebnisse in die bereits verwendeten Tools eines Teams gelangen. So kann ein Workflow zur Preisüberwachung zu einem laufenden Geschäftsprozess werden, statt aus einer Reihe manueller Browserprüfungen zu bestehen.
Die einfache Bedienbarkeit macht eine klare Definition der Daten nicht überflüssig. Nutzer sollten festlegen, welche Änderungen eine Benachrichtigung rechtfertigen, und prüfen, ob Seitennavigation, Anmeldeschritte und leere Ergebnisse korrekt verarbeitet werden. Größere Neugestaltungen können weiterhin Eingriffe erfordern. Browse AI eignet sich am besten, wenn ein Geschäftsteam die extrahierten Zeilen prüfen und den Roboter warten kann; Entwickler, die eine streng versionierte Browserlogik benötigen, bevorzugen möglicherweise einen codebasierten Dienst.
Vor- und Nachteile
- KI-gestützte Feldeinrichtung senkt die Einstiegshürde
- Geplante Überwachung hebt relevante Änderungen hervor
- Verbindungen zu Tabellenkalkulationen, APIs und Webhooks
- Größere Änderungen an Websites können ein erneutes Training erfordern
- Komplexe Logik erfordert eine sorgfältige Workflow-Gestaltung
5. SearchAPI
SearchAPI empfehlen wir als Speziallösung, um Suchergebnisse als strukturierte Daten zu erfassen. Die Google-API kann Ergebnislinks und Suchfunktionen im JSON-Format zurückgeben, sodass kein Parser für eine sich ändernde Ergebnisseite gewartet werden muss. Der umfassendere Katalog deckt Quellen wie Maps, Shopping, Nachrichten, Videos und unterstützte KI-Suchfunktionen ab. Besonders nützlich ist SearchAPI, wenn Recherche und Suchsichtbarkeit selbst das Datenprodukt sind und nicht nur ein Zwischenschritt auf dem Weg zum Crawlen einer anderen Website.
Die Lokalisierung ist ein wichtiger Aspekt dieser Eignung. Mit Parametern für Standort, Land, Sprache und Gerät können Teams einen Markt aus einem genau definierten Suchkontext heraus untersuchen. Eine SEO-Anwendung kann eine Suchanfrage in einer bestimmten Stadt verfolgen, während ein Rechercheassistent relevante Quellen finden und die zurückgegebenen Links für einen späteren Abruf speichern kann. Die Dokumentation der jeweiligen Suchmaschine ist wichtig, da sich die verfügbaren Parameter und Ergebnisfelder je nach Suchprodukt unterscheiden.
SearchAPI sollte nach den Suchmaschinen und Feldern ausgewählt werden, die ein Workflow tatsächlich benötigt. Ein Suchergebnis enthält nicht den vollständigen Inhalt der verlinkten Seite, und umfangreichere Ergebnisansichten folgen nicht alle demselben Schema. Teams sollten das Anfragevolumen einplanen, den erforderlichen Durchsatz bestätigen und fehlende Ergebnisabschnitte angemessen verarbeiten. Für das Extrahieren beliebiger Websites oder eine interaktive Browsersitzung ist ein anderes Tool in diesem Leitfaden der bessere Ausgangspunkt.
Vor- und Nachteile
- Strukturierte Ergebnisse machen die Wartung von Parsern für Suchergebnisseiten überflüssig
- Umfassender Katalog an Suchmaschinen und verwandten Diensten
- Detaillierte Steuerelemente zur Lokalisierung
- Suchergebnisse ersetzen nicht die Extraktion von Inhalten der Zielseite
- Felder und Parameter unterscheiden sich je nach Suchmaschine
6. Octoparse
Octoparse zeigt seinen AI Copilot und die Automatisierung mit menschlicher Beteiligung. Video: Octoparse.
Octoparse eignet sich gut für Analysten, die einen Scraper visuell entwerfen und anschließend wiederholt ausführen möchten. Die aktuelle Plattform bietet vorgefertigte Vorlagen, eine Einrichtung mit AI Assistant und eine automatische Seitenerkennung in der Desktop-Anwendung. Nutzer können die daraus entstehende Aufgabe verfeinern, statt mit Browsercode zu beginnen. Diese Flexibilität ist hilfreich, um Produktkataloge, Verzeichnisse oder Angebotslisten zu erfassen, bei denen die Abfolge der Seiten ebenso wichtig ist wie die Felder auf den einzelnen Seiten.
Durch die Cloud-Ausführung wird eine vorbereitete Aufgabe zu einem wiederkehrenden Datenerfassungsprozess, ohne dass ein persönlicher Computer eingeschaltet bleiben muss. Zeitplanung, parallele Ausführung, IP-Rotation und Exportverbindungen helfen dabei, auch umfangreichere Aufträge über einen Desktop-Prototyp hinaus zu skalieren. Der visuelle Ansatz ist besonders attraktiv für Teams, die ihre Quellwebsites und Datenanforderungen kennen, aber keinen eigenen Browser-Automatisierungsdienst warten möchten.
Bei Octoparse zahlt sich eine sorgfältige Aufgabengestaltung weiterhin aus. Seitennavigation, endloses Scrollen, Formulareingaben und doppelte Datensätze können die Bedeutung eines scheinbar erfolgreichen Durchlaufs verändern. Cloud-Kontingente und Tarifmerkmale sollten zum geplanten Zeitplan und Datenvolumen passen. Wir empfehlen Octoparse, wenn ein Team mehr Kontrolle über die Extraktionsschritte möchte, als ein schnelles Ein-Klick-Tool bietet, und eine klar benannte Person dafür zuständig ist, die Aufgabe bei Änderungen an den Quellseiten anzupassen.
Vor- und Nachteile
- Vorlagen und KI-Unterstützung erleichtern die Einrichtung
- Die visuelle Bearbeitung ermöglicht detaillierte Extraktionsaufgaben
- Cloud-Ausführungen ermöglichen eine geplante Datenerfassung
- Komplexe Websites erfordern eine Anpassung der Aufgaben
- Cloud-Funktionen hängen vom gewählten Tarif ab
7. Browserless
Browserless empfehlen wir Entwicklerinnen und Entwicklern, die einen Browser steuern und Hosting sowie Skalierung einem verwalteten Dienst überlassen möchten. Vorhandene Puppeteer- oder Playwright-Skripte können eine Verbindung zu Remote-Browsern herstellen. Das macht den Dienst für Projekte attraktiv, in denen bereits funktionierender Automatisierungscode zum Einsatz kommt. Besonders nützlich ist das, wenn die Datenerfassung mehrere Interaktionen, eine JavaScript-intensive Oberfläche oder eine Sitzung umfasst, die länger als eine einzelne einfache Anfrage bestehen bleiben muss.
Der Dienst bietet außerdem REST-APIs für Scraping, Screenshots, PDFs und benutzerdefinierte Browserfunktionen. Über den gehosteten MCP-Server können KI-Agenten Browser-Tools nutzen; Sitzungsfunktionen und authentifizierte Profile unterstützen Arbeitsabläufe, die Kontinuität erfordern. Browserless eignet sich daher sowohl für Entwicklerinnen und Entwickler, die einen eigenen Datensammler erstellen, als auch für Agenten, die mit einem echten Browser navigieren und Informationen sammeln müssen.
Entscheidend bei der Auswahl ist, wie die Browsernutzung abgerechnet wird. Der kostenlose Tarif umfasst derzeit 1.000 Einheiten pro Monat und zwei gleichzeitig nutzbare Browser, nicht jedoch 1.000 garantierte Scraping-Vorgänge. Die Browsernutzung verbraucht Einheiten; für Proxy-Traffic und erfolgreich gelöste CAPTCHAs fallen zusätzliche Gebühren an. Die Sitzungslimits unterscheiden sich je nach Tarif. Die Teams bleiben für die Extraktionslogik und die Überprüfung der Ergebnisse verantwortlich. Browserless ist daher besonders interessant, wenn die Kontrolle über den Browser wichtiger ist als ein visueller Scraper-Baukasten.
Vor- und Nachteile
- Ermöglicht die Nutzung vertrauter Puppeteer- und Playwright-Arbeitsabläufe
- REST-APIs decken Scraping und den Export von Seiten ab
- Sitzungsfunktionen und MCP eignen sich für interaktive Agenten
- Browsernutzung und Zusatzoptionen beeinflussen den Einheitenverbrauch
- Für die benutzerdefinierte Extraktion ist weiterhin Anwendungslogik erforderlich
8. ScrapingBee
ScrapingBee ist eine gute Wahl für Entwicklerinnen und Entwickler, die eine verwaltete Scraping-Anfrage statt direkter Kontrolle über einen dauerhaft laufenden Browser wünschen. Die API kombiniert den Abruf von Seiten und das Rendern von JavaScript mit Proxy-Verwaltung. Für die Extraktion lassen sich CSS- oder XPath-Regeln sowie KI-Anweisungen verwenden. Diese Kombination ist nützlich, wenn ein Projekt strukturierte Datensätze von mehreren Websites benötigt, aber keine eigene Browserflotte betreiben soll.
JavaScript-Szenarien können vor der Datenerfassung klicken, scrollen, Text eingeben oder warten. Die Markdown-Ausgabe unterstützt KI-gestützte Inhaltsabläufe, und Screenshots helfen dabei, die gerenderte Seite zu erfassen. Das aktuelle Produkt bietet außerdem spezielle APIs für ausgewählte Ziele sowie Zugriff über CLI und MCP. Entwicklerinnen und Entwickler können für stabile Felder explizite Extraktionsregeln verwenden und bei weniger vorhersehbarer Seitenstruktur oder Fragestellung die Extraktion in natürlicher Sprache nutzen.
Der praktische Unterschied zu einer gehosteten Browserplattform: ScrapingBee konzentriert sich auf die Anfrage und das zurückgegebene Ergebnis, während eine benutzerdefinierte Anwendung den gesamten übrigen Prozess verwaltet. Die Koordination mehrerer Seiten, die Deduplizierung, Aktualisierungspläne und die Validierung der Datensätze müssen weiterhin an anderer Stelle abgedeckt werden. Auch der Verbrauch von Credits hängt von den genutzten Funktionen ab, darunter Rendering und Proxy-Optionen. Wir empfehlen ScrapingBee Anwendungsteams, die eine unkomplizierte HTTP-Schnittstelle schätzen und die Orchestrierung ihrer Datenpipeline im eigenen Code behalten möchten.
Vor- und Nachteile
- Selektorregeln und KI-Extraktion bieten Flexibilität
- Rendering und Szenarien unterstützen interaktive Seiten
- Markdown, CLI und MCP unterstützen KI-Workflows
- Erweiterte Anfrageoptionen erhöhen den Credit-Verbrauch
- Aufträge über mehrere Seiten hinweg erfordern weiterhin Orchestrierung
9. Oxylabs
Oxylabs ist eine gute Option für Teams, die verwalteten Zugriff auf schwer zugängliche öffentliche Websites und die Möglichkeit zur Datenerfassung in größerem Umfang wünschen. Die aktuelle Web API umfasst das Angebot /Scrape zum Abruf und zur Strukturierung von Webdaten; JavaScript-Rendering und Zugriffsverwaltung sind in den Dienst integriert. Zum Produktangebot gehören außerdem /Search und Browserinfrastruktur. Je nachdem, ob eine Aufgabe mit Recherche, Extraktion oder Interaktion beginnt, stehen Teams somit verschiedene Ansätze zur Verfügung.
Zielspezifische Optionen helfen dabei, aus gängigen Such- und Handelsquellen nützliche Felder abzurufen. Über MCP und Agent Skills lassen sich Datenerfassungsprozesse in KI-Workflows einbinden. Oxylabs dokumentiert seine Classic Web Scraper API weiterhin separat. Dieser Unterschied ist bei bestehenden Integrationen wichtig: Teams, die die Classic API nutzen, sollten sich an der dazugehörigen Dokumentation orientieren und nicht davon ausgehen, dass ein neueres Beispiel für die Web API damit austauschbar ist.
Oxylabs ist vor allem dann sinnvoll, wenn die Schwierigkeit des Zugriffs auf Zielseiten, der Durchsatz oder die Kosten für die Pflege der Zugriffsinfrastruktur eine verwaltete Plattform rechtfertigen. Die Anwendung muss weiterhin das gewünschte Datenschema, den Aktualitätszeitraum und den Umgang mit unvollständigen Datensätzen festlegen. Vor der Einführung sollten die ausgewählte API-Generation, die Zieloptionen und das Nutzungsmodell auf den konkreten Auftrag abgestimmt werden. Für eine kleine manuelle Extraktion kann ein visueller Scraper besser geeignet sein.
Vor- und Nachteile
- Verwaltete Infrastruktur für Rendering und Zugriff
- Zielgerichtete Optionen für die strukturierte Datenextraktion
- Die aktuelle Web-API unterstützt die Integration von Agenten
- Für die klassische und die aktuelle API ist jeweils eine separate Einrichtung erforderlich
- Die Ausgabequalität muss weiterhin in der Anwendung geprüft werden
10. Diffbot
Diffbot ist unsere Empfehlung, wenn es wichtiger ist, die Informationen auf einer Seite zu verstehen, als ihr Layout nachzubilden. Extract nutzt Computer Vision und die Verarbeitung natürlicher Sprache, um Seiten zu klassifizieren und anhand standardisierter Schemata strukturiertes JSON auszugeben. Für Teams, die Artikel oder Produkte aus vielen Quellen erfassen, kann das den Umfang des websitespezifischen Parsing-Codes verringern, der nötig ist, um Seiten in vergleichbare Datensätze umzuwandeln.
Der Knowledge Graph deckt einen verwandten, aber eigenständigen Bedarf ab: die Arbeit mit Entitäten wie Organisationen, Personen und Artikeln, die bereits aus dem öffentlichen Web zusammengetragen wurden. Datensätze können Informationen aus mehreren Quellen zusammenführen und Entitäten über aussagekräftige Beziehungen miteinander verknüpfen. Dadurch eignet sich Diffbot für die Anreicherung von Daten, die Unternehmensrecherche und Informationsanwendungen, die über die auf einer einzelnen Seite sichtbaren Felder hinaus Kontext benötigen.
Der Kompromiss besteht darin, dass die Lösung an das Datenmodell von Diffbot gebunden ist. Die standardisierte Extraktion ist wertvoll, wenn die Seitentypen und Felder zum jeweiligen Zweck passen; bei ungewöhnlichen Feldern oder speziellen Interaktionen kann jedoch ein anderer Ansatz nötig sein. Teams sollten zwischen der Extraktion aus selbst ausgewählten URLs und der Abfrage eines bestehenden Knowledge Graph unterscheiden und anschließend die Abdeckung sowie die Aktualität der Quellen entsprechend bewerten. Diffbot eignet sich besser für technische Teams, die normalisierte Informationsprodukte entwickeln, als für Nutzer, die lediglich ein paar Zeilen in eine Tabelle kopieren möchten.
Vor- und Nachteile
- Die automatische Klassifizierung reduziert den Aufwand für Parser
- Standardisierte Schemata erleichtern die Normalisierung ähnlicher Seiten
- Der Knowledge Graph liefert zusätzlichen Kontext zu Entitäten
- Standardfelder decken spezielle Anforderungen möglicherweise nicht ab
- Extraktion und Graphzugriff unterstützen unterschiedliche Arbeitsabläufe
Häufig gestellte Fragen
Was macht ein Web-Scraping-Tool KI-gestützt?
KI kann dabei helfen, Felder zu erkennen, Seiteninhalte zu interpretieren, Extraktionsschritte zu erstellen oder Browseraktionen zu steuern. Einige Tools nutzen KI bei der Einrichtung, andere bei jeder Extraktion. Ein Dienst kann KI-Anwendungen auch unterstützen, indem er saubere Inhalte bereitstellt, ohne für jede Anfrage ein Sprachmodell zu verwenden. Entscheiden Sie sich für die Funktion, die Ihr Datenerfassungsproblem löst, statt sich auf die Bezeichnung zu verlassen.
Worin besteht der Unterschied zwischen Scraping und Browser-Automatisierung?
Beim Scraping werden Informationen erfasst. Die Browser-Automatisierung führt Aktionen auf einer Seite aus, etwa Menüs zu öffnen, eine Suche einzugeben oder einen mehrstufigen Arbeitsablauf zu durchlaufen. Häufig kommen beide Verfahren gemeinsam zum Einsatz: Ein automatisierter Browser ruft den relevanten Seitenzustand auf, anschließend erfasst ein Extraktionsschritt die gewünschten Felder. Eine direkte API-Anfrage ist in der Regel einfacher, wenn solche Interaktionen nicht erforderlich sind.
Welche Tools eignen sich am besten für Teams ohne technische Vorkenntnisse?
Für unkomplizierte, wiederkehrende Datenerfassungen und die Überwachung von Änderungen empfehlen wir zuerst Browse AI. Octoparse ist eine gute Alternative für Teams, die mehr visuelle Kontrolle über die einzelnen Aufgabenschritte wünschen. Beide Tools eignen sich am besten, wenn jemand die erstellten Datensätze überprüft und erkennt, wann sich die Quellwebsite geändert hat.
Welche Daten sollte eine KI- oder RAG-Pipeline aus einem Scraping-Vorgang übernehmen?
Bewahren Sie die Quell-URL, den Erfassungszeitpunkt, den Seitentitel sowie den Text oder die strukturierten Felder auf, die die Anwendung benötigt. Markdown kann die lesbare Dokumentstruktur erhalten, während JSON definierte Datensätze unterstützt. Entfernen Sie doppelte Inhalte und vermeiden Sie, Navigationstext mit dem Hauptinhalt zu vermischen. Wenn die Herkunft der Daten nachvollziehbar bleibt, lassen sich spätere Antworten leichter überprüfen und aktualisieren.
Wann lohnt sich der Einsatz eines verwalteten Browsers?
Ein verwalteter Browser ist nützlich, wenn die Datenerfassung die Ausführung von JavaScript, mehrere Interaktionen oder eine durchgehende Sitzung erfordert und Ihr Team keine Browserprozesse hosten möchte. Browserless ist eine spezialisierte Option für vorhandenen Puppeteer- oder Playwright-Code. Für eine einzelne statische Seite beansprucht eine einfachere Abruf- oder Extraktions-API möglicherweise weniger Ressourcen.
Sind 1.000 kostenlose Einheiten dasselbe wie 1.000 Scraping-Vorgänge?
Nein. Die Regeln für Einheiten und Guthaben unterscheiden sich je nach Anbieter. Browserless rechnet Browserverbindungen in Zeitblöcken von bis zu 30 Sekunden ab; für Proxy-Traffic und das Lösen von CAPTCHAs werden zusätzliche Einheiten verbraucht. Andere Dienste berechnen ihre Gebühren anhand von Anfrageoptionen, Datensätzen oder Rechenleistung. Schätzen Sie die Kosten für den gesamten Arbeitsablauf, statt unterschiedliche Freikontingente gleichzusetzen.
Kann man einem KI-Extraktionsergebnis ohne Prüfung vertrauen?
Auch eine gültige JSON-Antwort kann einen Datensatz auslassen oder ein Feld falsch interpretieren. Legen Sie Pflichtfelder fest, prüfen Sie Datentypen und Wertebereiche, kontrollieren Sie Stichproben der Quellseiten und beobachten Sie Änderungen der Datensatzanzahl. Bei wiederkehrenden Aufträgen sind ausdrücklich definierte Fehlerzustände und Zustände mit leeren Ergebnissen hilfreicher, als jede Antwort als vollständigen Datensatz zu behandeln.
Abschließende Gedanken zu KI-Tools für Web-Scraping
Bright Data ist unsere erste Wahl für ein umfassendes Webdatenprogramm, während Firecrawl den besten Einstieg bietet, um Webseiten in KI-taugliche Inhalte umzuwandeln. Entscheiden Sie sich für Apify, wenn wiederverwendbare Tools, zeitgesteuerte Jobs und Cloud-Betrieb im Mittelpunkt des Projekts stehen.
Für Geschäftsteams macht Browse AI die regelmäßige Überwachung leicht zugänglich, und Octoparse bietet Nutzern eine visuelle Möglichkeit, anspruchsvollere Extraktionsaufgaben anzupassen. SearchAPI ist die Speziallösung, wenn strukturierte Suchdaten benötigt werden.
Browserless ist eine gute Wahl für Entwickler, die eine verwaltete Browserausführung mit vertrauten Automatisierungsbibliotheken nutzen möchten. ScrapingBee ist eine überzeugende Alternative, wenn eine verwaltete Extraktionsanfrage besser zur Anwendung passt. Oxylabs eignet sich für anspruchsvolle Datenabrufe aus dem öffentlichen Web, während sich Diffbot durch standardisierte Extraktion und die Erfassung von Informationen zu Entitäten auszeichnet.
Langfristig ist die beste Wahl diejenige, die die benötigten Informationen über einen Arbeitsablauf liefert, den Ihr Team aufrechterhalten kann. Stimmen Sie die Erhebungsmethode auf die Aufgabe ab, bewahren Sie den Kontext der Quelle und beurteilen Sie den Nutzen anhand der verwertbaren Ergebnisse statt anhand der Anzahl der angefragten Seiten.




