
KI-Modelle und Plattformen
ASUS stellt auf der OCP einen XA P2N-E2-Server mit zwei NVIDIA Vera CPUs vor

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
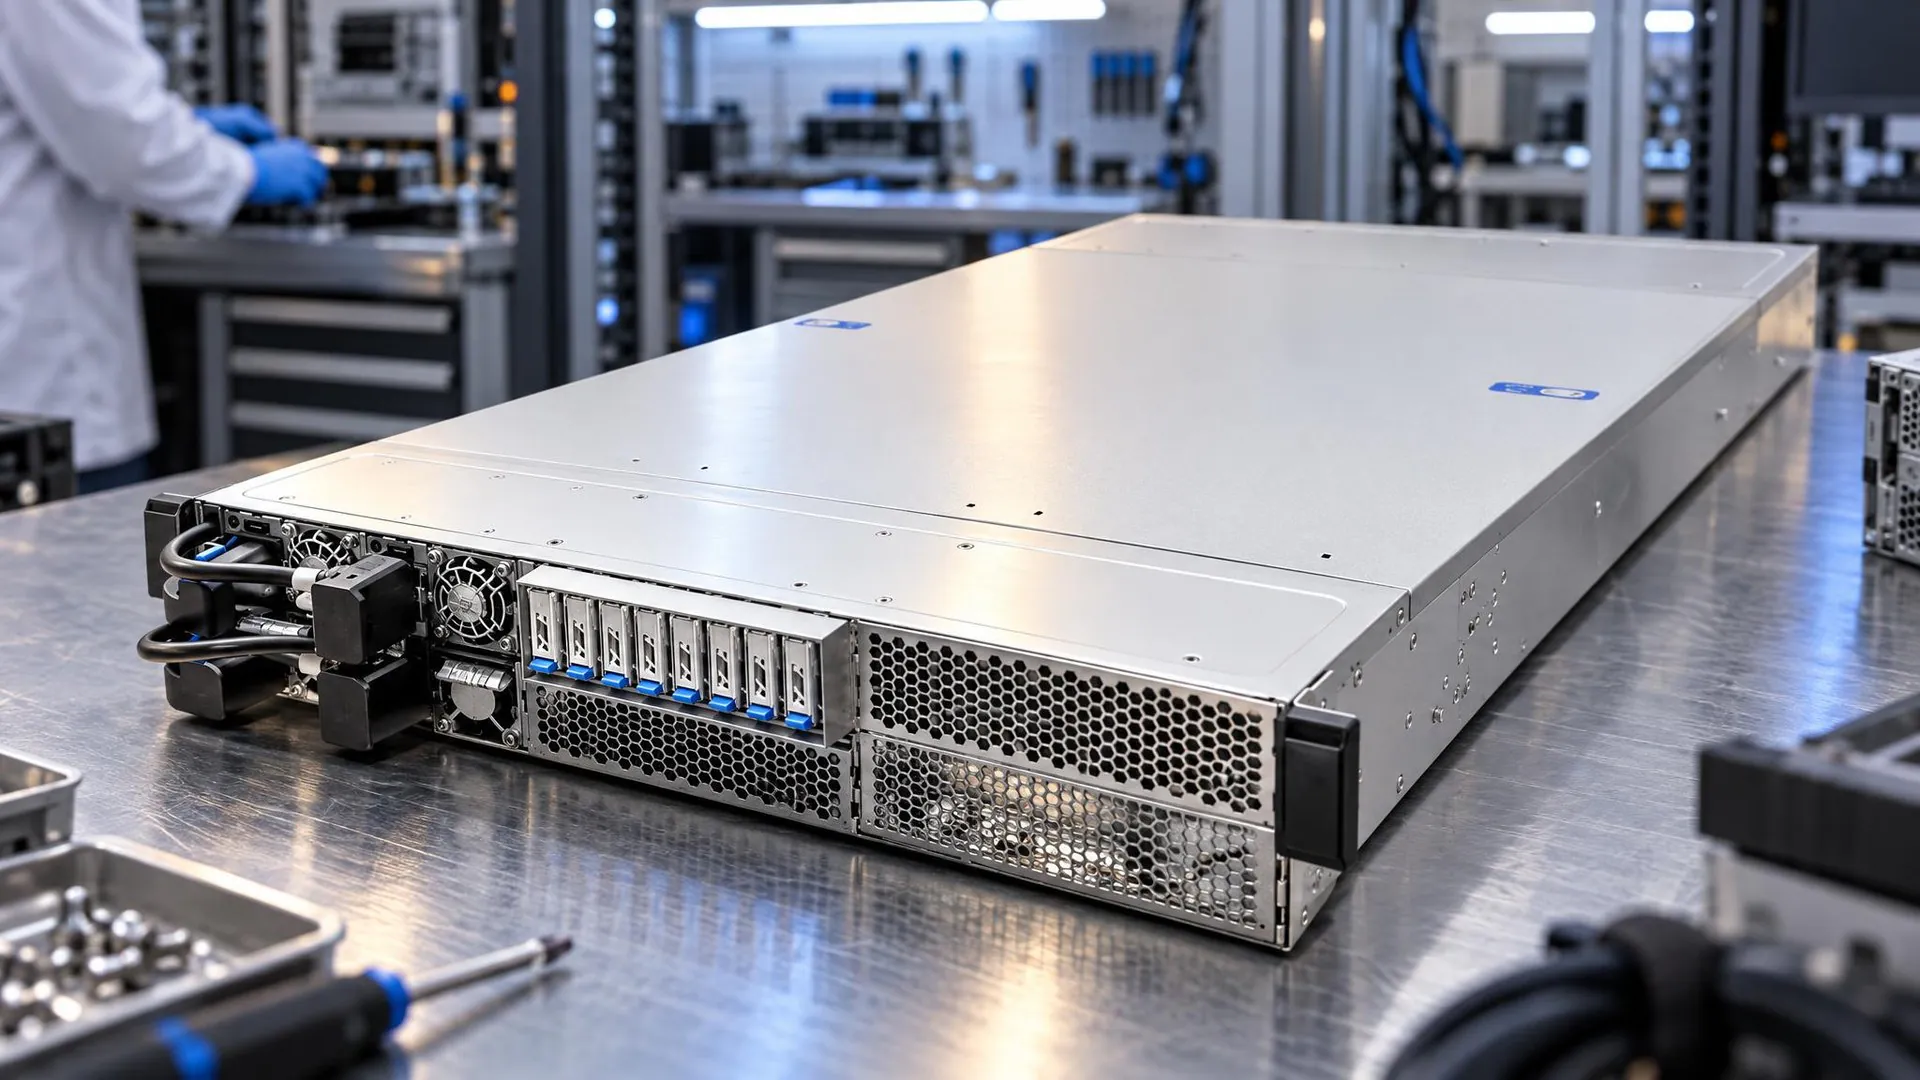
ASUS hat auf dem OCP Global Summit 2026 am 12. Oktober 2026 in San Jose, Kalifornien, den XA P2N-E2 vorgestellt, einen 2U-Server auf Basis der NVIDIA-MGX-Architektur, der von zwei NVIDIA Vera CPUs angetrieben wird. In einer Pressemitteilung erklärte das Unternehmen, das System sei für agentische KI und Workloads des bestärkenden Lernens ausgelegt.
Laut der Mitteilung zielt der Server auf die Ausführungsebene von KI-Anwendungen ab und übernimmt die Codeausführung, die Nutzung von Tools, die Sandbox-Isolierung, die Datenverarbeitung und die Orchestrierung – Aufgaben, die über das KI-Modell selbst hinausgehen. Der XA P2N-E2 unterstützt bis zu zwei NVIDIA RTX PRO 6000 Blackwell Server Edition GPUs mit jeweils zwei Steckplätzen und verbindet so CPU-Rechenleistung mit GPU-Beschleunigung in der 2U-Plattform. ASUS zufolge sollen die Einzelthread-Leistung der CPU und der energieeffiziente Speicher mit hoher Bandbreite dafür sorgen, dass KI-Agenten auch bei anspruchsvollen Ausführungs- und Evaluierungsaufgaben reaktionsschnell bleiben.
Zwei Vera-Prozessoren in einem luftgekühlten 2U-Gehäuse
Auf der Produktseite des XA P2N-E2, die mit der Kennzeichnung „NEU“ versehen ist, werden zwei NVIDIA Vera-Prozessoren aufgeführt. Jeder davon integriert 88 maßgeschneiderte Olympus-Kerne mit Spatial Multithreading für 176 Threads und hat eine TDP von bis zu 480 W pro Sockel. ASUS beschreibt Vera als die erste speziell für KI-Agenten entwickelte CPU: Im von ASUS skizzierten Workflow übernimmt die CPU die Ausführung von Code in einer Sandbox, die Nutzung von Tools, die Orchestrierung und die Datenverarbeitung, während die GPUs weiterhin ausschließlich für Training und Inferenz eingesetzt werden.
NVIDIA NVLink-C2C der zweiten Generation ermöglicht laut Produktseite eine kohärente CPU-zu-CPU-Kommunikation mit bis zu 1,8 TB/s und eine Kern-zu-Kern-Bandbreite von bis zu 3,4 TB/s. Der Speicher besteht aus 16 SOCAMM2-Modulen mit LPDDR5X und 9600 MT/s sowie einer Kapazität von bis zu 1,5 TB. ASUS zufolge bietet diese Konfiguration bis zu doppelt so viel Energieeffizienz wie herkömmlicher RDIMM-Speicher und senkt den Speicherstromverbrauch um 50 %.
Der Speicher umfasst acht Hot-Swap-fähige E1.S-Laufwerksschächte. Zur Erweiterung stehen zwei PCIe-Gen6-x16-Steckplätze sowie ein dedizierter Steckplatz mit zwei Slots für DPU/NIC-Karten zur Verfügung. Das vollständig luftgekühlte Gehäuse leitet die Luft von vorn nach hinten durch die Bereiche für Prozessoren, Speicher und GPUs. Es verfügt über redundante 2+2-Netzteile mit 2000 W und 80 PLUS Titanium und benötigt keine Flüssigkühlungsinfrastruktur. Beim modularen MGX-Design lassen sich das Host-Prozessormodul und der GPU-Einschub unabhängig voneinander warten. Letzterer bietet Platz für bis zu zwei RTX PRO 6000 Blackwell Server Edition GPUs mit jeweils zwei Slots und einer Leistungsaufnahme von bis zu 600 W.
Vier Hardware-Engpässe, die ASUS bei agentischer KI identifiziert
In einer Analyse vom 10. August 2026 benannte ASUS vier Hardware-Engpässe, die den Einsatz agentischer KI seiner Ansicht nach begrenzen: unzureichende Einzelthread-Leistung bei der Skalierung, zu geringe Speicherbandbreite pro Kern, Latenzen beim datenübergreifenden Zugriff zwischen Dies und fehlende Sandbox-Isolierung auf Hardwareebene. Das Unternehmen erklärte, der XA P2N-E2 behebe den zuletzt genannten Engpass durch hardwarebasierte Sandbox-Isolierung für die Codeausführung von Agenten. ASUS führte außerdem an, dass die Vera-CPU eine bis zu 1,8-mal höhere Einzelthread-Leistung als herkömmliche x86-CPUs biete, die Ausführung von Sandbox-Code 1,8-mal so schnell wie auf herkömmlicher x86-Infrastruktur sei und Programmier-Workflows bis zu 1,5-mal schneller abliefen. ASUS führte diese Werte auf das 88-Kern-Design der Vera-CPU, eine LPDDR5X-Speicherbandbreite von bis zu 1,2 TB/s und eine interne Interconnect-Bandbreite von 3,4 TB/s zurück.
In der Analyse vom August war der XA P2N-E2 bereits als gemeinsam mit ASUS-Servern auf Basis von AMD EPYC 9006-Prozessoren vorgestelltes System beschrieben worden: den Serien RS700A-E14B, RS720A-E14B und XA P8A-E14A. Für diese Systeme nannte ASUS bis zu 256 Kerne pro Sockel und eine um rund 70 % höhere Gesamtleistung als bei der Vorgängergeneration. Der DDR5-Speicher mit 16 Kanälen erreicht eine Bandbreite von etwa 1,6 TB/s.
Rack-Systeme und NVIDIA-Plattformtechnologien
Neben dem 2U-Server zeigt ASUS auf der OCP auch Rack-Systeme. Das XA VR721-E3 ASUS AI POD integriert 36 NVIDIA Vera CPUs und 72 NVIDIA Rubin GPUs über die Plattform NVIDIA Vera Rubin NVL72 in einer vollständig flüssigkeitsgekühlten Architektur für das KI-Training, das Post-Training und die Inferenz im großen Maßstab. Der XR R1I12B-M1BHFS kombiniert NVIDIA HGX Rubin NVL8 mit direkter Flüssigkeitskühlung des GPU-Baseboards und Luftkühlung für Intel Xeon 6-Prozessoren.
ASUS verwies außerdem auf das NVIDIA DSX-Referenzdesign und den NVIDIA Omniverse DSX Blueprint. Diese vereinen laut ASUS eine validierte Architektur mit hochpräziser Simulation, um physikalisch genaue digitale Zwillinge zu erstellen und damit Design und Betrieb von KI-Fabriken vor deren Inbetriebnahme zu optimieren. Am ASUS-Stand werden vier NVIDIA-Technologien vorgestellt: beschleunigtes Rechnen mit HGX Rubin NVL8, Spectrum-X-Ethernet-Switching auf Basis von Spectrum-6, die CMX Context Memory Storage Platform und der Groq 3 LPX-Inferenzbeschleuniger für Vera Rubin NVL72. Laut Mitteilung erweitert dieser die NVL72-Plattform um eine extrem schnelle Token-Generierung für eine besonders reaktionsschnelle Inferenz.
Systeme von Intel und AMD im Rampenlicht
Die Intel-Präsentation umfasst die RS700-E12-RS4U- und RS720-E12-RS12U-Server, 1U- und 2U-Systeme mit zwei Sockeln, Intel Xeon 6-Prozessoren, DC-MHS-Designs und werkzeugloser Wartung. Sie richten sich an agentische KI, Virtualisierung und datenintensive Workloads. Im AMD-Bereich wird der RS700A-E14B-R16U vorgestellt, ein 1U-System mit zwei Sockeln auf Basis von AMD EPYC 9006-Prozessoren der 6. Generation mit dem Codenamen „Venice“. Es kombiniert die DC-MHS-Architektur mit PCIe-6.0-Konnektivität und unterstützt bis zu 16 E3.S-Laufwerke. ASUS Thermal Radar 3.0 übernimmt die Temperaturüberwachung und -verwaltung.
Für KI-Beschleunigungsanwendungen unterstützt der ESC8000A-E13P AMD Instinct MI350P-PCIe-Beschleuniger. Der XA AM3A-E13 integriert dagegen acht AMD Instinct MI355X-Beschleuniger in ein luftgekühltes 10U-Design, das laut ASUS hochverdichtete Implementierungen ohne spezielle Kaltwasserinfrastruktur ermöglicht. Das vollständige Portfolio wird am ASUS-Stand #B9 während des OCP Global Summit 2026 präsentiert. ASUS zufolge sind die Server weltweit erhältlich; die Verfügbarkeit einzelner Produkte und Konfigurationen variiert je nach Region.


