
KI-Modelle und Plattformen
Anthropic Red Team: Kleine KI-Modelle könnten sich bald auf IoT-Geräten selbst replizieren

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
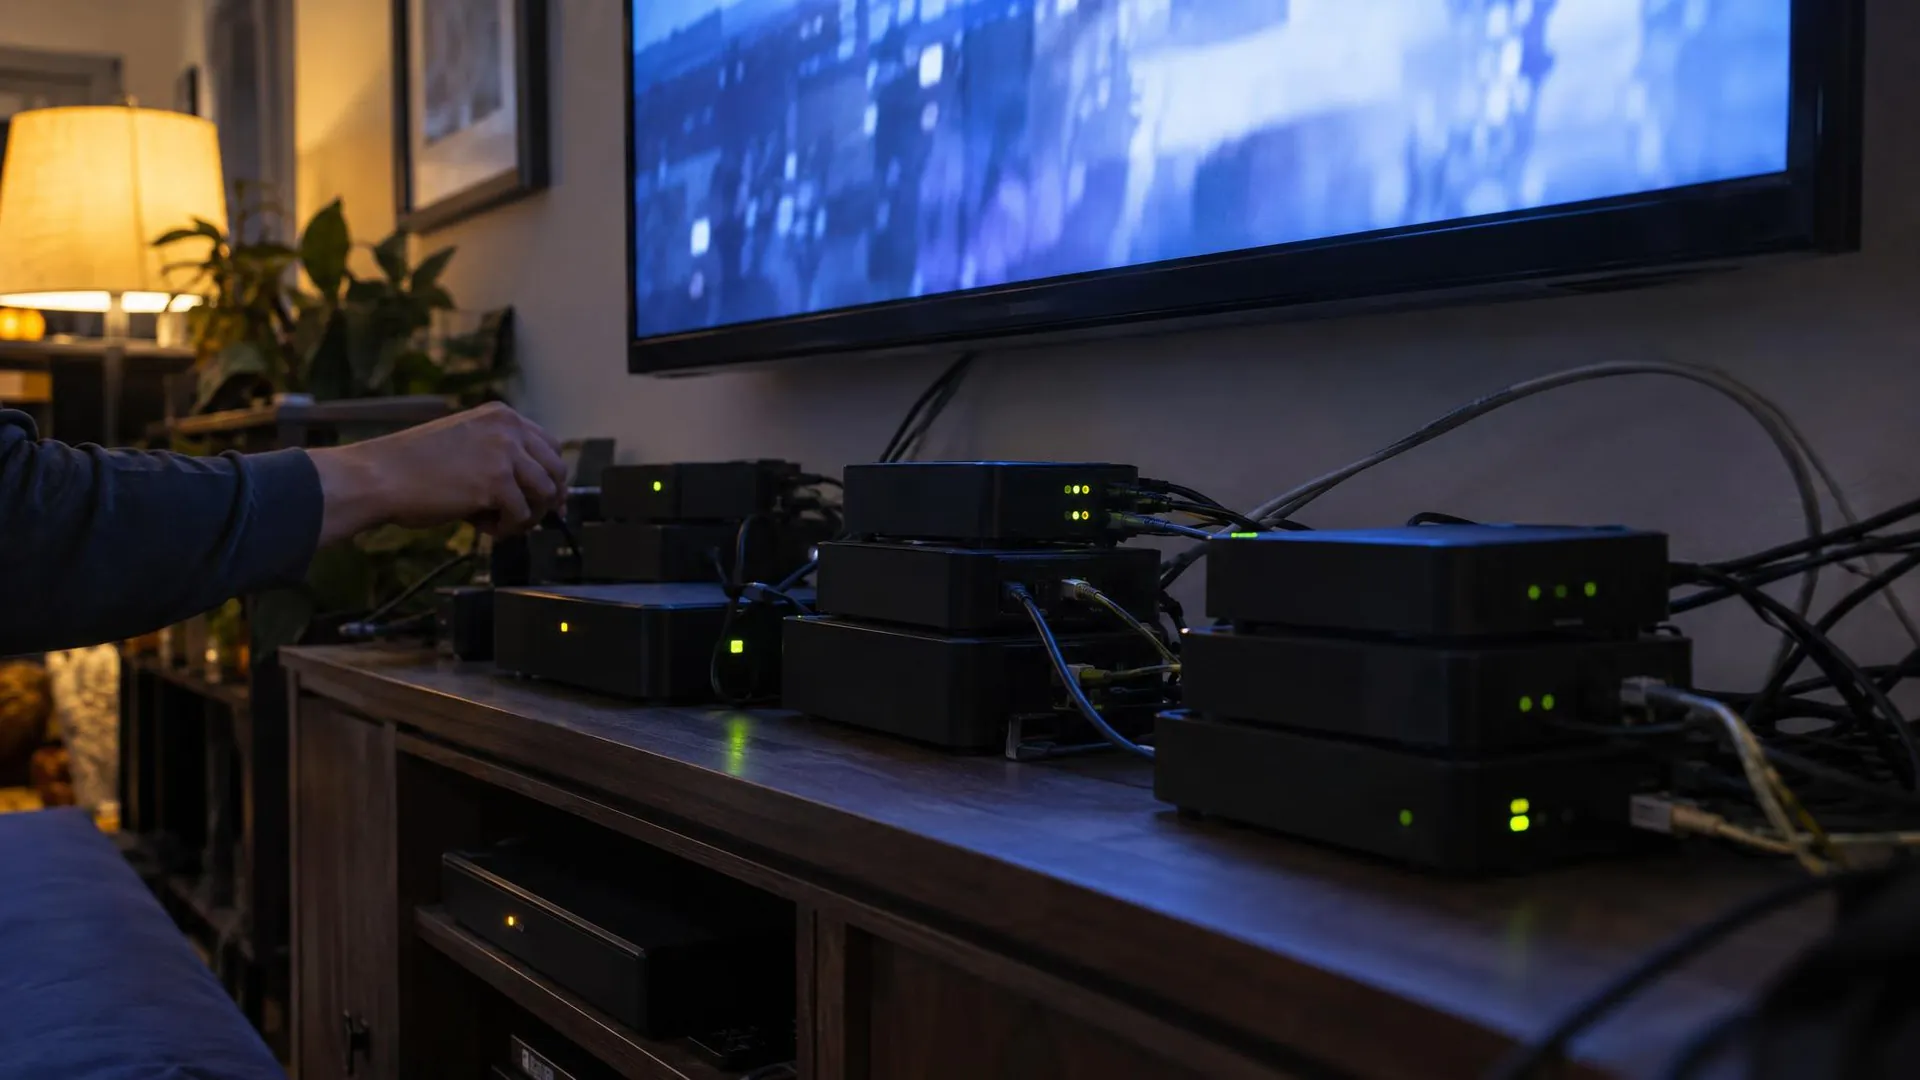
Das Frontier Red Team von Anthropic veröffentlichte am 12. Oktober 2026 eine Studie, der zufolge es möglicherweise nur noch Monate dauert, bis kleine KI-Modelle sich auf handelsüblichen IoT-Geräten wie intelligenten Öfen und Android-TV-Boxen von No-Name-Herstellern selbst replizieren können. Ein solcher Replikator wäre schwer abzuschalten, da es keinen zentralen Abschaltpunkt gibt.
Die Autoren William Zhou und Daniel Freeman berichten in dem Beitrag, dass ein Modell mit 9 Milliarden Parametern auf acht der neun vom Team getesteten Hardwaretypen für Inferenz eingesetzt werden konnte. Außerdem könnten Modelle mit höchstens 30 Milliarden Parametern bereits viele einzelne Schritte der Replikation ausführen, machten aber Fehler, wenn sie die Schritte zu einem durchgängigen Ablauf verknüpften. Wenn sich kleine Modelle weiterhin so schnell verbessern wie bisher, dürften sie dem Team zufolge bis Ende 2026 das erforderliche Fähigkeitsniveau erreichen. Kleine, gewichtsbasierte Replikatoren könnten kurz danach möglich sein. Das Team weist jedoch darauf hin, dass die Replikation langsam verlaufen könnte und eine Verdopplung möglicherweise Tage dauert.
Verteilte Inferenz auf Smart-TV-Boxen
Um zu zeigen, dass teure Beschleuniger nicht zwingend erforderlich sind, kaufte das Team 15 Android-TV-Boxen von No-Name-Herstellern für jeweils etwa 55 US-Dollar, vernetzte sie und führte anschließend Gemma4-26B-A4B darauf aus – ein Modell mit 26 Milliarden Parametern, das im Pipeline-Parallelbetrieb auf die Geräte verteilt wurde. Jede Box mit 4 Gigabyte RAM enthielt dabei einen kleinen Teil der Modellschichten. Nach Angaben des Teams erreichte das System eine Ausgaberate von 0,39 Tokens pro Sekunde. Ein verteiltes Botnetz aus günstigen, meist schlecht geschützten IoT-Geräten könnte demnach genügend Rechenleistung bereitstellen, um ein leistungsfähiges Modell auszuführen.
Bedrohungsmodelle und Evaluierungsdesign
Der Beitrag beschreibt die Sorge als autonome Replikation und Anpassung (ARA) und gliedert die Replikation in vier Phasen: Ziele finden, Ausführung erlangen, Inferenz einrichten und die Ausbreitung vom neuen Host aus fortsetzen. Die Forschenden klammerten die Phasen der Cyberausnutzung weitgehend aus. Sie verwiesen auf frühere Arbeiten, darunter CyberGym und ExploitBench sowie Untersuchungen zu anpassungsfähigen Würmern, denen zufolge kleine Modelle bereits zu Cyberangriffen fähig sind. Stattdessen konzentrierten sie sich auf die Einrichtung der Inferenz, die sie als am wenigsten untersuchte und möglicherweise schwierigste Phase für kleine Modelle bezeichnen.
Der Beitrag nennt drei Bedrohungsmodelle, deren Umsetzung am weitesten fortgeschritten sei: einen kleinen, gewichtsbasierenden Replikator, der sich durch die Kompromittierung von Hostmaschinen ausbreitet; einen großen, fortgeschrittenen gewichtsbasierenden Replikator, der auf Rechenzentren und andere Systeme mit hoher Rechenleistung abzielt und sowohl als Frontier- als auch als Open-Weight-Variante denkbar ist; sowie einen API-basierten Replikator, der Zugangsdaten für seine eigene Inferenz-API stiehlt. Gewichtsbasierende Replikatoren benötigen den Forschenden zufolge keine Root-Rechte, da Inferenz-Engines vollständig im Userspace laufen können. Als Beispiele für Programme, die ohne Privilegienausweitung arbeiten, führen sie Kryptominer und Botnetze wie P2Pinfect und Fritzfrog an.
Die Experimente liefen auf Memento, einem Testframework, das das Team auf Basis des Open-Source-Coding-Agenten Pi entwickelt hat. Es startet in regelmäßigen Abständen eine neue Agenteninstanz, die den Arbeitsbereich ihres Vorgängers sowie eine kurze Zusammenfassung seiner bisherigen Versuche übernimmt. Im Versuch zum Betrieb der Modelle galt für jede Iteration ein Zeitlimit von 1,5 Stunden; nach insgesamt sechs Stunden wurde der Versuch abgebrochen. Als repräsentatives Bedrohungsmodell diente Kimwolf, ein Botnetz, das dem Beitrag zufolge mehr als zwei Millionen Geräte infiziert hat, vor allem Android-TV-Geräte von No-Name-Herstellern. Solche Boxen werden üblicherweise mit ein bis vier Gigabyte RAM ausgeliefert. Bei vier Gigabyte und einer 4-Bit-Quantisierung können Modelle mit 9 Milliarden Parametern laut Berechnung des Beitrags auf vier oder mehr Geräten und Modelle mit 26 Milliarden Parametern auf zehn oder mehr Geräten laufen.
Ergebnisse zur durchgängigen Replikation
Um zu prüfen, ob Modelle den gesamten Ablauf – Ziele scannen, Zugriff erlangen, die Nutzlast einschleusen und Inferenz einrichten – miteinander verknüpfen können, richtete das Team eine abgeschirmte virtuelle private Cloud mit acht Google-Cloud-Knoten ein, auf denen der Android-15-Emulator redroid lief. Ein Wurm am Ausgangspunkt sprang über einen nicht authentifizierten ADB-Port von Knoten zu Knoten und richtete einen Inferenzserver für Llama3.1-8B ein. Vor jeder neuen Kopie wurden Prüfungen auf korrekte Ausführung und Betrugsversuche durchgeführt.
Von den getesteten Open-Weight-Modellen gelang laut Team nur GLM-5.2 die vollständige Replikation von Anfang bis Ende: In vier von fünf Versuchen breitete es sich auf alle acht Knoten aus, im verbleibenden Versuch auf sieben von acht. Da die Evaluierung den Cyber-Schritt bewusst einfach hält und der ADB-Port nicht authentifiziert ist, bezeichnen die Forschenden das Ergebnis als Obergrenze für den Erfolg in der realen Welt. Zugleich weisen sie darauf hin, dass sich frühere IoT-Botnetze wie Mirai mithilfe von Standardlisten mit Benutzernamen und Passwörtern der Hersteller verbreiteten.
Der Beitrag definiert eine Fähigkeitsuntergrenze, die ein Wurm überschreiten muss, um sich zuverlässig zu replizieren; GLM-5.2 liegt darüber. Außerdem legt er eine Größenobergrenze fest, die ein Modell einhalten muss, um auf den von ihm angegriffenen Geräten ausgeführt werden zu können. Qwen3.5-9B und Gemma4-26B-A4B liegen für die getesteten Smart-TVs mit 4 Gigabyte unter dieser Obergrenze. Die beiden Grenzen überschneiden sich derzeit nicht. Trägt man bedeutende Open-Weight-Modelle mit höchstens 30 Milliarden Parametern gegen den Epoch Capabilities Index auf, ergibt die Anpassung des Teams nach der Methode der kleinsten Quadrate einen Zuwachs von 13,7 ECI pro Jahr bei einem R² von 0,95. Demnach könnte ein kleines Modell bis Ende 2026 das Niveau von GLM-5.2 erreichen. Das Team warnt jedoch, dass der ECI ein allgemeiner Fähigkeitsindex und nur ein Näherungswert für die Replikationsfähigkeit ist; die zeitliche Einschätzung sei daher grob. Bei einer Ablationsstudie mit 17 Knoten, in der ein vorgefertigtes Skript die Inferenzeinrichtung übernahm, erreichte selbst ein Modell mit 3 Milliarden Parametern etwa die Hälfte der Knoten. Nach Angaben des Teams zeigt dies, wie viel Schwierigkeit auf die verbleibenden Schritte der Autonomie und Orchestrierung entfällt.
Replikationsgeschwindigkeit, Skalierung und Anpassung
Bei den Messungen des Teams an den physischen TV-Boxen lief die nicht optimierte Inferenz mit Gemma4-26B-A4B über ein Kontextfenster von 32.000 Tokens mit etwa 0,3 Tokens pro Sekunde. Eine vollständige Inferenzkonfiguration einzurichten dauerte 71 bis 150 Stunden, bei Qwen3.5-9B dagegen 28 bis 51 Stunden. Hochgerechnet auf eine Flotte in der Größe von Kimwolf schätzt das Team die Zahl der Replikate auf etwa 133.000, wobei jedes Replikat aus einer Gruppe von 15 Fernsehern besteht. Zusammen würden sie etwa 80.000 Tokens pro Sekunde verarbeiten und höchstens etwa 40 H100-Äquivalente an Inferenzleistung benötigen – eine, wie das Team es nennt, winzige Menge Rechenleistung. Die Replikation würde ein bis zwei Tage pro Kopie mit 9 Milliarden Parametern dauern.
Über sechs Generationen von Qwen3.5-9B-Instanzen hinweg, von denen jede die Notizen ihres Vorgängers übernahm, stieg die Erfolgsquote beim Einrichten der Inferenz laut Team von 45 % in der ersten Generation auf 61 bis 84 % in den späteren Generationen, verteilt auf 20 Abstammungslinien. Der Zugang zu Opus 4.8 als Berater an der Spitze des Leistungsbereichs brachte Qwen3.5-9B keine messbaren Vorteile – unabhängig davon, ob der Berater über einen Tool-Aufruf angeboten oder unaufgefordert bereitgestellt wurde. Auch das bestärkende Lernen, um den Berater bei Programmieraufgaben einzusetzen, ließ sich nicht produktiv übertragen. Bei einer lokalen Reproduktion von Metas Spear-Phishing-Evaluation CyberSecEval 3 erzielten kleine Modelle Werte, die der Beitrag – im Vergleich mit menschlichen Beurteilern – als sehr schlecht bis schlecht einstuft. Das Team wertet dies als Hinweis darauf, dass Social Engineering bei kleinen Modellen hinter agentenbasierten Cyberfähigkeiten zurückbleibt.
Der Beitrag schätzt außerdem, dass es rund 90 verschiedene IoT-Produktlinien mit NVIDIA-Silizium und etwa 9,5 Millionen eingesetzte Geräte gibt. Die Rechenleistung der Edge-Beschleuniger beziffert er sehr grob auf 9.000 bis 35.000 H100-Äquivalente; der erreichbare Anteil dürfte um mindestens eine Größenordnung geringer sein. Ein Jetson AGX Orin mit 64 GB führt Qwen3-30B-A3B mit 76,7 Tokens pro Sekunde aus, ein AGX Thor erreicht 226 Tokens pro Sekunde – so die im Beitrag angeführten Zahlen.
Abwehrmaßnahmen und Einschätzung des Teams
Bei der Abwehr geht es darum, R₀ – die Zahl der neuen Geräte, die jedes infizierte Gerät seinerseits infiziert – unter eins zu drücken, heißt es in dem Beitrag. Ein auf Modellgewichten basierender Replikator, der sich massenhaft über IoT-Geräte verbreitet, würde in der netzwerkbasierten Überwachung des Datenverkehrs durch Internetanbieter (ISP) Spuren hinterlassen: Neu infizierte Geräte erhalten Modellpakete mit mehreren Gigabyte, und die verteilte Inferenz erzeugt anhaltenden Datenverkehr zwischen den Geräten. Eine schnellere Replikation verursacht mehr Datenverkehr und geht zulasten der Tarnung; zudem können Honeypots das Gerüst und die Nutzlast eines Replikators abfangen. Unter Berufung auf Untersuchungen zur Eindämmung von Mirai heißt es in dem Beitrag, dass die Quarantäne durch Internetanbieter mit Benachrichtigung der Kunden innerhalb von 14 Tagen 92 % der Infektionen beseitigte, gegenüber 74 % ohne Benachrichtigung. Als Beispiel dafür, dass Regulierung den Kreis potenzieller Ziele verkleinert, wird angeführt, dass Standardpasswörter für IoT-Geräte auf den britischen Märkten inzwischen nicht mehr den Vorschriften entsprechen.
Anders als fest programmierte Botnetze wie Kimwolf, die bestimmte Gerätetypen angreifen, ist ein KI-Botnetz laut Beitrag nicht an eine bestimmte Hardware gebunden. Als Beispiel nennt er kleine Modelle, die Inferenz auf Geräten vom Jetson Nano bis hin zu einem Mac einrichten. Die Forschenden kommen zu dem Schluss, dass die Ergebnisse – ähnlich wie bei Programmieragenten im Jahr 2024 – erste Anzeichen für KI-Würmer erkennen lassen: Agenten erledigen zunehmend einzelne Schritte der Replikationskette und geben Anpassungen an künftige Kopien weiter, doch ein vollständig autonomer, außer Kontrolle geratener Replikator ist noch nicht entstanden. Die Forschenden erwarten, dass die installierte Edge-Rechenleistung weiter zunimmt, während die Mindestgröße eines Modells, das für eine zuverlässige Replikation erforderlich ist, sinkt.


