
Andersons Blickwinkel
KI-unterstützte Objektbearbeitung mit Googles Imagic und Runways „Erase and Replace“

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen

Diese Woche bieten zwei neue, aber gegensätzliche KI-gesteuerte Grafik‑Algorithmen neuartige Möglichkeiten für Endnutzer, hochgranulare und effektive Änderungen an Objekten in Fotos vorzunehmen.
Der erste ist Imagic, von Google Research, in Zusammenarbeit mit dem Israel Institute of Technology und dem Weizmann Institute of Science. Imagic ermöglicht textgesteuerte, feingranulare Objektbearbeitung durch das Feinabstimmen von Diffusionsmodellen.

Ändern Sie, was Ihnen gefällt, und lassen Sie den Rest – Imagic verspricht granulare Bearbeitung nur der Teile, die Sie ändern möchten. Quelle: https://arxiv.org/pdf/2210.09276.pdf
Jeder, der jemals versucht hat, nur ein Element in einem Stable‑Diffusion‑Neurender zu ändern, weiß nur zu gut, dass bei jeder erfolgreichen Bearbeitung das System fünf Dinge verändert, die einem gerade so gefallen haben. Das ist ein Mangel, der derzeit viele der talentiertesten SD‑Enthusiasten dazu zwingt, ständig zwischen Stable Diffusion und Photoshop hin‑und her zu wechseln, um diese Art von „Kollateralschäden“ zu beheben. Allein aus dieser Sicht erscheinen Imagics Errungenschaften bemerkenswert.
Zum Zeitpunkt des Schreibens fehlt Imagic noch ein Werbevideo, und angesichts von Googles zurückhaltender Haltung gegenüber der Veröffentlichung uneingeschränkter Bildsynthese‑Werkzeuge ist unklar, inwieweit wir – falls überhaupt – die Möglichkeit erhalten, das System zu testen.
Das zweite Angebot ist Runway MLs eher zugängliche Erase and Replace-Funktion, ein neues Feature im Abschnitt „AI Magic Tools“ seiner ausschließlich online verfügbaren Suite von maschinellem Lernen basierenden Visual‑Effects‑Werkzeugen.
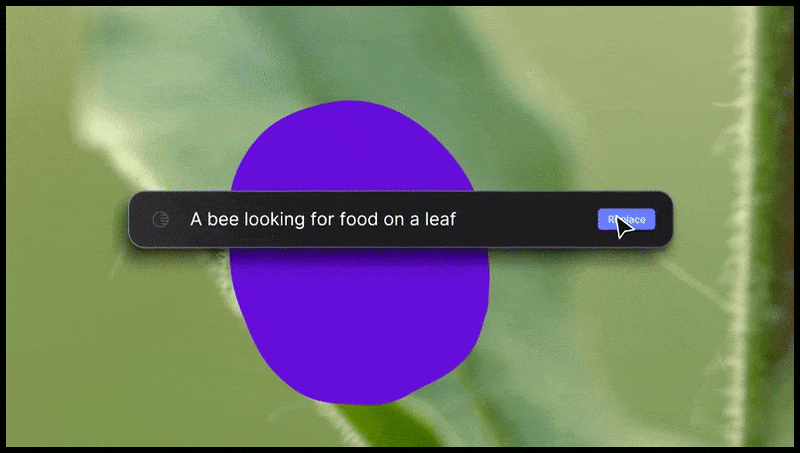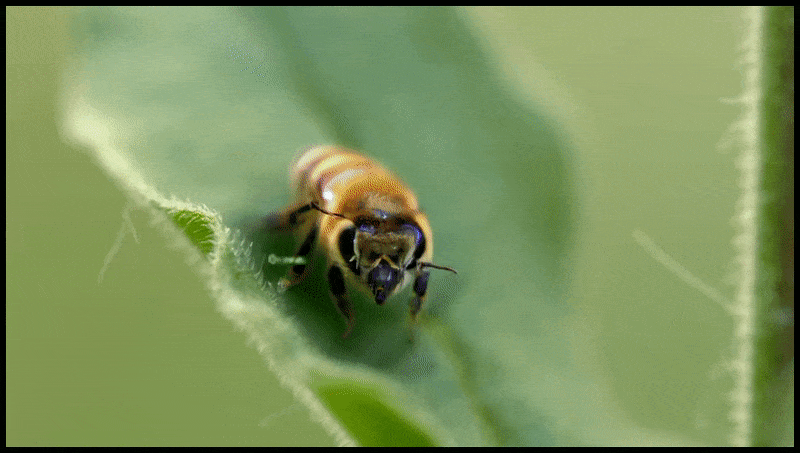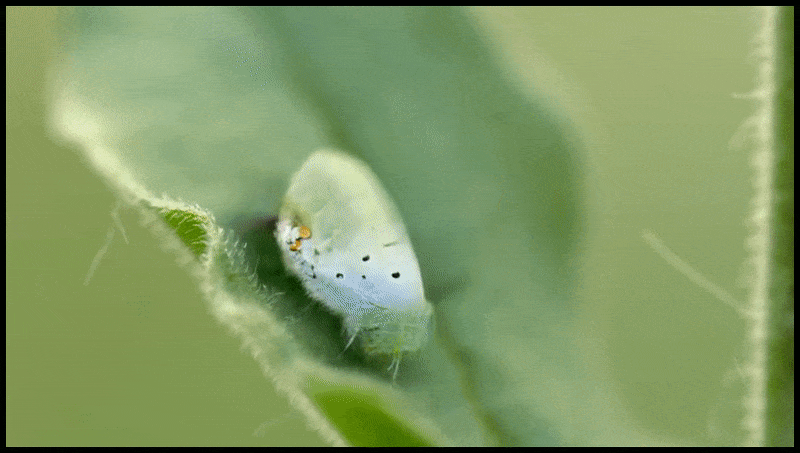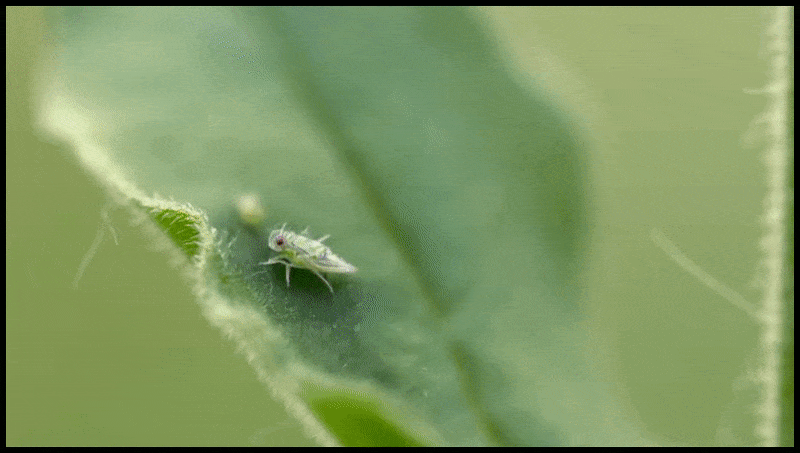
Runway MLs Erase‑and‑Replace‑Funktion, bereits in einer Vorschau für ein Text‑zu‑Video‑Bearbeitungssystem zu sehen.
Schauen wir uns zunächst Runways Angebot an.
Löschen und Ersetzen
Wie Imagic arbeitet Löschen und Ersetzen ausschließlich mit Standbildern, obwohl Runway eine Vorschau derselben Funktionalität in einer noch nicht veröffentlichten Text‑zu‑Video‑Bearbeitungslösung gezeigt hat:
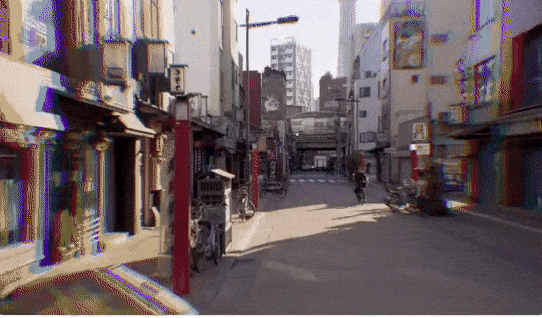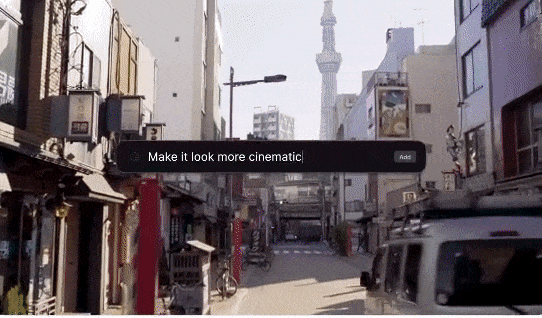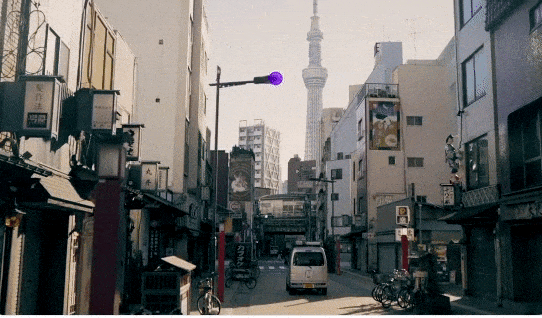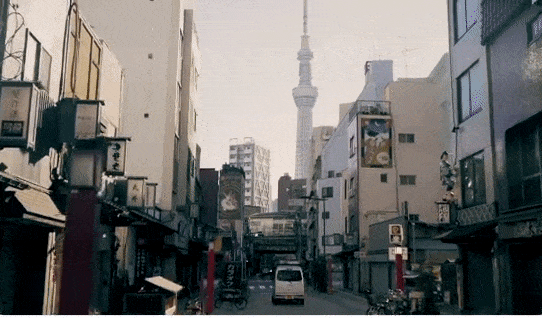
Obwohl jeder die neue Erase‑and‑Replace‑Funktion an Bildern testen kann, ist die Video‑Version noch nicht öffentlich verfügbar. Quelle: https://twitter.com/runwayml/status/1568220303808991232
Obwohl Runway ML keine Details zu den Technologien hinter Löschen und Ersetzen veröffentlicht hat, deutet die Geschwindigkeit, mit der man eine Zimmerpflanze durch eine einigermaßen überzeugende Büste von Ronald Reagan ersetzen kann, darauf hin, dass ein Diffusionsmodell wie Stable Diffusion (oder, viel unwahrscheinlicher, ein lizenziertes DALL‑E 2) die Engine ist, die das gewünschte Objekt in Löschen und Ersetzen neu erschafft.

Eine Zimmerpflanze durch eine Büste von „The Gipper“ zu ersetzen, ist nicht ganz so schnell wie hier, aber dennoch ziemlich zügig. Quelle: https://app.runwayml.com/
Das System hat einige DALL‑E‑2‑artige Einschränkungen – Bilder oder Texte, die die Löschen‑und‑Ersetzen‑Filter auslösen, erzeugen eine Warnung über mögliche Kontosperrungen bei weiteren Verstößen – praktisch ein Boiler‑Plate‑Klon von OpenAIs laufenden Richtlinien für DALL‑E 2.
Viele der Ergebnisse fehlen die typischen rauen Kanten von Stable Diffusion. Runway ML ist Investor und Forschungspartner von SD, und es ist möglich, dass sie ein proprietäres Modell trainiert haben, das den Open‑Source‑Checkpoint‑Gewichten 1.4, mit denen wir anderen derzeit kämpfen, überlegen ist (wie viele andere Entwicklungsgruppen, Hobby‑ und Profis gleichermaßen, derzeit Stable‑Diffusion‑Modelle trainieren oder feinabstimmen).
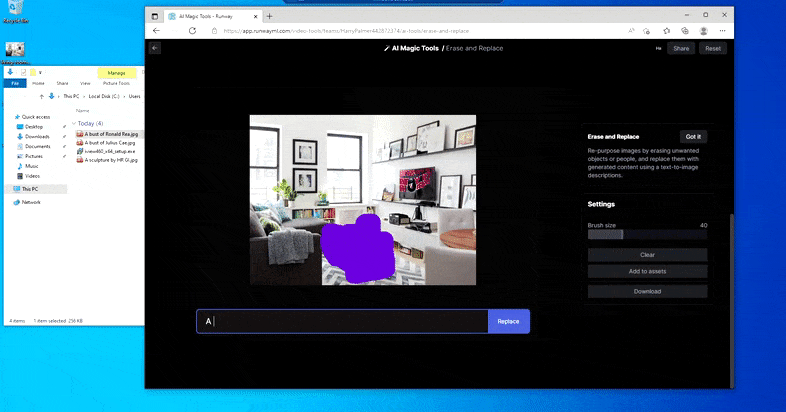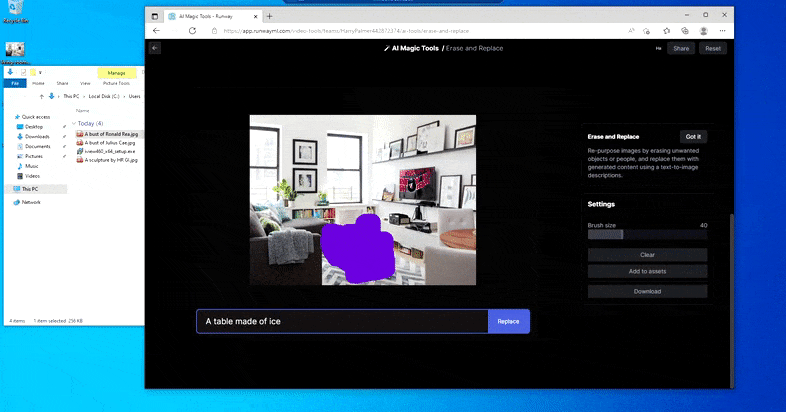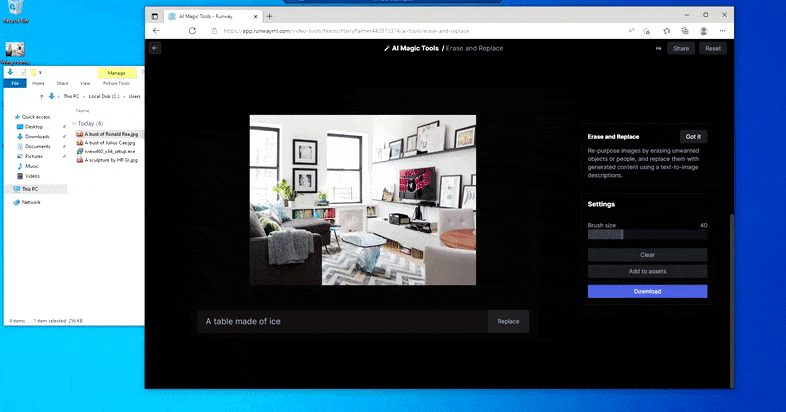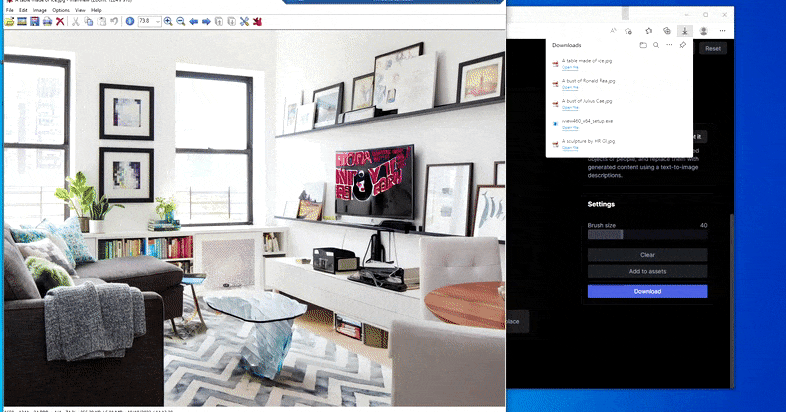
Ein heimischer Tisch wird durch einen „Tisch aus Eis“ in Runway MLs Löschen‑und‑Ersetzen ersetzt.
Wie bei Imagic (siehe unten) ist Löschen und Ersetzen sozusagen ‚objektorientiert‘ – man kann nicht einfach einen ‚leeren‘ Bildbereich löschen und ihn mit dem Ergebnis der Texteingabe ausmalen; in diesem Szenario wird das System einfach das dem Masken‑Sichtfeld nächstliegende offensichtliche Objekt (wie eine Wand oder einen Fernseher) nachzeichnen und die Transformation dort anwenden.
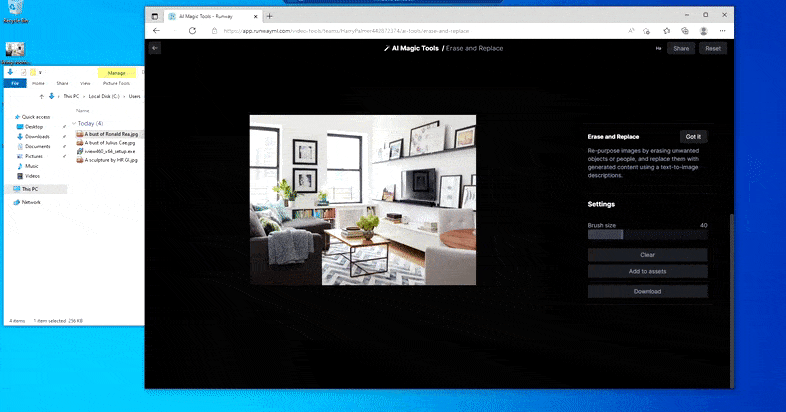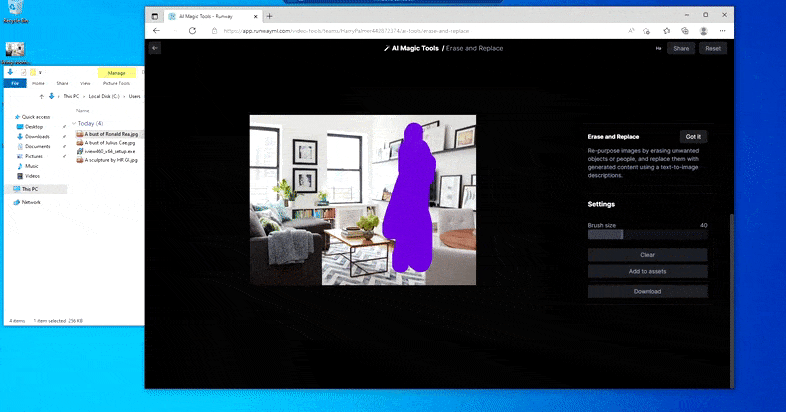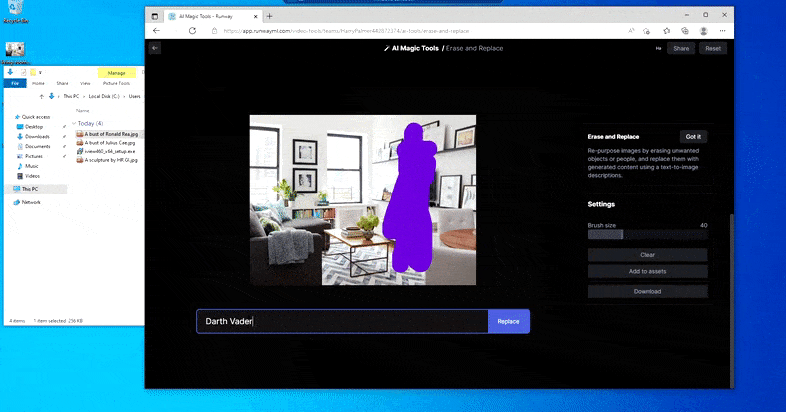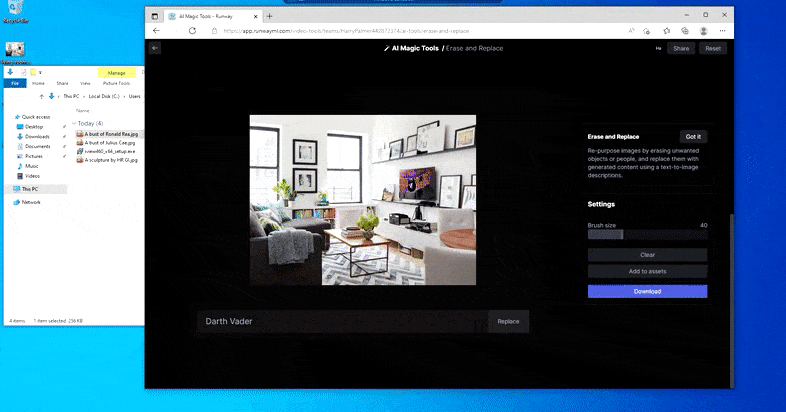
Wie der Name schon sagt, kann man in Löschen und Ersetzen keine Objekte in leeren Raum einfügen. Hier führt der Versuch, den berühmtesten Sith‑Lord zu beschwören, zu einem seltsamen, Vader‑bezogenen Wandbild auf dem Fernseher, ungefähr dort, wo der ‚Ersetzen‘‑Bereich gezeichnet wurde.
Es ist schwer zu erkennen, ob Löschen und Ersetzen im Hinblick auf die Nutzung urheberrechtlich geschützter Bilder (die in DALL‑E 2 nach wie vor weitgehend blockiert sind, wenn auch mit unterschiedlichem Erfolg) ausweichend agiert, oder ob das im Backend‑Render‑Engine verwendete Modell einfach nicht für solche Fälle optimiert ist.

Das leicht NSFW‑„Mural of Nicole Kidman“ zeigt, dass das (vermutlich) diffusionsbasierte Modell die frühere systematische Ablehnung von DALL‑E 2, realistische Gesichter oder anzügliche Inhalte zu rendern, nicht aufweist, während die Ergebnisse von Versuchen, urheberrechtlich geschützte Werke darzustellen, von mehrdeutig („Xenomorph“) bis absurd („Der Eiserne Thron“) reichen. Unten rechts im Bild ist das Ausgangsbild zu sehen.
Es wäre interessant zu erfahren, welche Methoden Löschen und Ersetzen verwendet, um die Objekte zu isolieren, die es ersetzen kann. Vermutlich wird das Bild durch eine Ableitung von CLIP geleitet, wobei die einzelnen Elemente durch Objekterkennung und anschließende semantische Segmentierung identifiziert werden. Keine dieser Operationen funktioniert in einer üblichen Installation von Stable Diffusion annähernd so gut.
Aber nichts ist perfekt – manchmal scheint das System zu löschen und nicht zu ersetzen, selbst wenn (wie wir im obigen Bild gesehen haben) der zugrunde liegende Rendering‑Mechanismus eindeutig versteht, was ein Texteingabe bedeutet. In diesem Fall ist es unmöglich, einen Couchtisch in einen Xenomorph zu verwandeln – vielmehr verschwindet der Tisch einfach.
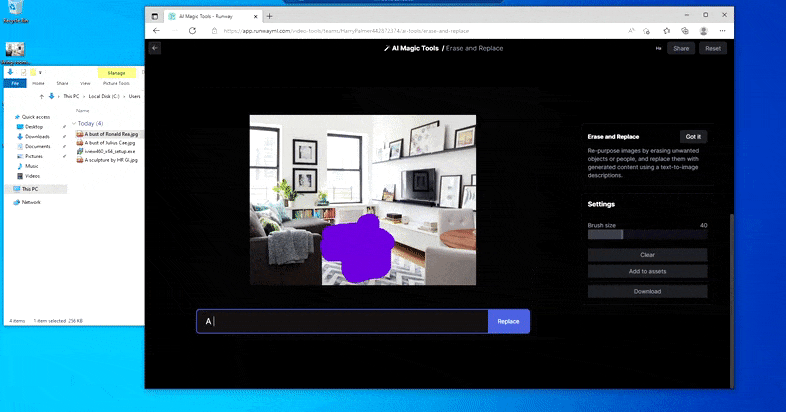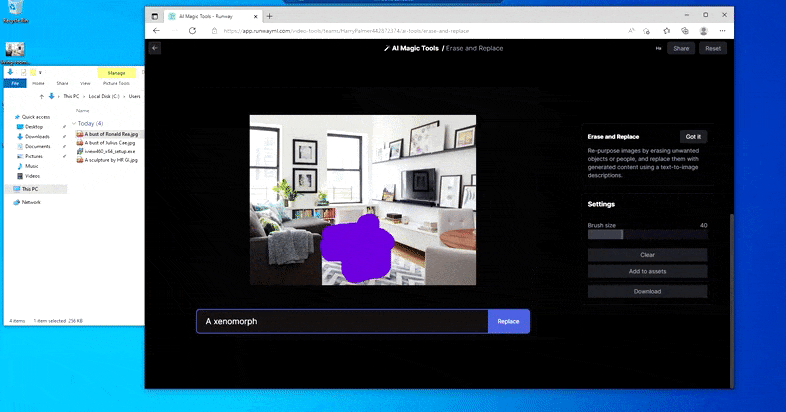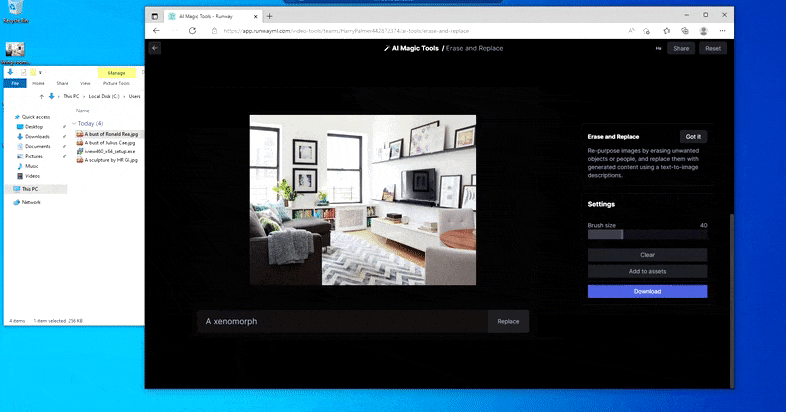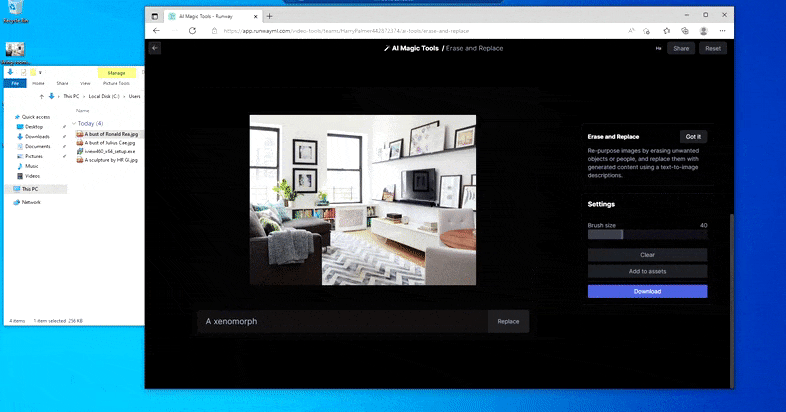
Eine gruseligere Variante von „Wo ist Walter?“, da Löschen und Ersetzen keinen Außerirdischen erzeugt.
Löschen und Ersetzen scheint ein effektives Objekt‑Substitutionssystem mit hervorragender Inpainting‑Funktion zu sein. Allerdings kann es bestehende wahrgenommene Objekte nicht bearbeiten, sondern nur ersetzen. Das tatsächliche Verändern vorhandener Bildinhalte, ohne das Umgebungs‑Material zu beeinträchtigen, ist zweifellos eine weitaus schwierigere Aufgabe, die mit dem langjährigen Kampf des Computer‑Vision‑Forschungsbereichs nach Disentanglement in den verschiedenen latenten Räumen der populären Frameworks verbunden ist.
Imagic
Das ist eine Aufgabe, die Imagic adressiert. Die neue Arbeit bietet zahlreiche Beispiele für Bearbeitungen, die einzelne Facetten eines Fotos erfolgreich verändern, während der Rest des Bildes unverändert bleibt.

In Imagic leiden die bearbeiteten Bilder nicht unter dem typischen Dehnen, der Verzerrung und dem „Verdeckungs‑Raten“, das Deep‑Fake‑Puppetry kennzeichnet und das begrenzte Priors aus einem einzelnen Bild nutzt.
Das System verwendet einen dreistufigen Prozess – Optimierung der Texteinbettung; Feinabstimmung des Modells; und schließlich die Erzeugung des bearbeiteten Bildes.

Imagic kodiert die Ziel‑Texteingabe, um die anfängliche Texteinbettung zu erhalten, und optimiert anschließend das Ergebnis, um das Eingabebild zu erzeugen. Danach wird das generative Modell auf das Quellbild feinabgestimmt, wobei eine Reihe von Parametern hinzugefügt wird, bevor es der gewünschten Interpolation unterzogen wird.
Wie zu erwarten basiert das Framework auf Googles Imagen-Text‑zu‑Video‑Architektur, obwohl die Forscher angeben, dass die Prinzipien des Systems allgemein auf latente Diffusionsmodelle anwendbar sind.
Imagen verwendet eine dreistufige Architektur, im Gegensatz zu dem siebenstufigen Aufbau, der für die neuere Text‑zu‑Video‑Iteration der Software des Unternehmens genutzt wird. Die drei unterschiedlichen Module umfassen ein generatives Diffusionsmodell mit 64 × 64 px Auflösung; ein Super‑Resolution‑Modell, das dieses Ergebnis auf 256 × 256 px hochskaliert; und ein weiteres Super‑Resolution‑Modell, das die Ausgabe bis zu 1024 × 1024 px erweitert.
Imagic greift bereits in der frühesten Phase dieses Prozesses ein und optimiert die gewünschte Texteinbettung in der 64‑px‑Stufe mit einem Adam‑Optimizer bei einer festen Lernrate von 0,0001.

Ein Meisterkurs in Disentanglement: Endnutzer, die versucht haben, etwas so Einfaches wie die Farbe eines gerenderten Objekts in einem Diffusions‑, GAN‑ oder NeRF‑Modell zu ändern, wissen, wie bedeutend es ist, dass Imagic solche Transformationen durchführen kann, ohne die Konsistenz des restlichen Bildes zu „zerreißen“.
Die Feinabstimmung erfolgt dann auf dem Basis‑Modell von Imagen, für 1500 Schritte pro Eingabebild, bedingt durch die überarbeitete Einbettung. Gleichzeitig wird die sekundäre 64px>256px‑Schicht parallel auf dem bedingten Bild optimiert. Die Forscher stellen fest, dass eine ähnliche Optimierung der finalen 256px>1024px‑Schicht kaum bis keinen Einfluss auf die Endergebnisse hat und haben sie daher nicht implementiert.
Das Papier gibt an, dass der Optimierungsprozess etwa acht Minuten pro Bild auf zwei TPUV4-Chips benötigt. Das finale Rendering erfolgt im Kern von Imagen nach dem DDIM‑Sampling‑Schema.
Wie bei ähnlichen Feinabstimmungs‑Prozessen für Googles DreamBooth können die resultierenden Einbettungen zudem zur Stilprägung sowie zu fotorealistischen Bearbeitungen verwendet werden, die Informationen aus der umfassenderen zugrunde liegenden Datenbank von Imagen ziehen (da, wie die erste Spalte unten zeigt, die Quellbilder nicht über den notwendigen Inhalt verfügen, um diese Transformationen zu ermöglichen).

Flexible fotorealistische Bewegungen und Bearbeitungen können über Imagic erzielt werden, während die daraus gewonnenen, disentanglierten Codes ebenso leicht für stilisierte Ausgaben genutzt werden können.
Die Forscher verglichen Imagic mit früheren Arbeiten SDEdit, einem 2021 entwickelten GAN‑basierten Ansatz, einer Zusammenarbeit zwischen der Stanford University und der Carnegie Mellon University; sowie Text2Live, einer Kooperation aus dem April 2022 zwischen dem Weizmann Institute of Science und NVIDIA.

Ein visueller Vergleich zwischen Imagic, SDEdit und Text2Live.
Es ist klar, dass die früheren Ansätze Schwierigkeiten haben, aber in der unteren Zeile, die eine massive Pose‑Änderung beinhaltet, scheitern die Konkurrenten völlig daran, das Ausgangsmaterial neu zu gestalten, während Imagic einen bemerkenswerten Erfolg erzielt.
Imagics Ressourcenbedarf und Trainingszeit pro Bild sind zwar im Vergleich zu solchen Vorhaben kurz, machen es jedoch zu einer unwahrscheinlichen Ergänzung einer lokalen Bildbearbeitungsanwendung auf Personal‑Computern – und es ist unklar, inwieweit der Feinabstimmungs‑Prozess auf Verbraucherniveau heruntergeschraubt werden könnte.
Derzeit ist Imagic ein beeindruckendes Angebot, das eher für APIs geeignet ist – ein Umfeld, in dem Google Research, das Kritik an der Erleichterung von Deepfakes scheu ist, sich möglicherweise am wohlsten fühlt.
Erstveröffentlicht am 18. Oktober 2022.


