
Základy AI
Co je posilovací učení z lidské zpětné vazby (RLHF)?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Posilovací učení z lidské zpětné vazby (RLHF) je soubor metod, které využívají lidské úsudky k optimalizaci modelu, když je požadované chování obtížné specifikovat jednoduchou automatickou odměnou. U jazykových modelů lidé běžně porovnávají kandidátní odpovědi a naučený model preferencí převádí tato srovnání na tréninkový signál.
RLHF může učinit předtrénovaný model užitečnějším nebo lépe odpovídajícím psané politice, ale neprokazuje pravdivost ani soulad se všemi uživateli. Výsledek závisí na tom, kdo poskytuje zpětnou vazbu, jak jsou výzvy vybírány, co dokáže model odměny reprezentovat a jak je optimalizace omezena.
Klíčové body
- RLHF obvykle následuje předtrénování a řízené ladění instrukcí.
- Párové preference trénují model odměny nebo preference; následně optimalizace politiky upřednostňuje výstupy s vyšším skóre.
- Zneužití odměny, nesoulad anotátorů, posun distribuce a přehnaná optimalizace zůstávají důležitými riziky.
- Vyhodnocujte finální politiku přímo z hlediska kvality úkolu, bezpečnosti, kalibrace a efektů na podskupiny.
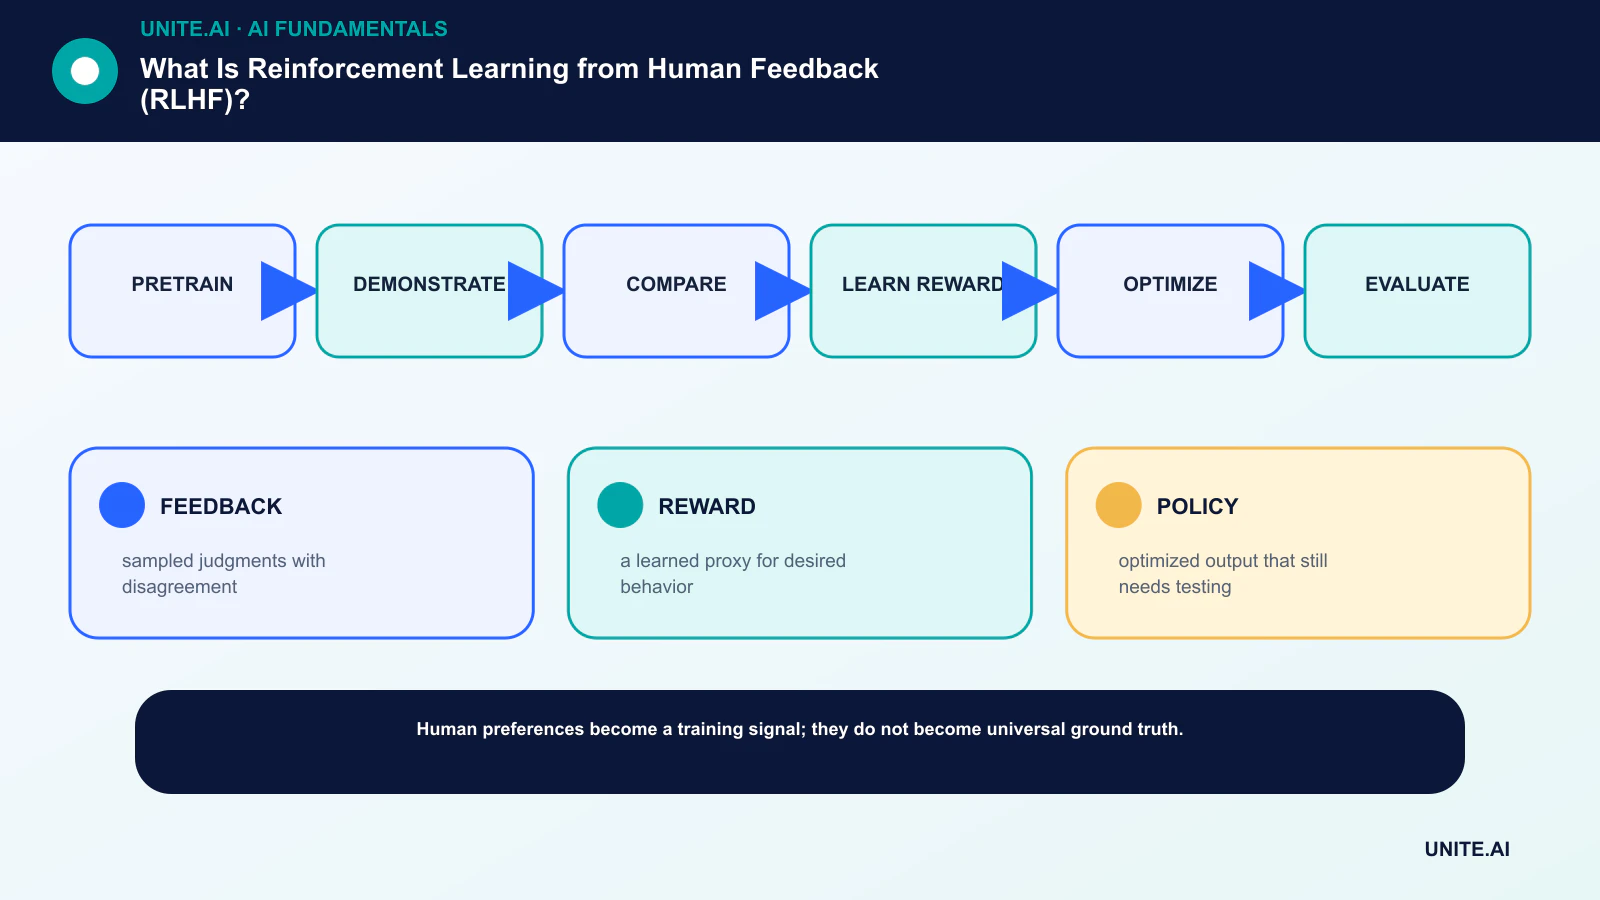
Běžný RLHF postup
Jazykový model nejprve získává širokou statistickou strukturu během předtrénování. Řízené doladění pak využívá demonstrace požadovaných odpovědí. Pro sběr preferencí anotátoři řadí nebo vybírají mezi výstupy ke stejné výzvě.
Model odměny se učí předpovídat tato srovnání. Algoritmus posilovacího učení, například PPO, může optimalizovat jazykový model vůči naučené odměně, zatímco penalizace ho odrazuje od přílišného odklonu od referenční politiky.
Zpětná vazba je měření, nikoli pravda
Anotátoři se mohou neshodovat, protože instrukce jsou nejasné, odborné znalosti se liší nebo hodnoty skutečně kolidují. Pozice, výřečnost, sebejistota a styl mohou preference zkreslovat. Kvalitní program školí hodnotitele, měří shodu, provádí audit příkladů a zachovává nejistotu.
Výběr vzorků také hraje roli. Pokud soubor preferencí vylučuje obtížné jazyky, domény nebo škodlivý obsah, model odměny je nemůže spolehlivě dohlížet. Disciplína datové vědy je stejně důležitá jako optimalizátor.
Módy selhání
Politika může využít slabin naučené odměny a produkovat výstupy, které získávají vysoké skóre, aniž by splňovaly základní záměr. Přehnaná optimalizace může snížit rozmanitost, zesílit preferovaný styl nebo učinit model sebejistě souhlasným.
Samotný model odměny může selhat mimo svůj tréninkový rozptyl. Týmy by měly testovat adversariální výzvy, faktické úkoly, hranice odmítnutí, kalibraci a chování při různých úrovních optimalizace místo spoléhaní se na jedinou souhrnnou míru úspěšnosti preferencí.
Alternativy a doplňky
Přímá optimalizace preferencí se učí z párů preferencí bez vytváření samostatné politiky prostřednictvím online smyčky posilovacího učení. Odmítací výběr, řízené doladění preferencí, zpětná vazba založená na pravidlech a dohled nad procesem nabízejí jiné kompromisy.
Žádná metoda neodstraňuje potřebu výzev, vyhledávání, nástrojů a kontrol na úrovni aplikace. Po‑trénink formuje chování; nasazené systémy stále vyžadují podložené důkazy, oprávnění, monitorování a lidské eskalace.
Jak se trénují modely preferencí
Pro výzvu x a dvě odpovědi y₁ a y₂ model preferencí přiřadí skalární skóre a je trénován tak, aby preferovaná odpověď získala vyšší skóre. Běžná ztrátová funkce vychází z pravděpodobnosti, že jedno skóre překoná druhé. To převádí mnoho párových úsudků na funkci, která může hodnotit nově generované výstupy.
Model se učí jakékoli signály, které předpovídají shromážděné volby. Pokud hodnotitelé upřednostňují sebejistý styl, delší odpovědi, konkrétní kulturní normy nebo známé úhly pohledu, tyto korelace se mohou stát rysy odměny. Vyvážené instrukce, kontrapříklady, odborný přezkum a audity povrchních preferencí problém snižují, ale neodstraňují.
Data o preferencích mohou zahrnovat remízy, žebříčky, kritiky, skalární štítky nebo demonstrace. Výběr párů má význam: srovnání mezi zjevně odlišnými odpověďmi učí méně o jemných hranicích kvality, zatímco jen obtížné páry mohou učinit trénink nestabilním. Aktivní výběr může cílit na informativní nesouhlasy, ale může změnit distribuci dat.
Optimalizace politiky a regularizace
RLHF založené na PPO odebírá odpovědi z aktuální politiky, hodnotí je modelem odměny a aktualizuje politiku tak, aby zvýšila očekávanou odměnu. Penalizace Kullback‑Leiblerova divergence nebo související omezení udržuje politiku blízko řízené reference, omezujíc destruktivní drift a odrazuje od využívání úzkých slabin modelu odměny.
Síla optimalizace je volbou produktu. Příliš málo nechává požadované chování beze změny; příliš mnoho může vést k zneužití odměny, opakujícím se frázím, podlézavosti nebo snížené rozmanitosti. V průběhu tréninku vykreslujte metriky kvality a bezpečnosti vůči odměně a divergenci místo výběru kontrolního bodu jen na základě odměny.
Metody přímých preferencí odvozují cíl z párů preferencí a referenčního modelu bez explicitní online RL smyčky. Mohou trénink zjednodušit, ale stále dědí kvalitu preferencí, pokrytí a předpoklady referenční politiky. Ústavní nebo AI‑generovaná zpětná vazba mění, kdo poskytuje štítky; neodstraňuje potřebu ověřovat hodnoty a selhání s lidmi.
Hodnocení a správa dat
Používejte zaslepená srovnání, testy specifické pro úkol, adversariální výzvy, kontroly fakticity, přesnost a úplnost odmítnutí a revizi podskupin. Kde je to možné, oddělte hodnotitele od tréninkových dat. Míra úspěšnosti proti staršímu modelu může skrývat absolutní selhání, když jsou oba kandidáti slabí.
Zdokumentujte nábor anotátorů, odměňování, odbornost, geografii, jazyk, instrukce, vystavení škodlivému obsahu, nesoulad, rozhodování a kontrolu kvality. Práce se zpětnou vazbou může nést psychologické riziko a odpovědné operace s daty zahrnují podporu pracovníků a právo odmítnout znepokojující úkoly.
Po nasazení sledujte posun preferencí a přehnanou generalizaci. Politika laděná pro neformální asistenci může selhat v medicínských nebo právních kontextech. Udržujte hranice domén, vyhledávání, oprávnění a eskalaci mimo předpoklad RLHF a přeškolujte pouze tehdy, když nové důkazy změnu ospravedlňují.
Konkrétní trénink a evaluační pipeline RLHF
Typický projekt začíná předtrénovaným jazykovým modelem a datasetem instrukcí použitým pro řízené doladění. Anotátoři pak porovnávají kandidátní odpovědi podle psané rubriky zahrnující správnost, relevanci, styl, bezpečnost a nejistotu. Párové preference trénují model odměny nebo přímo optimalizují politiku. Výběr vzorků musí zahrnovat běžné úkoly, obtížné okrajové případy, adversariální výzvy, více jazyků a oblasti, kde anotátoři legitimně nesouhlasí.
Přesnost modelu odměny na vyčleněných srovnáních je nutná, ale ne postačující. Optimalizovaná politika může využívat chyby v naučené odměně, stát se příliš výřečnou, odmítat neškodné požadavky nebo ztrácet schopnosti. Sledujte benchmarky úkolů, lidské preference, kalibraci, bezpečnost, rozmanitost a odchylku od referenčního modelu během tréninku. Pravidelně shromažďujte čerstvá srovnání od měnící se politiky, aby data o preferencích pokrývala výstupy, které model skutečně produkuje.
Zdokumentujte, kdo poskytl preference, jejich instrukce, odměňování, nesoulad, kontrolu kvality a kulturní nebo doménová omezení. Využívejte odborné recenzenty tam, kde chyby mohou způsobit specifické škody. Proveďte red‑teamování jak modelu odměny, tak finální politiky, udržujte testy regresí chování a postupně nasazujte. RLHF formuje chování podle měřených preferencí; neprokazuje pravdivost, neodstraňuje zaujatost ani neřeší širší problém specifikace toho, co by měl model dělat v každém kontextu.
Praktický kontrolní seznam implementace
Přetvořte koncept na omezený, testovatelný pracovní postup: předtrénování → demonstrace → srovnání → učení odměny → optimalizace → hodnocení. Určete odpovědnou osobu, zdokumentujte data a závislosti, stanovte jednoduchý referenční bod, definujte kritéria přijetí a ukončení, otestujte reprezentativní selhání a stanovte monitorování, rollback a revizi před rozšířením rozsahu. Zaznamenejte verze a předpoklady, aby jiný tým mohl výsledek reprodukovat a pochopit, co se změnilo.
Před spuštěním proveďte zdokumentovanou revizi připravenosti s lidmi, kteří systém staví, provozují, zabezpečují a jsou jím ovlivněni. Otestujte normální případy, hraniční podmínky, selhání závislostí a zneužití; zachovejte důkazy a nevyřešená rizika. Definujte, kdo může schválit vydání, změnit práh, přebít výstup nebo zastavit provoz. Přehodnoťte rozhodnutí po příchodu reálných dat, protože technicky úspěšný pilot nezaručuje spolehlivý výkon v širším měřítku.
- ZPĚTNÁ VAZBA: vzorkované úsudky s nesouladem.
- ODMĚNA: naučený zástupce požadovaného chování.
- POLITIKA: optimalizovaný výstup, který stále vyžaduje testování.
Často kladené otázky
Je RLHF totéž jako fine‑tuning?
RLHF je forma post‑tréninku, která používá odměny odvozené z preferencí. Řízené fine‑tuning přímo trénuje na cílových výstupech; mnoho pipeline používá obojí.
Způsobuje RLHF, že je model pravdivý?
Může zlepšit chování měřené procesem zpětné vazby, ale model může být stále nesprávný, přesvědčivý nebo strategicky využívat odměnu. Pravdivost vyžaduje přímé hodnocení a zakotvení.
Primární reference












