
Základy AI
Co je federované učení?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Federované učení trénuje sdílený model napříč více zařízeními nebo organizacemi, přičemž surová tréninková data každého účastníka zůstávají lokální. Koordinátor rozesílá parametry modelu, klienti vypočítávají aktualizace na svých vlastních záznamech a agregační krok tyto aktualizace spojuje.
Uchovávání záznamů lokálně je užitečné, ale není to synonymum pro soukromí nebo bezpečnost. Aktualizace modelu mohou uniknout informace, kompromitovaní klienti mohou otrávit trénink a koordinátor stále potřebuje autentizaci, zabezpečení přenosu, řízení přístupu a definovaný model důvěry.
Klíčové poznatky
- Federované učení přesouvá výpočet k distribuovaným datům; nepřesouvá surový datový soubor k jednomu centrálnímu trénovacímu uzlu.
- Systémy cross-device zahrnují mnoho přerušovaně dostupných zařízení, zatímco systémy cross-silo zahrnují méně, stabilnější organizací.
- Zabezpečená agregace a diferenciální soukromí řeší různé rizika a mohou být kombinovány.
- Data, která nejsou IID, omezená šířka pásma, nespolehlivá účast a škodlivé aktualizace jsou základními návrhovými omezeními.
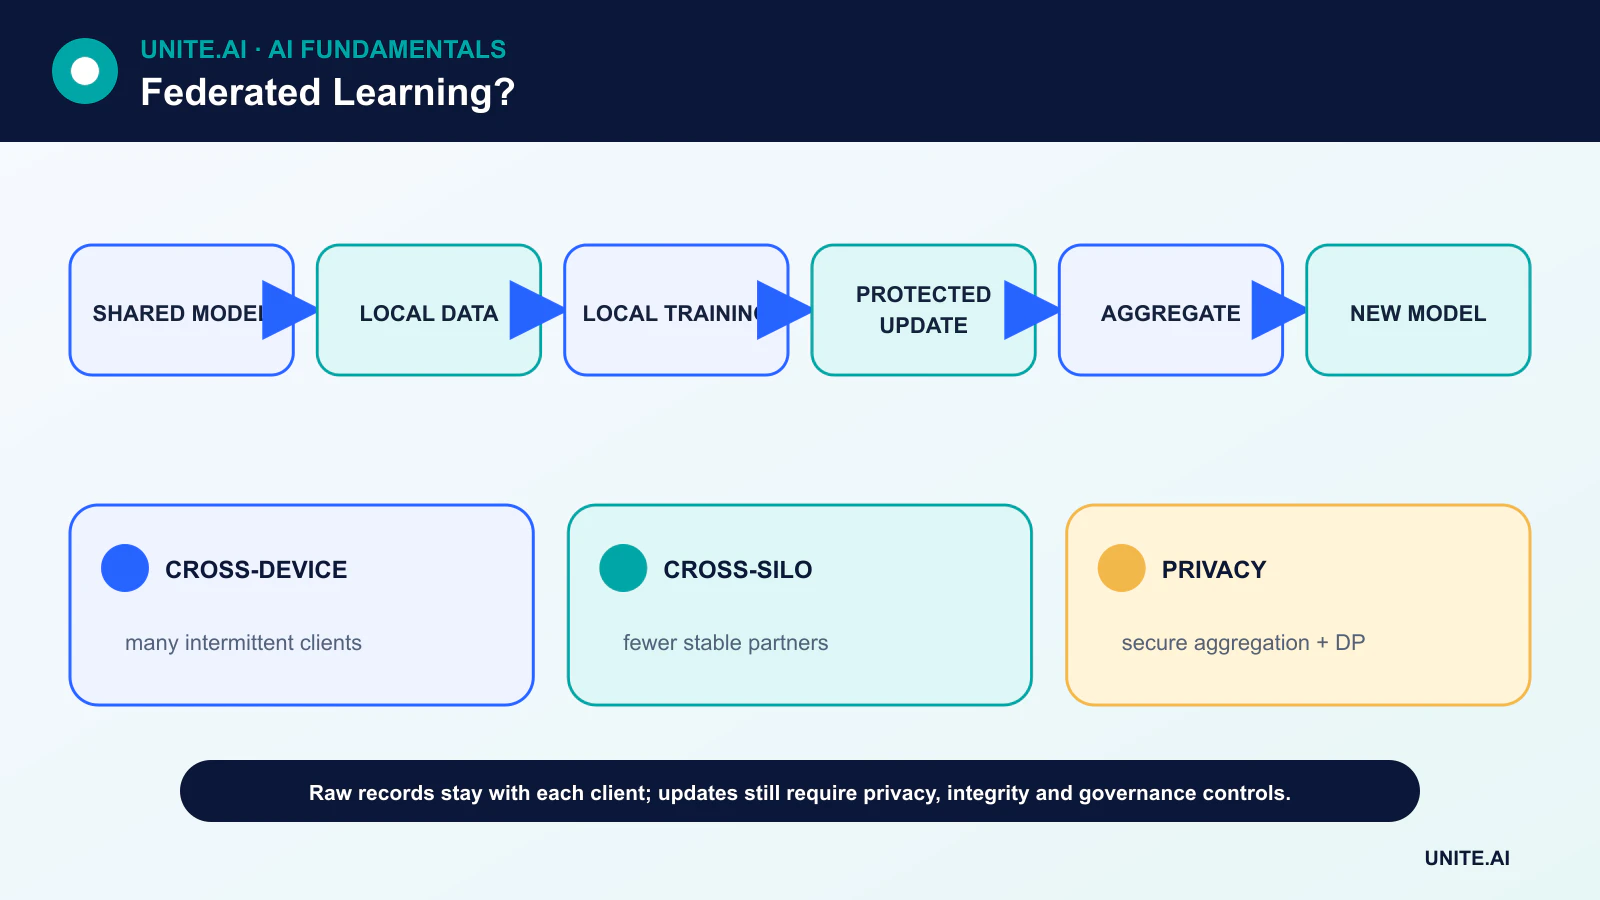
Životní cyklus federovaného průměrování
Typické kolo začíná, když koordinátor vybere oprávněné klienty a pošle jim aktuální model. Každý klient trénuje lokálně po omezený počet kroků a vytvoří parametrickou nebo gradientovou aktualizaci. Koordinátor agreguje oprávněné aktualizace – často s váhami založenými na počtu lokálních příkladů – a zveřejní nový sdílený model.
V každém kole může participovat jen část klientů. Protokol musí tolerovat přerušená spojení, nesoulad verzí a zařízení, která nemohou trénovat během nabíjení, jsou zaneprázdněná nebo offline. Komunikace může dominovat výpočtu, takže komprese aktualizací a méně kol často mají větší význam než samotná rychlost akcelerátoru.
Cross-device versus cross-silo
Federované učení cross-device může zahrnovat telefony, senzory nebo prohlížeče vlastněné mnoha jednotlivci. Klienti jsou početní, slabě důvěryhodní a přístupní jen příležitostně. Federované učení cross-silo obvykle spojuje menší soubor nemocnic, bank nebo obchodních jednotek se stabilní infrastrukturou a smluvní správou.
Obě nastavení vyžadují odlišné předpoklady o identitě, auditu a selhání. Projekt cross-silo může vyjednat společné schéma a validační proces; služba cross-device může muset zvládat miliony verzí softwaru a výrazně nerovnoměrné lokální datové sady.
Secure aggregation, differential privacy and encryption
Zabezpečená agregace je kryptografický protokol, který umožňuje serveru získat agregát, aniž by četl jednotlivé aktualizace klientů. Diferenciální soukromí omezuje, jak moc může výsledek záviset na jakémkoli jednotlivém záznamu nebo účastníkovi, tím že ořezává příspěvky a přidává kalibrovaný šum.
Žádný z těchto mechanismů neodstraňuje všechna rizika. Zabezpečená agregace nečiní agregát neškodným a diferenciální soukromí zavádí kompromis mezi přesností a soukromím, který je třeba vyjádřit explicitním rozpočtem soukromí. Šifrování chrání data během přenosu nebo úložiště; samo o sobě nebrání inferenci z modelu.
Non-IID data and model quality
Data klientů zřídka jsou nezávislá a identicky rozdělená. Model klávesnice vidí slovník každého uživatele; nemocnice obsluhují různé populace; továrny používají různá zařízení. Tyto rozdíly mohou zpomalit konvergenci a skrýt špatný výkon u malých skupin klientů.
Hodnocení by mělo zahrnovat globální metriky, distribuce podle klienta nebo kohorty, kalibraci a analýzu selhání. Centrální testovací sada může být pohodlná, ale nedostatečná. To spojuje federované učení s strojovým učením a správou strukturovaných a nestrukturovaných dat.
Threats and operational controls
Škodliví klienti mohou odesílat otrávené aktualizace, sybilové klienti mohou zkreslovat agregaci a kompromitovaný server může distribuovat cílený model. Obranná opatření zahrnují autentizovanou registraci, detekci anomálií, robustní agregaci, validaci aktualizací, omezení rychlosti a reprodukovatelné softwarové attestační mechanismy, kde je to praktické.
Federované učení patří do širšího programu kybernetické bezpečnosti. Týmy by měly dokumentovat, kdo řídí koordinátor, jaká metadata se sbírají, jak mohou účastníci odejít, jak se modely vracejí a co se stane, když selžou testy soukromí nebo kvality.
Federated optimization and data heterogeneity
Federované učení posílá model nebo úkol aktualizace k účastníkům, trénuje lokálně a agreguje aktualizace bez centralizace surových příkladů. V federovaném průměrování vybraní klienti provádějí několik lokálních optimalizačních kroků a server počítá vážený průměr, obvykle podle počtu příkladů. Počet komunikačních kol, lokální epochy, výběr a učící rychlosti vyvažují šířku pásma proti konvergenci. Nastavení cross-device zahrnují mnoho nespolehlivých telefonů nebo senzorů; nastavení cross-silo zahrnují méně organizací se silnějším výpočetním výkonem, identitou a správou.
Data klientů jsou obvykle ne‑independentní a nerovnoměrná: uživatelé se liší v chování, distribuci štítků, objemu i dostupnosti. Lokální trénink může odklonit model v nekompatibilní směry, což způsobí, že jednoduchý průměr je nestabilní nebo zkreslený ve prospěch aktivních, objemných klientů. Algoritmy mohou využívat proximálních členů, adaptivní optimalizaci serveru, shlukování, personalizaci nebo kontrolní variace. Hodnocení by mělo uvádět globální i klientské výkony, „tail“ klienty, frekvenci účasti, konvergenci, komunikaci a energetickou náročnost. Dobře průměrovaný model může skrývat, že malé nebo vzácné populace klientů dostávají horší model.
Privacy, security, and systems engineering
Uchovávání dat lokálně samo o sobě nezaručuje soukromí. Gradienty a aktualizace mohou uniknout informace o členech nebo vlastnostech, zatímco finální model může zapamatovat konkrétní příklady. Zabezpečená agregace skrývá individuální aktualizace před serverem a diferenciální soukromí omezuje příspěvek informací ořezáváním a šumem, ale oba faktory snižují užitečnost a zvyšují operační složitost. Definujte model hrozeb, jednotku soukromí, rozpočet a důvěryhodné komponenty. Šifrování během přenosu je nezbytné, ale nebrání škodlivému klientovi, otrávené aktualizaci, kompromitovanému koordinátorovi nebo inferenčnímu útoku.
Obranná opatření zahrnují autentizované klienty, robustní agregaci, kontroly anomálií, limity aktualizací, zabezpečené enclavy v některých návrzích a validaci proti čistým datům. Sybil útočníci mohou vytvořit mnoho klientů; zadní vrátka mohou přežít průměrování; odstraňování podezřelých aktualizací může také vyloučit legitimní vzácné chování. Verzujte klientský kód, podporujte přerušená kola, zabraňte opakování a navrhujte pro zpožďující se zařízení a omezení zařízení. Souhlas, uchovávání, regionální pravidla a mazání stále platí pro lokální data i odvozené aktualizace.
Deployment and governance example
Mobilní klávesnice může trénovat zlepšení předpovědi dalšího slova lokálně, ale nasazení by mělo využívat populaci oprávněnou podle schopností zařízení a souhlasu, sbírat ořezané chráněné aktualizace a porovnávat s pevně daným základem. Ověřte výkon jazyka a dialektu, spotřebu baterie, využití dat a riziko memorování před vydáním. Klienti potřebují podepsané tréninkové úkoly a modelové aktualizace; server potřebuje auditovatelnou konfiguraci kol a možnost rollbacku. Federované učení je architekturou pro distribuované učení pod omezeními, ne náhradou za reprezentativní data, inženýrství soukromí nebo odpovědnost.
Worked example: federated learning across hospitals
Nemocnice trénují sdílený model kvality obrazu bez shromažďování skenů. Společný protokol definuje metadata zařízení, štítky, předzpracování, oprávněnost klienta, lokální epochy, ořezávání a zabezpečenou agregaci. Zákazy si uchovávají data pacientů a odesílají chráněné aktualizace, zatímco koordinátor hodnotí každé kolo na lokálních vyhrazených sadách. Výsledky uvádějí výkonnost na úrovni zařízení i „tail“ výkon, ne jen vážený průměr, protože malé nemocnice a typy zařízení by jinak mohly být přehlédnuty.
Model hrozeb zahrnuje škodlivé aktualizace, únik členství, kompromitované klienty a přístup koordinátora. Diferenciální soukromí je nastaveno s dokumentovaným rozpočtem a testovanou užitečností. Modelové a úkolové balíčky jsou podepsané; zařízení mohou odstoupit a aktualizace jsou auditovatelné. Otrávené nebo nestabilní kolo automaticky nenahrazuje nasazený model. Projekt si zachovává lokální základy a klinické recenze a považuje federovanou architekturu za jeden z kontrolních prvků soukromí v rámci širších povinností souhlasu, bezpečnosti a správy.
Implementation evidence and operational readiness
Rozhodnutí o nasazení vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledky každého důležitého selhání. Zaveďte reprodukovatelný základ a verzovanou evaluační sadu před laděním. Testujte běžné případy, hraniční podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadek závislostí, zneužití a skupiny nebo prostředí, která jsou pravděpodobně nedostatečně obsloužena. Měřte kvalitu úkolu spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a rozlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte pravomoc pro vydání, výjimky, změny, rollback a ukončení. Použijte stupňované nasazení, zachovejte bezpečnou zálohu a ověřte monitorování pomocí úmyslně vložených selhání. Provozní telemetrie by měla odhalovat kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky bez sběru zbytečných citlivých dat. Definujte prahové hodnoty výstrah a odpovědného vlastníka, poté po nasazení revidujte reálné důkazy místo předpokladu, že offline výkon přetrvá. Přehodnocujte vždy, když se změní zdroje dat, uživatelé, modely, dodavatelé, politiky, hardware nebo cíle. Udržovaný systém také potřebuje dokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný bod, kdy má být vypnut nebo nahrazen.
Frequently asked questions
Does federated learning guarantee that private data cannot leak?
Ne. Snižuje pohyb surových dat, ale aktualizace a finální modely mohou stále odhalovat informace. Soukromí vyžaduje model hrozeb a další technické i organizační kontroly.
When is centralized training simpler?
Když lze data legálně a bezpečně centralizovat, je centralizovaný trénink často snazší ladit, reprodukovat a monitorovat. Federované učení je oprávněné, když je distribuce skutečnou požadavkem, nikoli jen marketingovým cílem.
Primary references












