
Základy AI
Co je hluboké posilovací učení?

 Přidejte Unite.AI mezi své preferované zdroje na Google
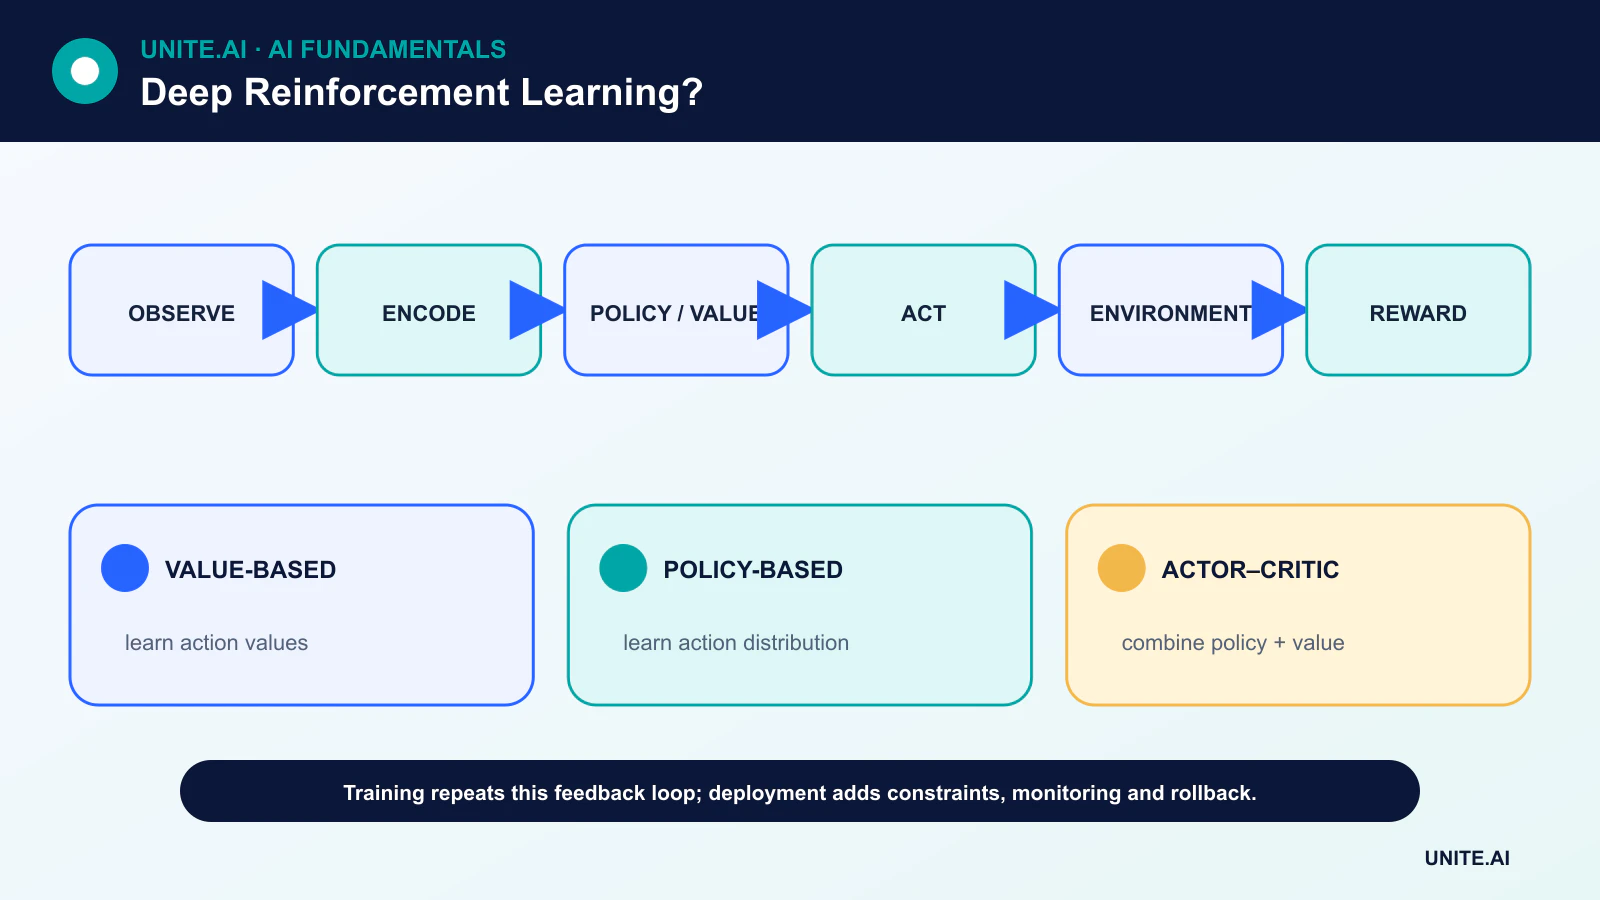
Hluboké posilovací učení (deep RL) kombinuje posilovací učení s hlubokými neuronovými sítěmi. Agent pozoruje stav, volí akci, získá odměnu a novou observaci, poté upravuje politiku nebo hodnotovou funkci, aby zlepšil budoucí rozhodnutí.
Hloubková síť neodstraňuje obtížné části posilovacího učení. Poskytuje flexibilní způsob, jak reprezentovat obrazy, senzorové proudy, velké akční prostory nebo složité hodnotové funkce. Průzkum, zpožděné přiřazení odměny, nestabilní trénink a bezpečné hodnocení ve skutečném světě zůstávají hlavními inženýrskými problémy.
Klíčové poznatky
- Hluboké posilovací učení se učí sekvenční rozhodování z interakce, místo pevné tabulky označených příkladů.
- Metody založené na hodnotě odhadují, jak dobré jsou akce; metody politiky se učí přímo rozdělení akcí; metody herec‑kritik kombinuje obojí.
- Replay buffery, cílové sítě a pečlivý návrh odměny mohou zlepšit trénink, ale žádná z nich nezaručuje spolehlivé chování.
- Silný výsledek v simulátoru není důkazem robustnosti, bezpečnosti ani úspěšného přenosu do reálného světa.
Rozhodovací problém: stavy, akce a odměny
Mnoho úloh hlubokého posilovacího učení je modelováno jako Markovův rozhodovací proces. V čase t agent získá stav nebo observaci st, vybere akci at, poté obdrží odměnu rt+1 a následující stav. Cílem je očekávaný diskontovaný výnos, nikoli nutně jen následující odměna.
Diskontní faktor řídí, jak silně jsou brány v úvahu vzdálené odměny. Funkce odměny určuje, co bude optimalizační proces sledovat, takže neúplná náhrada může vést k chování, které je technicky úspěšné, ale operačně nežádoucí. To je jeden z důvodů, proč návrh odměny a testování omezení vyžadují stejnou pozornost jako architektura modelu.
Metody založené na hodnotě, na politice a actor–critic
Algoritmus založený na hodnotě odhaduje hodnotu stavu nebo akce. Deep Q‑sítě používají neuronovou síť k aproximaci Q‑hodnot a typicky volí akci s nejvyšším odhadem při zachování určitého průzkumu. Algoritmus policy‑gradient místo toho optimalizuje parametrizovanou politiku, která generuje rozdělení akcí.
Actor–critic systémy udržují jak aktéra, který navrhuje akce, tak kritika, který odhaduje jejich hodnotu. Tento návrh podporuje kontinuální řízení, ale zavádí vzájemně působící zdroje chyb odhadu. Hluboké posilovací učení tak závisí na stejných základech jako deep learning, gradient descent a backpropagation.
Proč pomáhají replay buffery a cílové sítě
Následující vzorky zkušeností jsou korelované, zatímco aktualizace sítě mění cíle používané při pozdějších aktualizacích. Experience replay rozbíjí část této časové korelace výběrem starších přechodů. Cílová síť se mění pomaleji než online síť, což činí bootstrapované cíle méně volatilními.
Tyto mechanismy zlepšují stabilitu tréninku, ale ladění stále hraje roli. Rychlost učení, plán průzkumu, měřítko odměny, složení replay bufferu a kapacita sítě mohou výsledek ovlivnit. Měly by být uvedeny výsledky z více náhodných semínek, protože jeden běh může být zavádějící.
Offline RL, model‑based RL a sim‑to‑real
Offline RL se učí z pevně zaznamenané datové sady bez sběru nových interakcí. Může být užitečné, když je průzkum nákladný nebo nebezpečný, ale politika musí vyhýbat akcím, které jsou v logu špatně zastoupeny. Model‑based RL se učí nebo používá přechodový model k plánování, čímž vyměňuje další předpoklady za efektivitu vzorkování.
Robotika často trénuje v simulaci, randomizuje fyzické parametry a poté doladí nebo ověří na hardware. Realitní mezera může stále odhalovat chyby v percepci, časování, dynamice kontaktu a ne‑modelovaných okrajových případech. Systém posilovacího učení by měl být hodnocen pod perturbacemi, posunem distribuce a explicitními bezpečnostními omezeními.
Hodnocení a nasazení
Užitečné hodnocení odděluje tréninkové a testovací prostředí, uvádí rozdělení výnosů místo jen nejlepšího skóre a kontroluje porušení omezení, četnost zásahů a chování v nejhorším případě. Pro reálné systémy týmy také potřebují monitorování, postupy návratu k předchozí verzi, omezené akční prostory a lidský zásah.
Hluboké posilovací učení je nejpřitažlivější, když jsou rozhodnutí sekvenční, zpětná vazba je dostupná a ručně psaná řídicí pravidla jsou nedostatečná. Je nevhodné jako výchozí volba, když jsou k dispozici bohaté supervizované štítky, konvenční optimalizátor problém vyřeší, nebo by průzkum ohrožoval lidi či majetek.
Architektury Deep RL a tréninkové signály
Hluboké posilovací učení používá neuronové sítě k reprezentaci hodnotové funkce, politiky, modelu prostředí nebo jejich kombinace. Deep Q‑síť předpovídá hodnoty akcí a učí se z cílů časové diference; experience replay snižuje korelaci mezi aktualizacemi, zatímco cílová síť stabilizuje pohyblivý cíl. Metody policy‑gradient optimalizují očekávaný výnos přímo a actor‑critic metody používají naučeného kritika ke snížení variance gradientu. Kontinuální akce často vyžadují deterministické nebo stochastické varianty actor‑critic, zatímco diskrétní vysokodimenzionální akce potřebují pečlivý průzkum a návrh výstupu.
Trénink je nestacionární, protože politika mění data, která sbírá. Replay data se stávají off‑policy, bootstrapované cíle závisí na aktuálních odhadech a aproximace funkcí může chyby zesílit — kombinace, která se někdy nazývá smrtelná trojice. Dvojité odhadovače snižují nadhodnocení hodnoty; funkce výhody zlepšují přiřazení kreditu; bonusy entropie podporují průzkum; oříznuté cíle omezují destruktivní aktualizace politiky. Normalizujte observace a odměny pouze s únikem‑bezpečným stavem a zaznamenávejte prostředí, wrapper, opakování akce, ukončení a předzpracování odměn, protože každé z nich mění problém.
Hodnocení, simulátory a bezpečnost nasazení
Uveďte rozdělení výnosů napříč nezávislými semeny a instancemi prostředí, ne jen nejlepší běh. Hodnoťte efektivitu vzorkování, porušení omezení, katastrofické výsledky, citlivost na měřítko odměny a robustnost vůči šumu observací, zpoždění, chybám akčního členku a změněné dynamice. Porovnávejte se skriptovaným řízením, klasickým řízením, supervizovanou imitací a jednodušším RL. Vyčleňte variace prostředí a testujte metriky výstupů bez odměny, protože agent může využít naprogramovanou odměnu a přitom selhat v zamýšleném úkolu. Video a inspekce trajektorií často odhalí chování skryté v souhrnném výnosu.
Simulace umožňuje průzkum, ale zavádí realitní mezeru. Randomizujte relevantní fyziku a percepci, kalibrujte vůči reálným měřením a používejte konzervativní převod. Zaznamenaná data nebo offline RL se vyhýbají online průzkumu, ale nemohou spolehlivě hodnotit akce, které nejsou podporovány chováním politiky. Produkční systémy by měly omezit množinu akcí, rychlost, zdroje a provozní obal; vyžadovat schválení pro akce s vysokým dopadem; a zahrnout ověřený bezpečný řadič nebo zastavení. Monitorujte vstupy politiky, rozdělení akcí, odměnu, reálné výsledky a zásahy s možností návratu k testované verzi politiky.
Konkrétní příklad řízení
Pro plánování trasy skladových robotů definujte stav z polohy, zatížení, baterie, okolního provozu a fronty úkolů; akce z povolených pohybů a rozhodnutí o nabíjení; a odměnu z dokončené práce, energie, přetížení a bezpečnostních omezení. Nejprve trénujte v kalibrovaném simulátoru s randomizovanou poptávkou a poruchami senzorů, poté stínujte reálná rozhodnutí. Nikdy nenechte naučenou politiku obejít vyhýbání se kolizím. Hodnoťte propustnost spolu s těsnými průniky, zablokováními, nouzovými situacemi baterie a nejhorším možným zpožděním. Projekt uspěje jen tehdy, když vrstvený systém zlepší provoz bez přenosu nepřijatelného rizika průzkumu na lidi nebo zařízení.
Praktický příklad: DRL pro chlazení datových center
Datové centrum omezuje RL agenta na schválené chladicí setpointy a trénuje ho v simulátoru kalibrovaném na základě historických údajů o počasí, zatížení, teplotách a odezvě zařízení. Odměna zahrnuje energii, ale tvrdá omezení samostatně chrání teplotu, vlhkost a cyklování zařízení. Model‑predictive control a existující pravidla slouží jako základní linie. Hodnocení zahrnuje sezóny, šum senzorů, zpoždění akčního členku, selhání zařízení, neobvyklé zatížení a více semínek, přičemž se uvádějí energie, porušení, rozptyl a zotavení.
Naučená politika běží ve stínovém režimu před omezeným zónovým testem. Externí bezpečnostní řadič ořezává akce a operátoři mohou zasáhnout. Monitoruje se rychlost akcí, pokrytí stavů, nejistota modelu a skutečné výsledky zařízení; nesoulad simulátoru nebo opakovaný zásah spouští návrat. Aktualizované zařízení nebo řídicí logika vytvářejí novou verzi prostředí a validaci. Úspory energie jsou přijímány jen tehdy, když spolehlivost, termální rezerva, údržba a reakce na poruchy zůstávají alespoň tak silné jako základní linie.
Důkazy o implementaci a operační připravenost
Rozhodnutí o nasazení vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledky každého důležitého selhání. Zaveďte reprodukovatelnou základní linii a verzi hodnotící sady před laděním. Testujte běžné případy, okrajové podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadek závislostí, nesprávné použití a skupiny nebo prostředí, která jsou pravděpodobně nedostatečně obsloužena. Měřte kvalitu úkolu spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a rozlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte pravomoc pro vydání, výjimky, změny, návrat a ukončení. Použijte postupné nasazení, zachovejte bezpečný fallback a ověřte monitorování pomocí úmyslně zavedených selhání. Operační telemetrie by měla odhalovat kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky, aniž by sbírala zbytečná citlivá data. Definujte prahové hodnoty upozornění a odpovědnost za reakci, poté po nasazení přezkoumejte reálné důkazy místo předpokladu, že offline výkon přetrvá. Přehodnoťte kdykoli se změní zdroje dat, uživatelé, modely, dodavatelé, zásady, hardware nebo cíle. Udržovaný systém také potřebuje dokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný bod, kdy má být vypnut nebo nahrazen.
Často kladené otázky
Je hluboké posilovací učení stejné jako hluboké učení?
Ne. Deep learning poskytuje funkční aproximátory; posilovací učení poskytuje interakci, odměnu a cíl sekvenčního rozhodování.
Znamená vysoká odměna, že agent se naučil zamýšlené chování?
Ne nutně. Znamená to, že politika našla chování, které dobře skóruje podle implementované odměny a prostředí. Stále jsou vyžadovány nezávislé testy bezpečnosti a souladu s cílem.
Primární reference












