
Základy AI
Co je NPU? Vysvětlení neuronových zpracovatelských jednotek

 Přidejte Unite.AI mezi své preferované zdroje na Google
Neuronová zpracovatelská jednotka (NPU) je specializovaný akcelerátor určený k efektivnímu provádění běžných operací neuronových sítí. V telefonech, počítačích, vozidlech, kamerách a vestavěných systémech může spouštět podporované AI úlohy s nižší spotřebou energie nebo uvolnit CPU a GPU pro jiné úkoly.
NPU je široký průmyslový termín spíše než jednotná architektura. Výkon závisí na podporovaných operátorech, číselných formátech, paměti, kompilátoru a runtime, termálních limitech a tom, jak velká část aplikace může zůstat na akcelerátoru.
Klíčové body
- NPUs zdůrazňují maticové, vektorové a tenzorové operace s vysokým opakováním dat a nízkou spotřebou energie.
- Špičkový TOPS není benchmark pro celou aplikaci a může předpokládat konkrétní přesnost nebo řídkost.
- Model může vyžadovat konverzi, kvantizaci, rozdělení grafu a záložní řešení pro nepodporované operace.
- Porovnávejte latenci, propustnost, spotřebu energie, paměť, kvalitu, soukromí a přenositelnost na reálném zatížení.
Role CPU, GPU a NPU
CPU vynikají v obecné řízení toku a široké kompatibilitě. GPU poskytují programovatelnou paralelní propustnost a rozsáhlé softwarové ekosystémy. NPUs se specializují na opakované tenzorové operace a mohou zahrnovat lokální paměť, pole násobení‑akumulace a datový tok optimalizovaný pro inferenci.
Heterogenní systémy plánují různé části tam, kde nejlépe zapadají. To je důležité pro edge AI, kde může být udržovaná spotřeba energie a odezva důležitější než špičková propustnost datových center.
Kompilace modelu a jeho provádění
Graf rámce se převádí do mezireprezentace, optimalizuje, kvantizuje podle potřeby a kompiluje pro podporované operátory. Runtime může rozdělit graf tak, aby nepodporované vrstvy běžely na CPU nebo GPU.
Přenosy mezi procesory mohou zrušit výhody akcelerátoru. Statické tvary, rozložení, přesnost, dávkování a opětovné využití paměti ovlivňují výkon. Otestujte zkompilovaný artefakt, protože kvalita deep‑learning modelu se může po konverzi změnit.
Pochopení TOPS a tvrzení o efektivitě
TOPS udává biliony operací za sekundu za definovaných předpokladů. Dodavatelé mohou počítat násobení a sčítání odděleně, používat nízkobitovou celočíselnou přesnost nebo předpokládat řídkost. Vyšší číslo nezaručuje nižší latenci pro konkrétní model.
Měřte studený a teplý start, latenci na dotaz, propustnost, spotřebu energie, špičkovou paměť, termické omezování, podporovaný kontext nebo velikost obrazu a podíl grafu akcelerovaného. Používejte ekvivalentní přesnost a verze softwaru.
Kompromise AI na zařízení
Lokální provádění může snížit závislost na síti a udržet surové vstupy na zařízení, ale stažené modely, logy, zálohy a cloudové záložní řešení stále vytvářejí datové toky. Zabezpečené doručování modelů a aktualizace platformy zůstávají nezbytné.
NPUs mohou podporovat aplikace pro vidění, audio, jazyk a senzory, včetně úloh souvisejících s TinyML. Vývojáři by měli navrhnout elegantní záložní řešení a informovat, když zpracování opustí zařízení.
Architektura NPU a podporované operace
NPU akceleruje tenzorové operace pomocí polí jednotek násobení‑akumulace, lokální paměti, plánování datového toku a specializovaných číselných formátů. Udržování vah a aktivací blízko výpočtu snižuje nákladný přesun dat. Skutečná zařízení se liší v podpoře operátorů, hierarchii paměti, přesnosti, řídkosti, programovatelnosti a způsobu, jakým je práce sdílena s CPU a GPU.
Špičkový výkon se často uvádí v TOPS, ale TOPS nespecifikuje přesnost, využití, limity paměti, pokrytí operátorů ani celkovou latenci. Dva procesory se stejným titulním číslem mohou na stejném modelu podávat odlišně. Proveďte benchmark zkompilovaného modelu, realistických velikostí batchů a sekvencí, předzpracování, přenosů a režimu napájení.
NPUs jsou efektivní pro podporované neuronové úlohy, jako jsou vidění, řeč, odstraňování šumu, efekty pozadí a kompaktní jazykové modely. Nepodporované operátory mohou přejít na CPU nebo GPU, což vytváří přenosy a nepředvídatelnou latenci. Prohlédněte si zprávy kompilátoru a stopy runtime, abyste potvrdili umístění, místo aby se předpokládalo, že celý graf používá akcelerátor.
Konverze modelu, kvantizace a nasazení
Nasazení obvykle postupuje od tréninkového rámce přes export, optimalizaci grafu, kvantizaci, kompilaci dodavatele a integraci runtime. Statické tvary a běžné operátory jsou nejjednodušší k akceleraci. Dynamický řídící tok, vlastní jádra, velké mezitensorové tenzory a nepodporované normalizační nebo attention vzory mohou vyžadovat změny grafu nebo hybridní provádění.
Celočíselné a nízkopřesné formáty snižují velikost modelu, šířku pásma, spotřebu energie a latenci, ale kalibrační data musí reprezentovat reálné vstupy. Porovnejte kvantizaci po tréninku s kvantizací během tréninku, pokud je kvalita citlivá. Vyhodnocujte chování po třídách a v nejhorším případě, protože průměrná přesnost může skrývat degradaci v raritních nebo bezpečnostně důležitých případech.
Inferování na zařízení zlepšuje latenci, offline provoz a soukromí omezením přenosu dat, ale zařízení stále potřebuje zabezpečené modely, přístup k datům s ohledem na oprávnění a mechanismy aktualizací. Chraňte soubory modelů tam, kde je to vhodné, podepisujte aktualizace, zveřejněte cloudové záložní řešení a zajistěte, aby telemetrie neobnovila soukromí, které má lokální architektura snížit.
Hodnocení výkonu a kompromisy na úrovni systému
Měřte studený start a latenci v ustáleném stavu, propustnost, energii na inferenci, paměť, termické chování, přesnost a dopad na baterii. Dlouhé testy odhalí omezování, které krátké benchmarky přehlížejí. Zahrňte před‑ a následné zpracování, protože změna velikosti, tokenizace, dekódování nebo kopírování dat mohou dominovat i jinak rychlému akcelerátoru.
Plánování je systémový problém. CPU řídí logiku aplikace, GPU může renderovat nebo provádět nepodporované vrstvy a NPU spouští kompatibilní grafy. Současné úlohy kamery, audia, displeje a AI soutěží o šířku pásma paměti a energii. Testujte kompletní uživatelský scénář místo izolovaného modelu v nástroji dodavatele.
Přenositelnost zůstává omezená napříč kompilátory a runtime. Upřednostňujte standardní reprezentace modelů, kde fungují, izolujte kód specifický pro dodavatele za rozhraní, zachovejte referenční výstupy a udržujte pokrytí testů zařízení. Vyberte hardware na základě ověřených úloh, podpory softwaru, horizontu aktualizací a celkových nákladů systému – ne jen na základě jediné specifikace akcelerátoru.
Praktický příklad: nasazení vizuálního modelu na notebook s NPU
Tým vyškolí segmentační model pro efekty pozadí, exportuje jej do podporovaného výměnného formátu, nahradí nepodporované operátory a kalibruje celočíselnou kvantizaci pomocí reprezentativních kamer, osvětlení, odstínů pleti, oblečení a pozadí. Kompilátor dodavatele hlásí, které uzly běží na NPU a které přecházejí na záložní řešení. Tým považuje jakýkoli přechod na záložní řešení za systémový náklad, protože přenosy tenzorů mohou dominovat rychlému jednotlivému jádru.
Benchmarky měří předzpracování kamery, provádění modelu, kompozici, paměť, studený start, latenci v ustáleném stavu, stabilitu snímků, spotřebu energie a termické omezování během reálného video hovoru. Výsledky jsou porovnány s cestami CPU a GPU při stejné kvalitě výstupu. Aplikace používá detekci schopností a otestované záložní řešení místo předpokladu, že akcelerátor existuje nebo podporuje stejný graf po aktualizaci ovladače.
Testování vydání zahrnuje modely zařízení, verze operačních systémů a ovladačů, souběžné úlohy, režimy baterie a poškozený vstup. Balíčky modelů jsou podepsané a verzované; telemetrie zaznamenává výkon a selhání bez sběru zbytečného videa. Produkt vysvětluje, kdy zpracování zůstává na zařízení a kdy jsou využívány cloudové funkce. NPU si zaslouží své místo tím, že zlepšuje celkový zážitek za realistických omezení, nikoli dosažením izolovaného TOPS nebo kernelového benchmarku.
Praktický kontrolní seznam implementace
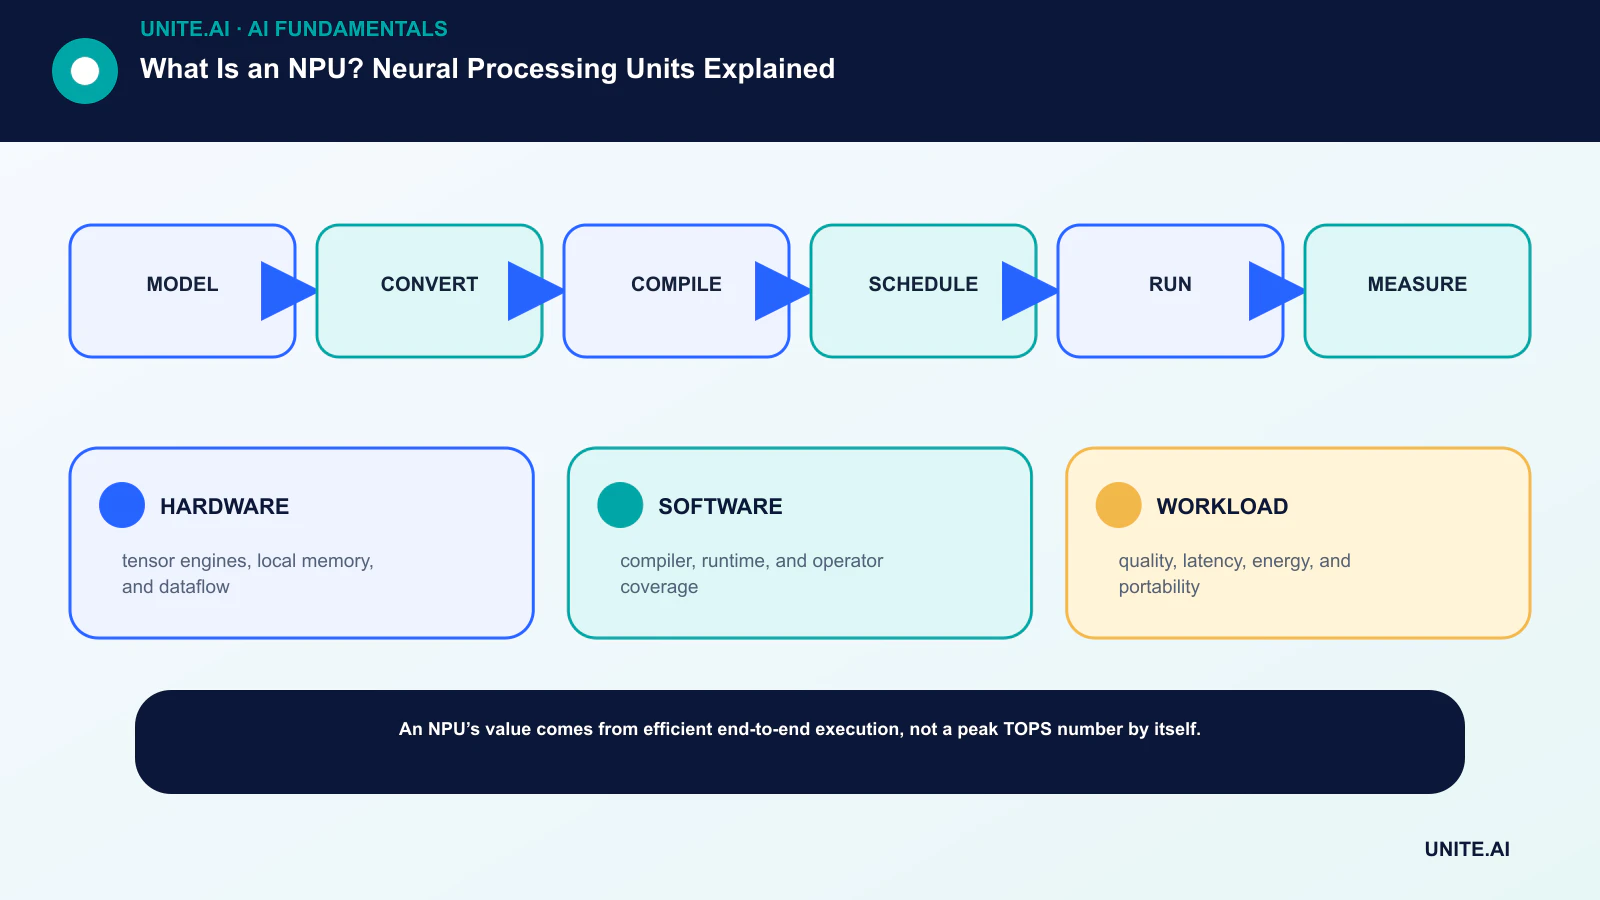
Přeměňte koncept na omezený, testovatelný pracovní postup: model → konverze → kompilace → plánování → spuštění → měření. Určete odpovědnou osobu, zdokumentujte data a závislosti, vytvořte jednoduchou referenční úroveň, stanovte kritéria přijetí a ukončení, otestujte reprezentativní selhání a definujte monitorování, rollback a revizi před rozšířením rozsahu. Zaznamenejte verze a předpoklady, aby jiný tým mohl výsledek reprodukovat a pochopit, co se změnilo.
Před spuštěním proveďte zdokumentovanou revizi připravenosti s lidmi, kteří systém staví, provozují, zabezpečují a jsou jím ovlivněni. Testujte běžné případy, hraniční podmínky, selhání závislostí a zneužití; uchovávejte důkazy a nevyřešená rizika. Definujte, kdo může schválit vydání, změnit práh, přepsat výstup nebo zastavit provoz. Přehodnoťte rozhodnutí po získání reálných dat, protože technicky úspěšný pilot nezaručuje spolehlivý výkon v širším měřítku.
- HARDWARE: tensorové enginy, lokální paměť a datový tok.
- SOFTWARE: kompilátor, runtime a pokrytí operátorů.
- WORKLOAD: kvalita, latence, spotřeba energie a přenositelnost.
Často kladené otázky
Je NPU rychlejší než GPU?
Záleží na modelu, přesnosti, podpoře operátorů, velikosti batchu, limitu napájení a softwaru. NPU může být efektivnější pro podporovanou úlohu na zařízení, zatímco GPU je rychlejší nebo pružnější jinde.
Zachovává NPU všechna AI data soukromá?
Ne. Umožňuje lokální zpracování, ale aplikace může stále odesílat data nebo výstupy do cloudových služeb. Soukromí závisí na celé architektuře a politice.
Primární reference












