
Základy AI
Co je mechanistická interpretovatelnost? Jak výzkumníci analyzují AI modely

 Přidejte Unite.AI mezi své preferované zdroje na Google
Mechanistická interpretovatelnost zkoumá, jak se naučené komponenty uvnitř neuronové sítě kauzálně podílejí na chování. Místo pouhého korelování vstupů a výstupů výzkumníci formulují hypotézy o funkcích, pozornostních hlavách, neuronech a obvodech a poté zasahují, aby tyto hypotézy otestovali.
Obor poskytl podrobné vysvětlení vybraných chování u malých a středně velkých modelů, avšak úplný a věrný popis špičkového modelu zatím není dosažitelný. Automatizovaná vysvětlení a atraktivní vizualizace mohou být užitečným výchozím bodem, nikoli důkazem.
Klíčové poznatky
- Funkce jsou reprezentované vzory; obvody jsou interagující komponenty navržené k implementaci výpočtu.
- Aktivační oprava, ablace a kauzální sledování testují, zda komponenta mění chování.
- Superpozice znamená, že jeden neuron může participovat na mnoha funkcích; řídké autoenkodéry se snaží o jiný základ funkcí.
- Metody interpretovatelnosti potřebují pravdivá data, falsifikovatelné testy, pokrytí a hodnocení vůči alternativním vysvětlením.
Od reprezentace k mechanismu
Zkoumání se ptá, zda lze z aktivace dešifrovat informace. Atribuce odhaduje, které vstupy nebo komponenty jsou podstatné. Mechanistická práce jde dál tím, že navrhuje interní výpočet a kontroluje, zda intervence mění očekávané mezilehlé i konečné chování.
To jej spojuje s, ale je užší než vysvětlitelná AI. Vysvětlení po události pro jedno rozhodnutí není nutně reverzně inženýrovaný algoritmus uvnitř modelu.
Obvody a kauzální intervence
Výzkumníci mohou identifikovat pozornostní hlavu nebo funkci spojenou s úlohou, ablatovat ji, opravit aktivace z jiného běhu nebo sledovat, jak se informace přesouvají napříč vrstvami. Dobrá hypotéza předpovídá chování na nových příkladech a odolává kontrolám.
Intervence mohou vytvořit stavy mimo distribuci, takže změna chování automaticky neodhalí přirozený výpočet. Používejte více metod, odpovídající kontroly a kvantitativní efekty místo jediného ilustračního promptu.
Superpozice a řídké funkce
Neuronové sítě mohou reprezentovat více funkcí než jednotlivé dimenze jejich superpozicí. Neuron se tak může aktivovat pro několik nesouvisejících vzorů, což činí označení na úrovni neuronu zavádějící.
Řídké autoenkodéry se učí větší slovník funkcí z aktivací modelu. Mohou učinit vzory lépe oddělitelné, ale zvolená řídkost, tréninková data, chyba rekonstrukce a automatizovaná označení ovlivňují, co je získáno. Neuronové sítě funkce stále vyžadují kauzální validaci.
Bezpečnost, ladění a omezení
Mechanistické nástroje mohou pomoci najít zapamatované fakty, zaujatosti, klamavé strategie nebo selhávající obvody a mohou podporovat editaci či monitorování. Ty samé nástroje mohou přehlédnout distribuované, vzácné nebo kontextově závislé výpočty.
Považujte zjištění za omezený důkaz: verze modelu, úloha, datová sada, vrstva, intervence, efekt a nejistota. Propojte interpretaci s behaviorálními hodnoceními, red‑teamováním a responsible‑AI správou místo toho, aby se používala jako všeobecný bezpečnostní certifikát.
Reprezentace, obvody a kauzální důkazy
Mechanistická interpretovatelnost zkoumá, jak vnitřní výpočty generují chování modelu. Výzkumníci zkoumají aktivace, váhy, pozornost a mezilehlé funkce a poté formulují hypotézy o reprezentacích a obvodech. Reprezentace není nutně uložena v jednom neuronu; může být rozložena napříč směry, vrstvami, tokeny a kontextově závislými kombinacemi.
Řídké autoenkodéry se snaží rozložit husté aktivace na větší množinu funkcí, které se aktivují selektivně. Štítky funkcí jsou lidské interpretace pozorovaných příkladů, nikoli pravda. Chyba rekonstrukce, řídkost, rozdělení funkcí, absorpce a neaktivní funkce ovlivňují, co rozklad odhalí a co opomíjí.
Korelace není dostatečná pro mechanistické tvrzení. Aktivační oprava, ablace, kauzální sledování, řízení a cílené zásahy do vah testují, zda komponenta mění chování podle předpovědi. Intervence mohou také vytvořit stavy mimo distribuci, takže výsledky vyžadují kontroly, analýzu dávka‑odpověď, alternativní vysvětlení a replikaci napříč promptami a modely.
Přísný workflow interpretovatelnosti
Začněte s přesně změřeným chováním a datovou sadou, která odlišuje konkurenční hypotézy. Lokalizujte relevantní vrstvy, pozice, komponenty nebo funkce; prozkoumejte kandidátské mechanismy; zasáhněte a otestujte, zda navržený obvod předpovídá nové případy. Udržujte průzkumné příklady oddělené od potvrzovacího hodnocení, aby se snížil výběrový bias.
Automatizované nástroje mohou řadit neurony, funkce, hlavy nebo cesty, zatímco jazykové modely mohou navrhovat popisy. Automatizace zvyšuje pokrytí, ale může vytvářet věrohodné příběhy. Hodnoťte vysvětlení na odložených příkladech aktivací a kauzálních předpovědích, zaznamenávejte nejistotu a zajistěte reprodukovatelnost artefaktů pomocí verze modelu, tokenizéru, promptů a kódu.
Mechanismy mohou být polysémantické, redundantní, nelineární a distribuované. Odebrání jedné komponenty může být kompenzováno jinými, zatímco funkce může participovat v několika chováních. Negativní zjištění jsou informativní: zjevný obvod, který selhává mimo kurátorské příklady, by měl být zúžen nebo odmítnut místo toho, aby byl zachráněn stále váhavějším vysvětlením.
Aplikace, omezení a bezpečnostní tvrzení
Interpretovatelnost může pomoci ladit halucinace, zaujatost, memorování, chování typu jailbreak nebo neočekávanou generalizaci; porovnávat modely a generovat vědecké hypotézy. Může také identifikovat funkce pro monitorování či zásah. Tyto využití vyžadují úkolově specifickou validaci, protože užitečná výzkumná vizualizace není automaticky spolehlivou produkční kontrolou.
Absence detekované funkce neprokazuje nepřítomnost schopnosti či úmyslu a čitelná funkce neprokazuje, že model ji používá v konkrétní odpovědi. Nástroje pozorují projekci výpočtu s omezeným pokrytím. Bezpečnostní tvrzení musí uvádět citlivost detekce, falešně pozitivní výsledky, distribuci, protivníka a známé slepé skvrny.
Používejte interpretovatelnost spolu s behaviorálními hodnoceními, red‑teamováním, správou dat, kontrolou přístupu, monitorováním a reakcí na incidenty. Publikujte metody a kontrapříklady, pokud je to možné. Obor se rychle vyvíjí, ale současné techniky neposkytují úplné, věrné vysvětlení uvažování špičkových modelů ani obecnou záruku souladu.
Praktický příklad: testování navrženého modelového obvodu
Předpokládejme, že model používá sadu pozornostních hlav a funkcí k řešení nepřímého objektu ve větě. Výzkumníci definují kontrolovanou datovou sadu s různými jmény, pozicemi, rušivými elementy a kontrapříklady a poté měří chování. Inspekce aktivací identifikuje kandidátské komponenty, ale hypotéza je sepsána před intervencí: jaké informace každá komponenta nese, kam se přesouvá a jak její změna má ovlivnit výstup.
Aktivační oprava a ablace testují nutnost a dostačující podmínku napříč odloženými příklady. Cílená úprava, která změní předpovězený token ve očekávaném směru, podporuje mechanismus; široké poškození výkonu ne. Kontroly opravují nesouvisející pozice a komponenty, mění velikost intervence a porovnávají alternativní obvody. Tým publikuje negativní případy, kde vysvětlení selže, a vyhýbá se přiřazování lidsky čitelného účelu pouze na základě korelace.
Aby bylo možné tvrdit bezpečnostní aplikaci, metoda musí detekovat relevantní chování s známou citlivostí za realistických promptů a protivníkových adaptací. Monitory funkcí jsou hodnoceny z hlediska falešně pozitivních výsledků, obcházení, aktualizací modelu a kauzální relevance. Důkazy interpretovatelnosti mohou vést ladění a další testy, ale vynucení zůstává v externích kontrolách a behaviorálním monitorování. Přesvědčivý diagram obvodu je vědecká hypotéza s důkazy – nikoli úplné vysvětlení modelu ani záruka ohledně neviděného chování.
Praktický kontrolní seznam implementace
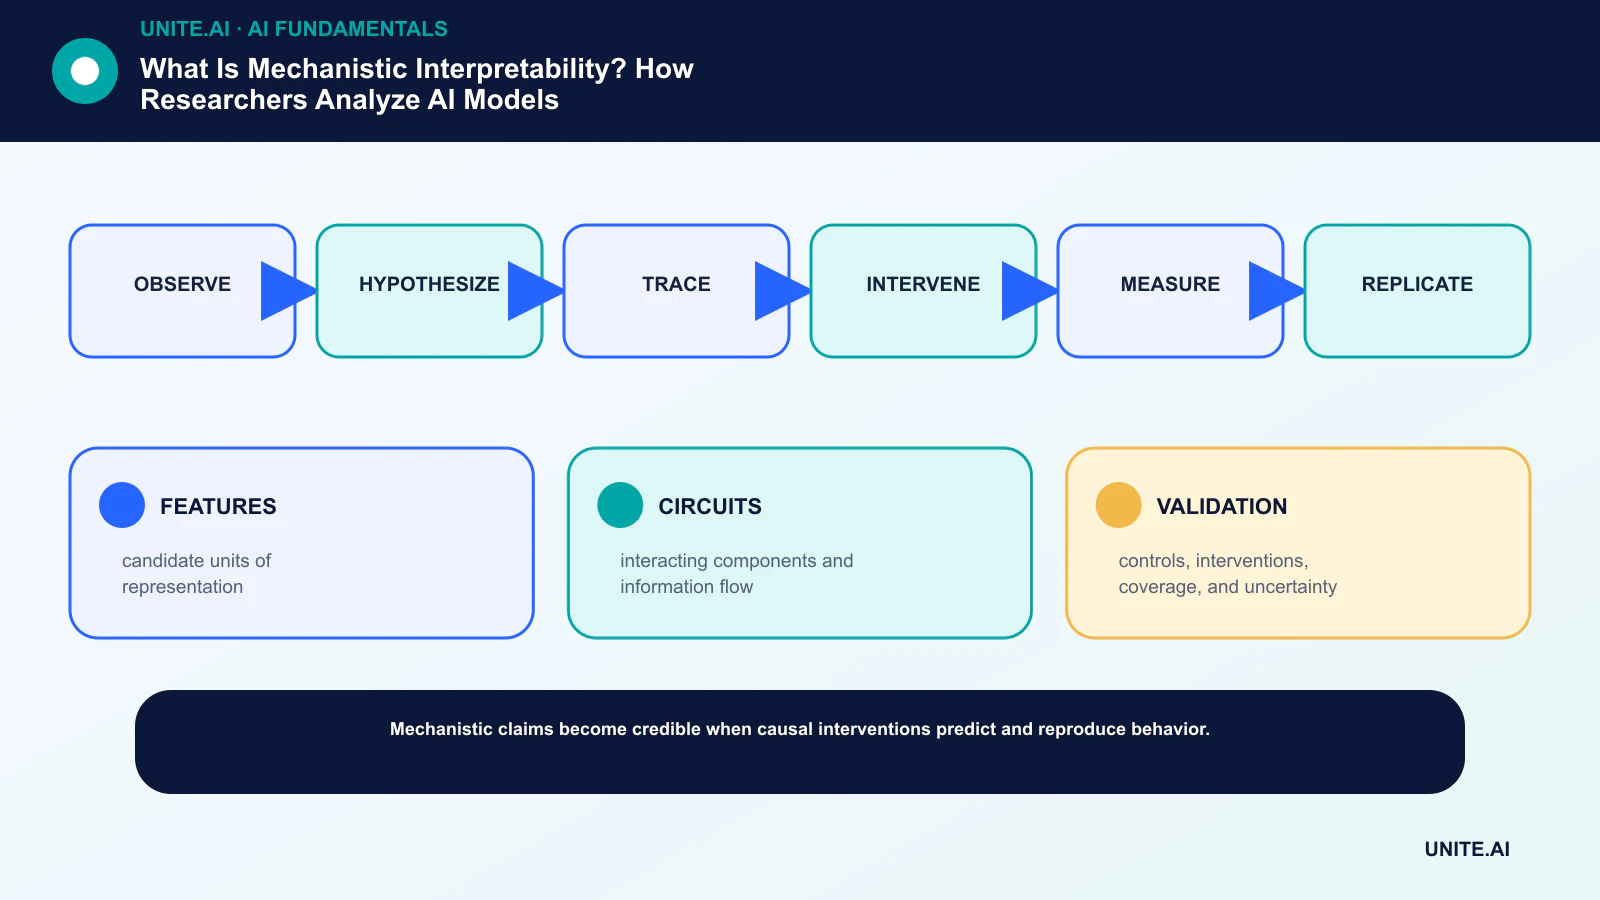
Proměňte koncept v ohraničený, testovatelný workflow: pozorovat → formulovat hypotézu → sledovat → zasahovat → měřit → replikovat. Určete odpovědnou osobu, zdokumentujte data a závislosti, vytvořte jednoduchý základ, stanovte kritéria přijetí a ukončení, otestujte reprezentativní selhání a definujte monitorování, rollback a revizi před rozšířením rozsahu. Zaznamenejte verze a předpoklady, aby jiný tým mohl výsledek reprodukovat a pochopit, co se změnilo.
Před nasazením proveďte zdokumentované hodnocení připravenosti s lidmi, kteří systém staví, provozují, zabezpečují a jsou jím ovlivněni. Testujte běžné případy, okrajové podmínky, selhání závislostí a zneužití; uchovejte důkazy a nevyřešená rizika. Definujte, kdo může schválit vydání, změnit práh, přepsat výstup nebo zastavit provoz. Rozhodnutí přehodnoťte po příchodu reálných dat, protože technicky úspěšný pilot nezaručuje spolehlivý výkon v širším měřítku.
- FEATURES: kandidátní jednotky reprezentace.
- CIRCUITS: interagující komponenty a tok informací.
- VALIDATION: kontroly, intervence, pokrytí a nejistota.
Často kladené otázky
Je mechanistická interpretovatelnost totéž jako čtení vah modelu?
Ne. Samotné váhy nejsou samovysvětlující. Výzkumníci analyzují aktivace, funkce, komponenty a intervence, aby vytvořili a otestovali kauzální hypotézy.
Mohou řídké autoenkodéry plně vysvětlit LLM?
Ne. Poskytují kandidátní základ funkcí a mohou podpořit analýzu obvodů, ale pokrytí, věrnost, rekonstrukce, označování a škálovatelnost zůstávají otevřenými problémy.
Primární reference












