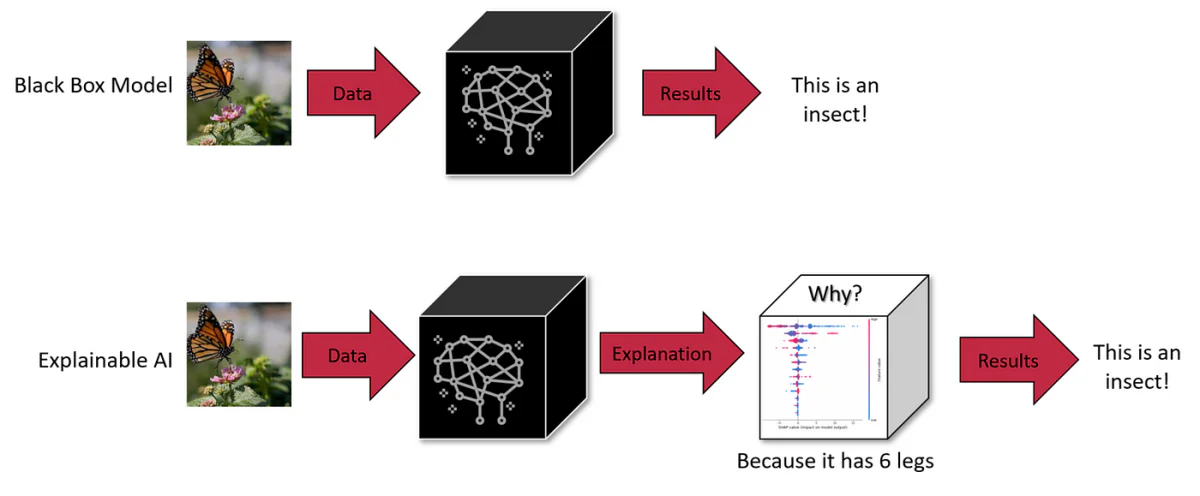
Strojové učení, podmnožina umělé inteligence, zahrnuje tři komponenty: algoritmy, trénovací data a výsledný model. Algoritmus, vlastně soubor procedur, se učí identifikovat vzory z velké sady příkladů (trénovací data). Vyvrcholením tohoto tréninku je model strojového učení. Například algoritmus trénovaný na obrázcích psů by vedl k modelu, který je schopen identifikovat psy na obrázcích.
Černá skříňka ve strojovém učení
Ve strojovém učení může být kterákoli ze tří komponent – algoritmus, trénovací data nebo model – černou skříňkou. Zatímco algoritmy jsou často veřejně známé, vývojáři mohou zvolit uchování modelu nebo trénovacích dat v tajnosti, aby chránili duševní vlastnictví. Tato neprůhlednost činí obtížným pochopit proces rozhodování umělé inteligence.
Černé skříňky umělé inteligence jsou systémy, jejichž vnitřní fungování zůstává neprůhledné nebo neviditelné pro uživatele. Uživatelé mohou zadat data a získat výstup, ale logika nebo kód, který produkuje výstup, zůstává skrytý. To je společná charakteristika mnoha systémů umělé inteligence, včetně pokročilých generativních modelů, jako je ChatGPT a DALL-E 3.
LLM, jako je GPT-4, představují významnou výzvu: jejich vnitřní fungování je z velké části neprůhledné, což je činí “černými skříňkami”. Tato neprůhlednost není pouze technickou hádankou; představuje reálné bezpečnostní a etické obavy. Například, pokud nemůžeme rozpoznat, jak tyto systémy dosahují závěrů, můžeme je důvěřovat v kritických oblastech, jako jsou lékařské diagnózy nebo finanční hodnocení?
Prozkoumání technik LIME a SHAP
Interpretovatelnost ve strojovém učení (ML) a hlubokém učení (DL) nám pomáhá vidět do neprůhledného vnitřního fungování těchto pokročilých modelů. Místní interpretovatelné model-agnostické vysvětlení (LIME) a SHapley Additive exPlanations (SHAP) jsou dvě takové hlavní techniky interpretovatelnosti.
Interpretovatelnost
LIME, například, rozkládá složitost vytvořením jednodušších, místních náhradních modelů, které aproximují chování původního modelu kolem konkrétního vstupu. Tímto způsobem LIME pomáhá porozumět, jak jednotlivé funkce ovlivňují předpovědi komplexních modelů, poskytující vlastně “místní” vysvětlení, proč model učinil určitou rozhodnutí. Je to besonders užitečné pro netechnické uživatele, protože překládá složitý rozhodovací proces modelů do srozumitelnějších termínů.
Model-Agnostic Interpretability of Machine Learning (LIME) Source
SHAP, na druhé straně, čerpá inspiraci z teorie her, konkrétně z konceptu Shapley hodnot. Přisuzuje “důležitost” hodnotu každé funkci, ukazující, jak moc každá funkce přispívá k rozdílu mezi skutečnou předpovědí a základním předpovědí (průměrnou předpovědí napříč všemi vstupy). SHAPova síla spočívá v jeho konzistenci a schopnosti poskytnout globální perspektivu – nejen vysvětluje jednotlivé předpovědi, ale také poskytuje přehled o modelu jako celku. To je zvláště cenné v hlubokém učení, kde propojené vrstvy a četné parametry často činí proces předpovědi podobným cestování skrz labyrint. SHAP demystifikuje toto kvantifikací příspěvku každé funkce, nabízející jasnější mapu rozhodovacích cest modelu.
Oba LIME a SHAP se staly nezbytnými nástroji v oblasti umělé inteligence a strojového učení, řešícími kritickou potřebu transparentnosti a důvěryhodnosti. Jak budeme dále integrovat umělou inteligenci do různých sektorů, schopnost interpretovat a porozumět těmto modelům se stává nejen technickou nutností, ale také základním požadavkem pro etický a zodpovědný vývoj umělé inteligence. Tyto techniky představují významné kroky ve vyřešení složitostí modelů strojového učení a hlubokého učení, transformujících je z neprůhledných “černých skříněk” do srozumitelných systémů, jejichž rozhodnutí a chování lze porozumět, důvěřovat a účinně využívat.
Měřítko a složitost LLM
Měřítko těchto modelů přidává k jejich složitosti. Vezměme si například GPT-3 s jeho 175 miliardami parametrů a novější modely s biliony parametrů. Každý parametr interaguje složitými způsoby v rámci neuronové sítě, přispívaje k emergentním schopnostem, které nelze předpovědět zkoumáním jednotlivých komponent samostatně. Toto měřítko a složitost činí téměř nemožným plně pochopit jejich vnitřní logiku, představující překážku při diagnostice zkreslení nebo nežádoucích chování v těchto modelech.
Obchod: Měřítko vs. Interpretovatelnost
Snížení měřítka LLM by mohlo zvýšit interpretovatelnost, ale za cenu jejich pokročilých schopností. Měřítko je to, co umožňuje chování, které menší modely nemohou dosáhnout. To představuje vnitřní obchod mezi měřítkem, schopnostmi a interpretovatelností.
Dopad problému černé skříňky LLM
1. Chybné rozhodování
Neprůhlednost v rozhodovacím procesu LLM, jako je GPT-3 nebo BERT, může vést k nezjištěným zkreslením a chybám. V oblastech, jako je zdravotnictví nebo trestní soudnictví, kde rozhodnutí mají далеко sahající důsledky, neschopnost auditovat LLM pro etickou a logickou správnost je významnou obavou. Například, lékařský diagnostický LLM spoléhající se na zastaralá nebo zkreslená data může učinit škodlivá doporučení. Podobně, LLM ve výběrovém řízení může neúmyslně prosazovat genderová zkreslení. Černá skříňka tak nejenom skrývá chyby, ale může je potenciálně zesílit, vyžadující proaktivní přístup ke zvýšení transparentnosti.
2. Omezená adaptabilita v rozmanitých kontextech
Nedostatek vhledu do vnitřního fungování LLM omezuje jejich adaptabilitu. Například, LLM pro výběr zaměstnanců může být neefektivní při hodnocení kandidátů pro roli, která hodnotí praktické dovednosti nad akademickými kvalifikacemi, kvůli jeho neschopnosti upravit kritéria hodnocení. Podobně, lékařský LLM může mít potíže s diagnózou vzácných onemocnění kvůli nerovnováze dat. Tato inflexibilita zdůrazňuje potřebu transparentnosti pro opětovné kalibraci LLM pro specifické úkoly a kontexty.
3. Zkreslení a mezery v znalostech
LLM zpracování velkých trénovacích dat je podřízeno omezením uloženým jejich algoritmy a modelovými architekturami. Například, lékařský LLM může projevit demografická zkreslení, pokud je trénován na nevyvážených datech. Kromě toho, LLMova způsobilost v niklových tématech může být klamná, vedoucí k přehnaným, nesprávným výstupům. Řešení těchto zkreslení a mezer v znalostech vyžaduje více než jen další data; vyžaduje zkoumání vnitřní mechaniky modelu.
4. Právní a etická zodpovědnost
Neprůhledná povaha LLM vytváří právní šedou zónu ohledně zodpovědnosti za jakoukoli újmu způsobenou jejich rozhodnutími. Pokud LLM ve zdravotnickém prostředí poskytuje vadná doporučení, vedoucí k poškození pacienta, stanovení zodpovědnosti se stává obtížným kvůli neprůhlednosti modelu. Tato právní nejistota představuje rizika pro subjekty, které nasazují LLM ve citlivých oblastech, zdůrazňující potřebu jasných pravidel a transparentnosti.
5. Problémy důvěry v citlivých aplikacích
Pro LLM používané v kritických oblastech, jako je zdravotnictví a finance, nedostatek transparentnosti podkopává jejich důvěryhodnost. Uživatelé a regulátoři potřebují zajistit, aby tyto modely neobsahovaly zkreslení nebo nedělaly rozhodnutí založená na nespravedlivých kritériích. Ověření absence zkreslení v LLM vyžaduje porozumění jejich rozhodovacím procesům, zdůrazňující důležitost vysvětlitelnosti pro etické nasazení.
6. Rizika s osobními údaji
LLM vyžadují rozsáhlá trénovací data, která mohou zahrnovat citlivé osobní informace. Neprůhledná povaha těchto modelů vyvolává obavy o tom, jak jsou tato data zpracovávána a využívána. Například, lékařský LLM trénovaný na pacientských záznamech vyvolává otázky o ochraně dat a jejich využívání. Zajištění toho, aby osobní údaje nebyly zneužity nebo využity, vyžaduje transparentní procesy zpracování dat uvnitř těchto modelů.
Vznikající řešení pro interpretovatelnost
Pro řešení těchto výzev se vyvíjejí nové techniky. Tyto zahrnují aproximace kontrafaktů. První metoda zahrnuje vyvolání LLM ke změně konkrétního textu, zatímco ostatní koncepty zůstávají konstantní. Tento přístup, ačkoli účinný, je náročný na zdroje během inferenční fáze.
Druhý přístup zahrnuje vytvoření speciálního prostoru pro vložení, řízeného LLM během tréninku. Tento prostor se shoduje s kauzálním grafem a pomáhá identifikovat shody aproximujících se kontrafaktů. Tato metoda vyžaduje méně zdrojů během testovací fáze a prokázala se jako účinná při vysvětlování modelových předpovědí, dokonce i u LLM s miliardami parametrů.
Tyto přístupy zdůrazňují důležitost kauzálních vysvětlení v systémech NLP, aby zajistily bezpečnost a důvěru. Aproximace kontrafaktů poskytují způsob, jak si představit, jak by se daný text změnil, kdyby byl jiný koncept v jeho generativním procesu. To pomáhá při praktickém odhadu kauzálního efektu vysokých konceptů na modely NLP.
Deep Dive: Vysvětlitelné metody a kauzalita v LLM
Probing a nástroje pro důležitost funkcí
Probing je technika používaná k rozluštění, co vnitřní reprezentace v modelech kódují. Může být buď dohlížená nebo nedohližená a je zaměřena na určení, zda konkrétní koncepty jsou zakódovány na určitých místech v síti. Ačkoli účinná do jisté míry, sondy selhávají v poskytování kauzálních vysvětlení, jak je zdůrazněno Geigerem et al. (2021).
Nástroje pro důležitost funkcí, další forma vysvětlovací metody, se často soustředí na vstupní funkce, ačkoli některé gradientem-založené metody rozšiřují tuto analýzu na skryté stavy. Příkladem je metoda Integrated Gradients, která nabízí kauzální interpretaci prozkoumáním základních (kontrafaktických, CF) vstupů. Navzdory jejich užitečnosti tyto metody stále zápasí s propojením svých analýz s reálnými koncepty beyond jednoduchých vstupních vlastností.
Zásahem-založené metody
Zásahem-založené metody zahrnují modifikaci vstupů nebo vnitřních reprezentací pro studium efektů na chování modelu. Tyto metody mohou vytvářet kontrafaktické stavy pro odhad kauzálních efektů, ale často generují nepravděpodobné vstupy nebo síťové stavy, pokud nejsou pečlivě kontrolovány. Kauzální proxy model (CPM), inspirovaný konceptem S-learner, je novým přístupem v této oblasti, imitujícím chování vysvětlovaného modelu pod kontrafaktickými vstupy. Nicméně, potřeba samostatného vysvětlovače pro každý model je významnou limitací.
Aproximace kontrafaktů
Kontrafaktory jsou široce používány ve strojovém učení pro augmentaci dat, zahrnující perturbace různých faktorů nebo štítků. Tyto lze generovat prostřednictvím manuálního editování, heuristického klíčového slova nahrazování nebo automatizovaného textového přepisování. Zatímco manuální editování je přesné, je také náročné na zdroje. Klíčové slovo-založené metody mají své omezení, a generativní přístupy nabízejí rovnováhu mezi plynulostí a pokrytím.
Věrná vysvětlení
Věrnost ve vysvětleních se vztahuje k přesnému znázornění základního uvažování modelu. Neexistuje univerzálně přijímaná definice věrnosti, vedoucí k její charakterizaci prostřednictvím různých metrik, jako je Senzitivita, Konsistence, Dohoda o důležitosti funkcí, Odolnost a Simulovatelnost. Většina z těchto metod se soustředí na vysvětlení na úrovni funkcí a často splétá korelaci s kauzalitou. Naše práce si klade za cíl poskytnout vysvětlení konceptů na vysoké úrovni, využívající kauzalitní literaturu k navržení intuitivního kritéria: Řád-věrnost.
Prozkoumali jsme vnitřní složitosti LLM, porozuměli jejich “černé skříňce” a významným výzvám, které představují. Od rizik chybného rozhodování v citlivých oblastech, jako je zdravotnictví a finance, až po etické dilemata týkající se zkreslení a spravedlnosti, potřeba transparentnosti v LLM nikdy nebyla více zřejmá.
Budoucnost LLM a jejich integrace do našeho každodenního života a kritických rozhodovacích procesů závisí na naší schopnosti učinit tyto modely nejen pokročilejšími, ale také srozumitelnějšími a zodpovědnějšími. Pronásledování vysvětlitelnosti a interpretovatelnosti není pouze technickým úkolem, ale základním aspektem budování důvěry v systémy umělé inteligence. Jak LLM budou více integrovány do společnosti, poptávka po transparentnosti poroste, nejen od praktiků umělé inteligence, ale od každého uživatele, který interaguje s těmito systémy.
Já pět let se ponořím do fascinujícího světa strojového učení a hlubokého učení. Mé vášně a odborné znalosti mě vedly k tomu, abych se podílel na více než 50 různých projektech softwarového inženýrství, se zvláštním zaměřením na AI/ML. Mé pokračující zvědavosti mě také přivedly k přirozenému jazykovému zpracování, oblasti, kterou jsem ochoten prozkoumat dále.


 Přidejte Unite.AI mezi své preferované zdroje na Google