
Andersonův úhel
GAN jako nástroj pro vykreslování tváří v tradičním CGI

 Přidejte Unite.AI mezi své preferované zdroje na Google

Klíčové bodyOddělení identity od výrazu v latentním prostoru GAN zůstává ústředním nevyřešeným…
Zobrazit více
- Oddělení identity od výrazu v latentním prostoru GAN zůstává ústředním nevyřešeným problémem syntézy obličejových videí.
- Parametrické CGI modely jako SMPL a 3DMM jsou stále častěji používány k vnesení řádu do neukázněných latentních kódů GAN.
- Hybridní přístup Rendering with Style od Disney přinesl znepokojivé výsledky sloučením tradičních textur s obrazy generovanými GAN.
Názor Když generativní adversariální sítě (GAN) poprvé prokázaly schopnost vytvářet překvapivě realistické 3D obličeje, vyvolalo to zlatou horečku kolem jejich nevyužitého potenciálu pro časově konzistentní videa lidských tváří.
Někde v latentním prostoru GAN jako by musel existovat skrytý řád a racionalita: zárodek sémantické logiky v latentních kódech, který by umožnil vytvářet konzistentní pohledy a různá ztvárnění, například změny výrazu, téže tváře. Výsledkem by byla časově přesvědčivá metoda deepfake videa, která by výrazně překonala autoenkodéry.
Vysoké výstupní rozlišení by bylo snadné ve srovnání s prostředím nízkých rozlišení, k němuž omezení GPU nutí DeepFaceLab a FaceSwap. Oblast výměny tváře z pracovních postupů s autoenkodéry by se stala oblastí tvorby GAN, řízenou několika vstupními snímky nebo dokonce jediným.
Mezi vyměňovanou a hostitelskou tváří by již nebyl nesoulad, protože celý obraz by vznikal od základu, včetně vlasů, linie čelisti a vnějších okrajů obličejových rysů, které často působí potíže tradičním deepfake metodám s autoenkodéry.
Zima obličejového videa s GAN
Ukázalo se však, že to nebude tak snadné. Ústředním problémem se stalo oddělení jednotlivých faktorů, které zůstává hlavní výzvou. Jak zachovat rozpoznatelnou identitu obličeje a změnit jeho polohu nebo výraz bez shromáždění tisíců referenčních snímků, na nichž se síť učí, co tyto změny znamenají, jak to pracně dělají autoenkodéry?
Další výzkum animace a syntézy obličejů pomocí GAN místo toho předpokládal, že vstupní identitě lze přiřadit účelové, obecné, šablonové transformace, které nejsou specifické pro danou osobu. Příkladem je aplikace výrazu, který není zachycen na žádném snímku této osoby známém síti GAN.

Studie Tensor-based Emotion Editing in the StyleGAN Latent Space z roku 2022 aplikuje šablonové výrazy na vstupní obličej ze souboru FFHQ. Zdroj: https://arxiv.org/pdf/2205.06102.pdf
Univerzální přístup samozřejmě nemůže pokrýt rozmanitost výrazů jedinečných pro každého člověka. Je otázkou, zda by tak osobitý úsměv, jaký má Jack Nicholson nebo Willem Dafoe, mohl být věrně ztvárněn pomocí latentních kódů pro průměrný výraz.

Kdo je tento okouzlující latinskoamerický cizinec? GAN sice vytváří realističtější tvář ve vyšším rozlišení, transformace však nevychází z mnoha skutečných fotografií herce jako DeepFaceLab, který se rozsáhle učí na tisících takových snímků. Podobnost proto trpí. Zde je v pozadí model DeepFaceLab importován do DeepFaceLive, streamovací podoby tohoto populárního a kontroverzního softwaru. Ukázky pocházejí z https://www.youtube.com/watch?v=9tr35y-yQRY (2022) a https://arxiv.org/pdf/2205.06102.pdf.
V posledních letech byla navržena řada editorů obličejových výrazů založených na GAN. Většina pracuje s neznámými identitami, takže běžný čtenář nemůže posoudit věrnost transformací, protože tyto tváře nezná.

Transformace neznámých identit v metodě Cascade-EF-GAN z roku 2020. Zdroj: https://arxiv.org/pdf/2003.05905.pdf
Snad největší zájem a počet citací během posledních tří let získal editor InterFaceGAN, který umí procházet latentním prostorem podle polohy, tedy úhlu kamery nebo tváře, výrazu, věku, rasy, pohlaví a dalších zásadních vlastností.
Možnosti morfování ve stylu 80. let u InterFaceGAN a podobných systémů především ukazují cestu transformace, při níž se obraz zpětně promítá přes vhodný latentní kód, například věku. Pro video s časovou návazností se však podobné postupy zatím projevují jako působivé katastrofy.
Přidáme-li obtížnost tvorby časově konzistentních vlasů a fakt, že průzkum či manipulace latentních kódů nemají zabudované časové vedení, lze logicky usoudit, že GAN není vše, co potřebujete™ pro syntézu videa obličejů. Není ani jasné, jak časové vedení doplnit do systému navrženého pro statické obrázky, bez nativní podpory videovýstupu.
Pozdější úsilí přineslo postupná zlepšení oddělení faktorů, zatímco další výzkum přidal postupy počítačového vidění jako vrstvu vedení, například sémantickou segmentaci coby řídicí mechanismus ve studii SemanticStyleGAN: Learning Compositional Generative Priors for Controllable Image Synthesis and Editing z konce roku 2021.
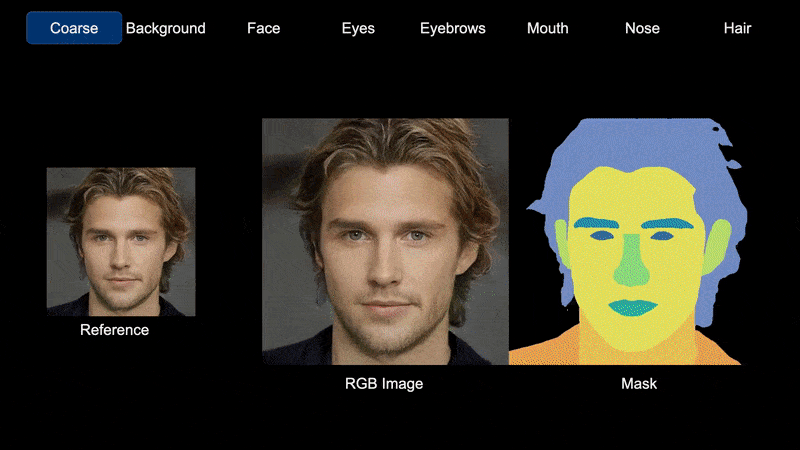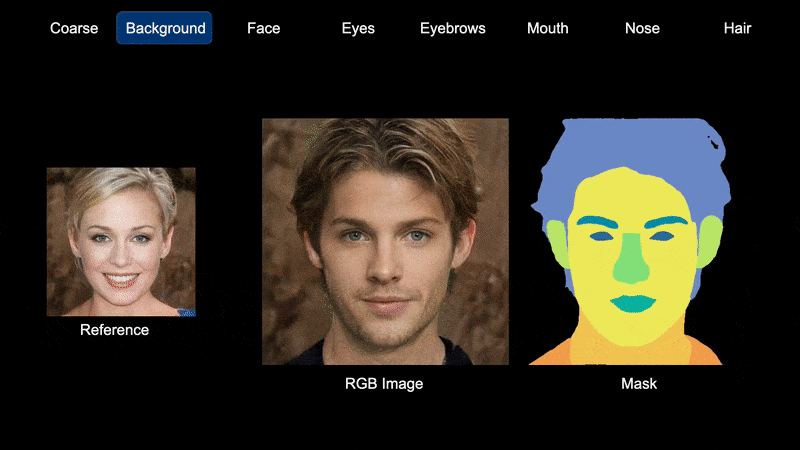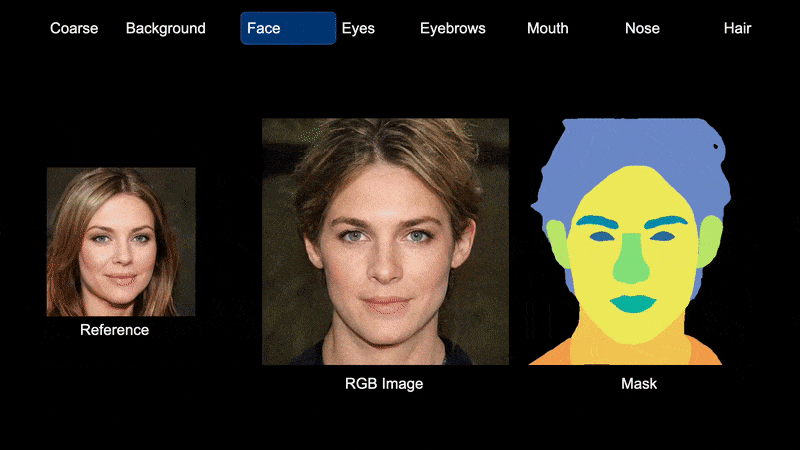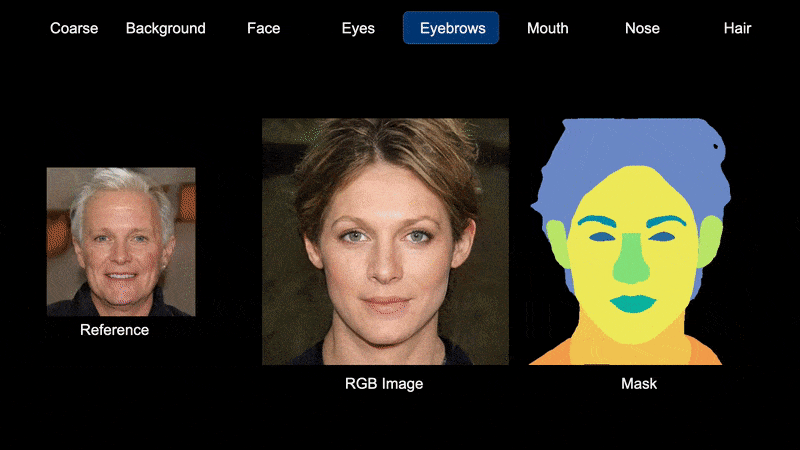
Sémantická segmentace jako prostředek řízení latentního prostoru v SemanticStyleGAN. Zdroj: https://semanticstylegan.github.io/
Parametrické vedení
Výzkum syntézy obličejů pomocí GAN stále více používá tradiční parametrické tváře CGI jako prostředek vedení a uspořádání působivých, ale obtížně ovladatelných latentních kódů.
Parametrické obličejové prvky jsou součástí výzkumu počítačového vidění již více než dvacet let. Zájem však nedávno vzrostl s častějším použitím prvků CGI Skinned Multi-Person Linear Model (SMPL), přístupu vyvinutého Institutem Maxe Plancka a ILM a následně zdokonaleného systémem Sparse Trained Articulated Human Body Regressor (STAR).

SMPL, zde ve variantě SMPL-X, dokáže překrýt obraz parametrickou sítí CGI odpovídající odhadnuté poloze celého zobrazeného lidského těla, případně včetně výrazů. Síť pak slouží jako objemové nebo percepční vodítko pro další operace s obrázkem. Zdroj: https://arxiv.org/pdf/1904.05866.pdf
Nejoceňovanějším vývojem v tomto směru byla iniciativa Disney z roku 2019 Rendering with Style, která kombinovala tradiční texturové mapy s obrázky GAN ve snaze vytvořit kvalitnější animaci ve stylu deepfake.

Spojení starého s novým v hybridním přístupu Disney k deepfake záběrům vytvářeným GAN. Zdroj: https://www.youtube.com/watch?v=TwpLqTmvqVk
Disney vkládá tradičně renderované prvky CGI do sítě StyleGAN2, která doplňuje lidské tváře v problémových oblastech, například textuře kůže, kde při tvorbě videa vznikají potíže s časovou konzistencí.

Pracovní postup Rendering with Style.
Parametrickou hlavu CGI, která proces řídí, lze upravit podle potřeb uživatele. Tvář vytvořená GAN může tyto změny odrážet, včetně změn polohy a výrazu.
Metoda má spojovat ovladatelnost CGI s přirozeným realismem tváří GAN, výsledky však nakonec ukazují nevýhody obou přístupů. Stále nedokážou zachovat texturu vlasů ani základní polohu rysů:
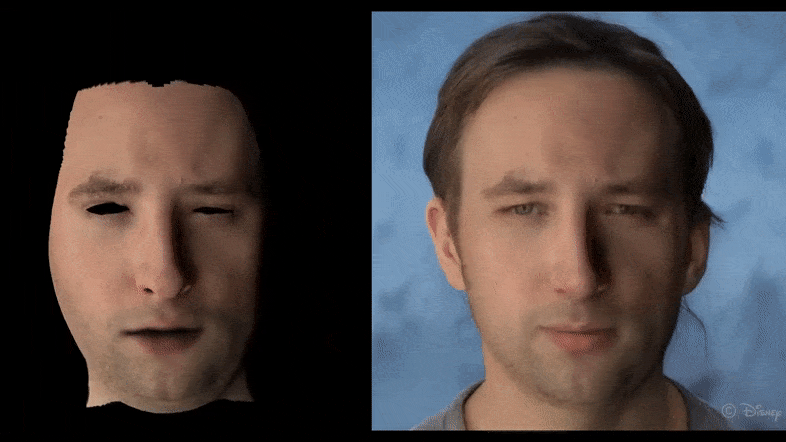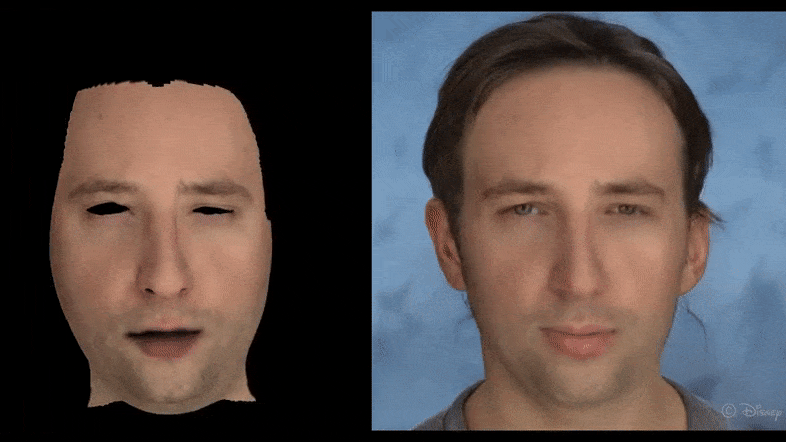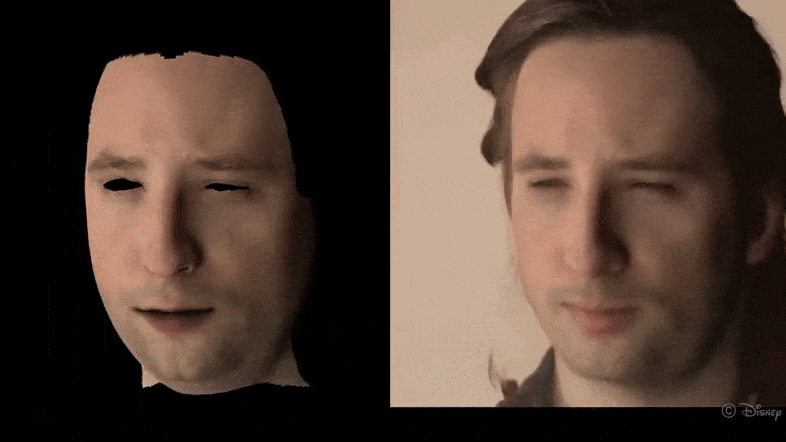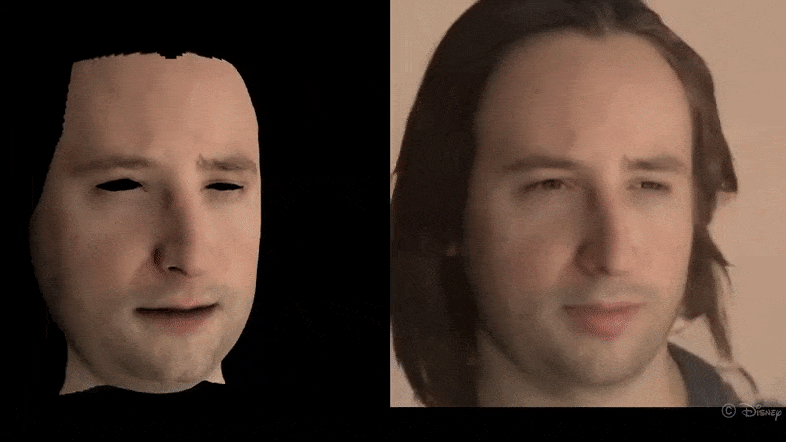
Rendering with Style vytváří novou podobu tísnivého údolí, i když samotný princip má určitý potenciál.
Výzkumná práce StyleRig: Rigging StyleGAN for 3D Control over Portrait Images z roku 2020 používá stále populárnější přístup: trojrozměrné deformovatelné modely obličeje (3DMM) slouží jako prostředníci při změnách vlastností ve StyleGAN. Zde je řídí nová síť RigNet:

Modely 3DMM slouží ve StyleRig jako prostředníci pro interpretaci latentního prostoru. Zdroj: https://arxiv.org/pdf/2004.00121.pdf
Jako obvykle u podobných projektů jsou však dosavadní výsledky omezeny na malé změny polohy a změny výrazu či emočního stavu bez vedení podle specifik dané osoby.

StyleRig zlepšuje ovladatelnost, časově konzistentní vlasy však zůstávají nevyřešenou výzvou. Zdroj: https://www.youtube.com/watch?v=eaW_P85wQ9k
Podobné výsledky nabízí MOST-GAN od Mitsubishi Research, studie z roku 2021, která používá nelineární 3DMM jako architekturu oddělování faktorů, ale rovněž má potíže s dynamickým a konzistentním pohybem.
Nejnovějším výzkumem usilujícím o ovladatelnost a oddělení faktorů je One-Shot Face Reenactment on Megapixels, který opět používá parametrické hlavy 3DMM jako uživatelsky přívětivé rozhraní pro StyleGAN.

V postupu MegaFR systému One-Shot Face Reenactment síť syntetizuje tváře kombinací skutečného snímku převedeného inverzí do latentní reprezentace s parametry získanými z renderovaného modelu 3DMM. Zdroj: https://arxiv.org/pdf/2205.13368.pdf
OSFR patří k rostoucí skupině editorů obličejů GAN usilujících o lineární editaci ve stylu Photoshopu či After Effects. Uživatel vloží požadovaný obrázek a aplikuje na něj změny, místo aby v latentním prostoru hledal kódy související s identitou.
Parametrické výrazy jsou opět obecným, nepersonalizovaným způsobem přidání výrazu. Výsledné změny mohou působit znepokojivě, svým vlastním a ne vždy pozitivním způsobem.

Výrazy vložené do OSFR.
Podobně jako předchozí práce dokáže OSFR z jediného obrázku odvodit polohy blízké původní a provést frontalizaci: změnit tvář zachycenou šikmo na čelní portrét.

Původní snímek nahoře a odvozené čelní portréty z jedné z implementací OSFR popsaných v nové studii.
V praxi tento druh odvozování připomíná některé principy fotogrammetrie, na nichž stojí neuronová pole záření (NeRF). Zde však musí být geometrie určena z jediného snímku, nikoli ze 3–4 pohledů, které umožňují NeRF odvodit chybějící mezilehlé polohy a vytvořit prozkoumatelné neuronové 3D scény s lidmi.
(Ani NeRF však není vše, co potřebujete™: při syntéze videa tváří naráží oproti GAN na téměř zcela jiný soubor překážek.)
Má GAN místo v syntéze videa obličejů?
Získávání dynamických výrazů a poloh mimo distribuci trénovacích dat z jediného zdrojového snímku se nyní ve výzkumu syntézy obličejů pomocí GAN zdá být alchymistickou posedlostí. GAN jsou totiž v současnosti jedinou metodou schopnou vytvářet neuronové tváře s poměrně vysokým rozlišením a věrností. Systémy deepfake s autoenkodéry se sice mohou učit z mnoha skutečných poloh a výrazů, ale rozlišení vstupu i výstupu omezuje VRAM a potřebují hostitelský obraz. NeRF je podobně omezené a na rozdíl od obou dalších přístupů zatím nemá zavedené metody změny výrazů obličeje; obecně nabízí jen omezené úpravy.
Jedinou cestou k přesnému systému CGI/GAN se zdá být nový způsob sestavení identity z několika fotografií v latentním prostoru. Kód identity osoby by pak nemusel procházet celým prostorem kvůli nesouvisejícím parametrům polohy, ale mohl by používat vlastní související skutečné snímky jako reference pro transformace.
I v takovém případě, nebo kdyby byla celá síť StyleGAN trénována na souboru tváří jediné identity podobně jako autoenkodéry, by chybějící sémantickou logiku pravděpodobně stále musely dodat pomocné technologie, například sémantická segmentace či parametrické tváře 3DMM. V tomto scénáři by alespoň měly více podkladů.


