
Modely a platformy AI
Životní cyklus vývoje AI: kompletní rozbor v roce 2023

 Přidejte Unite.AI mezi své preferované zdroje na Google
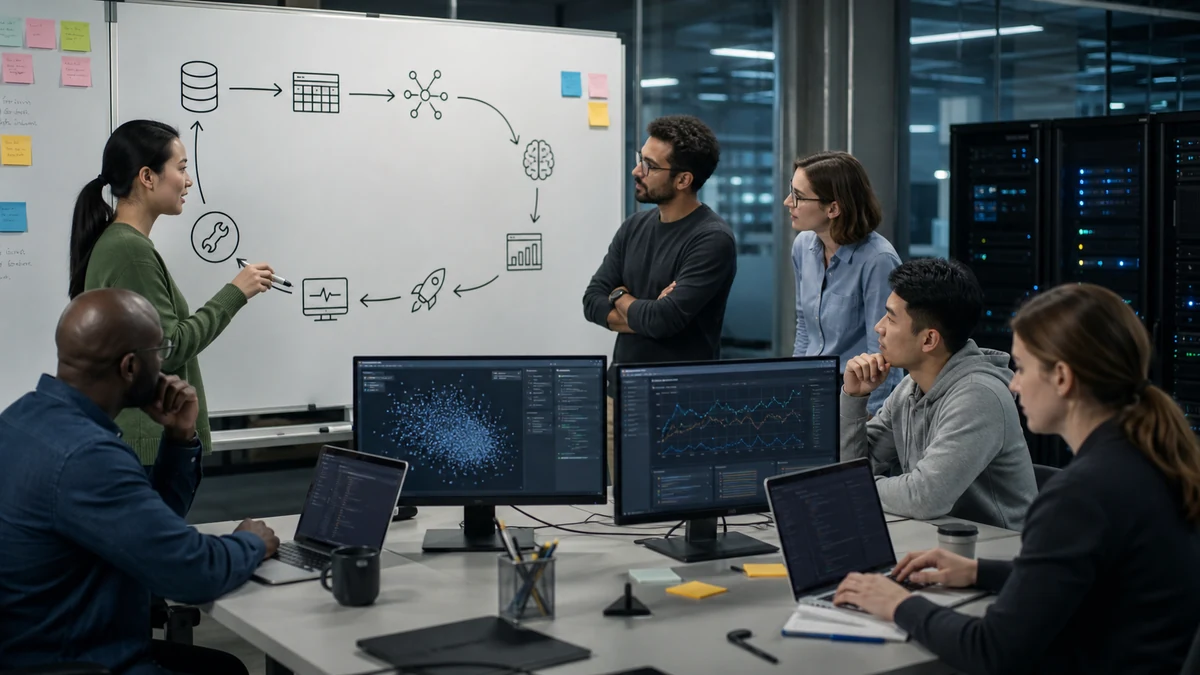
Umělá inteligence (AI) se v posledních letech stala technologickým fenoménem, který nabízí podnikům potenciál odemknout nové poznatky, optimalizovat provoz a poskytovat lepší zákaznické zkušenosti. 91,5 % předních podniků průběžně investovalo do AI. Protože AI pokračuje ve svém růstu jako silné řešení moderních podnikatelských problémů, životní cyklus vývoje AI se stává stále složitějším. Dnes AI vývojáři čelí několika výzvám, včetně kvality dat, množství, výběru správné architektury atd., které musí být řešeny během celého životního cyklu AI.
Hlavním cílem je dosáhnout výhod AI, což vyžaduje strukturovaný a přísný přístup k vývoji AI, který zahrnuje celý životní cyklus, od definice problému až po nasazení modelu a dále. Podívejme se na různé fáze úspěšného životního cyklu vývoje AI a diskutujme o různých výzvách, kterým čelí vývojáři AI.
9 fází budování úspěšného životního cyklu vývoje AI
Vývoj a nasazení projektu AI je iterativní proces, který vyžaduje opakování kroků pro optimální výsledky. Zde jsou devět fází budování úspěšného životního cyklu vývoje AI.
1. Obchodní cíl a případ použití
První fází životního cyklu vývoje AI je identifikace obchodního cíle nebo problému, který AI může řešit, a vypracování strategie AI. Mít jasnou představu o problému a o tom, jak AI může pomoci, je zásadní. Stejně důležité je mít přístup k správným talentům a dovednostem, které jsou nezbytné pro vývoj efektivního modelu AI.
2. Sběr a průzkum dat
Po stanovení obchodního cíle je další fází životního cyklu AI sběr relevantních dat. Přístup k správným datům je kritický pro budování úspěšných modelů AI. Existuje několik technik pro sběr dat, včetně crowdsourcingu, scrapingu a použití syntetických dat.
Syntetická data jsou uměle vytvořenými informacemi, které jsou užitečné v různých scénářích, jako je například trénování modelů, když jsou skutečná data vzácná, vyplňování mezer v trénovacích datech a urychlení vývoje modelu.
Jakmile jsou data shromážděna, další fází je provedení exploratorní analýzy dat a vizualizací. Tyto techniky pomáhají pochopit, jaké informace jsou k dispozici v datech, a které procesy jsou potřebné pro přípravu dat pro trénování modelu.
3. Předzpracování dat
Po sběru a průzkumu dat jsou data podrobena další fázi, předzpracování, které pomáhá připravit surová data a učinit je vhodnými pro budování modelu. Tato fáze zahrnuje různé kroky, včetně čištění dat, normalizace a rozšíření.
- Čištění dat – zahrnuje identifikaci a opravu chyb nebo nesrovnalostí v datech.
- Normalizace dat – zahrnuje transformaci dat na společnou škálu.
- Rozšíření dat – zahrnuje vytváření nových datových vzorků aplikací různých transformací na existující data.
4. Tvorba příznaků
Tvorba příznaků zahrnuje vytváření nových proměnných z dostupných dat za účelem zlepšení výkonu modelu. Cílem tohoto procesu je zjednodušit transformace dat a zlepšit přesnost, tvorbou příznaků pro učení s učitelem i bez učitele.
Zahrnuje různé techniky, jako je zpracování chybějících hodnot, odlehlých hodnot a transformace dat prostřednictvím kódování, normalizace a standardizace.
Tvorba příznaků je kritické ve životním cyklu vývoje AI, protože pomáhá vytvořit optimální příznaky pro model a činí data snadno pochopitelnými pro stroj.
5. Trénování modelu
Po přípravě trénovacích dat je model AI iterativně trénován. Během tohoto procesu lze testovat různé algoritmy strojového učení a datové sady, a vybrat a doladit optimální model pro přesné predikce.
Můžete vyhodnotit výkon trénovaného modelu na základě různých parametrů a hyperparametrů, jako je rychlost učení, velikost dávky, počet skrytých vrstev, aktivační funkce a regularizace, které jsou upraveny pro dosažení nejlepších možných výsledků.
Navíc mohou podniky využít přenosového učení, které zahrnuje použití předem trénovaného modelu pro řešení jiného problému. To může ušetřit značné množství času a zdrojů, eliminovat potřebu trénovat model od začátku.
6. Evaluace modelu
Jakmile je model AI vyvinut a trénován, evaluace modelu je další fází životního cyklu vývoje AI. Zahrnuje hodnocení výkonu modelu pomocí vhodných evaluačních metrik, jako je celková správnost (accuracy), skóre F1, logaritmická ztráta, přesnost pozitivních predikcí (precision) a úplnost (recall), pro určení jeho účinnosti.
7. Nasazení modelu
Nasazení modelu ML zahrnuje integraci modelu do produkčního prostředí pro generování užitečných výstupů pro podnikové rozhodování. Existují různé typy nasazení, včetně batch inference, on-premises, cloud-based a edge nasazení.
- Batch inference – proces opakovaného generování predikcí pro dávku dat.
- On-premises nasazení – zahrnuje nasazení modelů na místní hardwarové infrastruktuře vlastněné a udržovaném organizací.
- Cloud nasazení – zahrnuje nasazení modelů na vzdálených serverech a výpočetní infrastruktuře poskytované třetími stranami.
- Edge nasazení – zahrnuje nasazení a spouštění modelů strojového učení na místních nebo “edge” zařízeních, jako jsou chytré telefony, senzory nebo IoT zařízení.
8. Monitorování modelu
Výkon modelu AI může degenerovat časem kvůli nesrovnalostem, zkreslení a posunům dat. Monitorování modelu je kritické pro identifikaci, kdy k tomu dochází. Proaktivní opatření, jako je MLOps (Machine Learning Operations), optimalizují a zefektivňují nasazení modelů strojového učení do produkce a udržují je.
9. Údržba modelu
Údržba nasazených modelů je kritická pro zajištění jejich pokračující spolehlivosti a přesnosti. Jedním z přístupů k údržbě modelu je vytvoření pipeline pro opětovné trénování modelu. Taková pipeline může automaticky trénovat model pomocí aktualizovaných dat, aby zůstal relevantní a efektivní.
Jiným přístupem k údržbě modelu je posilovací učení, které zahrnuje trénování modelu pro zlepšení jeho výkonu poskytováním zpětné vazby na jeho rozhodnutí.
Implementací technik údržby modelu mohou organizace zajistit, aby jejich nasazené modely zůstaly efektivní. V důsledku toho modely poskytují přesné predikce, které jsou v souladu s měnícími se trendy a podmínkami dat.
Kterým výzvám mohou vývojáři čelit během životního cyklu vývoje AI?

Ilustrace od L_Nuge z Adobe Stock
S rostoucí složitostí modelů AI mohou vývojáři AI a datoví vědci čelit různým výzvám v různých fázích životního cyklu vývoje AI. Některé z nich jsou uvedeny níže.
- Křivka učení: Kontinuální poptávka po učení nových technik AI a jejich efektivní integraci může odvádět vývojáře od jejich hlavního úkolu, kterým je vytváření inovativních aplikací.
- Nedostatek hardwaru připraveného na budoucí požadavky: To může bránit vývojářům ve vytváření inovativních aplikací, které jsou v souladu s jejich současnými a budoucími podnikatelskými požadavky.
- Používání složitých softwarových nástrojů: Vývojáři čelí výzvám, když pracují se složitými a neznámými nástroji, což vede k zpomalení vývojového procesu a prodloužení doby uvedení na trh.
- Správa velkých objemů dat: Je obtížné pro vývojáře AI získat výpočetní výkon potřebný pro zpracování tohoto velkého množství dat a správu úložiště a zabezpečení.
Zůstávejte v obraze s nejnovějšími technologickými trendy a vývojovými směry v oblasti AI s Unite.ai.



