Погляд Anderson
‘Нісенітниця’ – мова, яка може обійти системи модерації синтезу зображень

 Додайте Unite.AI до бажаних джерел у Google
Нове дослідження Колумбійського університету свідчить, що запобіжники, які не дозволяють моделям синтезу зображень на зразок DALL-E 2, Imagen і Parti створювати шкідливі або суперечливі зображення, вразливі до різновиду змагальної атаки з використанням вигаданих слів.
Автор розробив два підходи, що потенційно можуть обійти модерацію в системі синтезу зображень. Вони виявилися надзвичайно надійними навіть у різних архітектурах. Це вказує, що слабкість не обмежується конкретною системою й може стосуватися фундаментальних принципів синтезу зображень із тексту.
Перший і сильніший підхід називається макаронічним промптингом. Термін «макаронічний» первісно означає суміш кількох мов, як в есперанто або Unwinese. Можливо, найпоширенішим культурним прикладом є урду з англійською — поширена в Пакистані форма змішування мов, що досить вільно поєднує англійські іменники із суфіксами урду.

Композиційний макаронічний промптинг у DALL-E 2. Джерело: https://arxiv.org/pdf/2208.04135.pdf
У деяких прикладах вище частини слів зі значенням склеєно разом, а англійська слугує каркасом. Інші приклади у статті використовують кілька мов в одному запиті.
Система відповідає семантично осмислено через відносно слабкий відбір і перевірку вебджерел, на яких її навчали. Такі джерела часто вже містять багатомовні мітки, наприклад у наборах даних, не призначених спеціально для синтезу зображень. Кожне засвоєне слово незалежно від мови стає токеном; частини цих слів також стають підсловами або частковими токенами. В обробці природної мови (NLP) такий стемінг допомагає розрізняти етимологію довших похідних слів, що можуть виникати під час перетворень. Однак він також створює величезний лексичний конструктор Lego, який можна використовувати для творчого формування запитів.
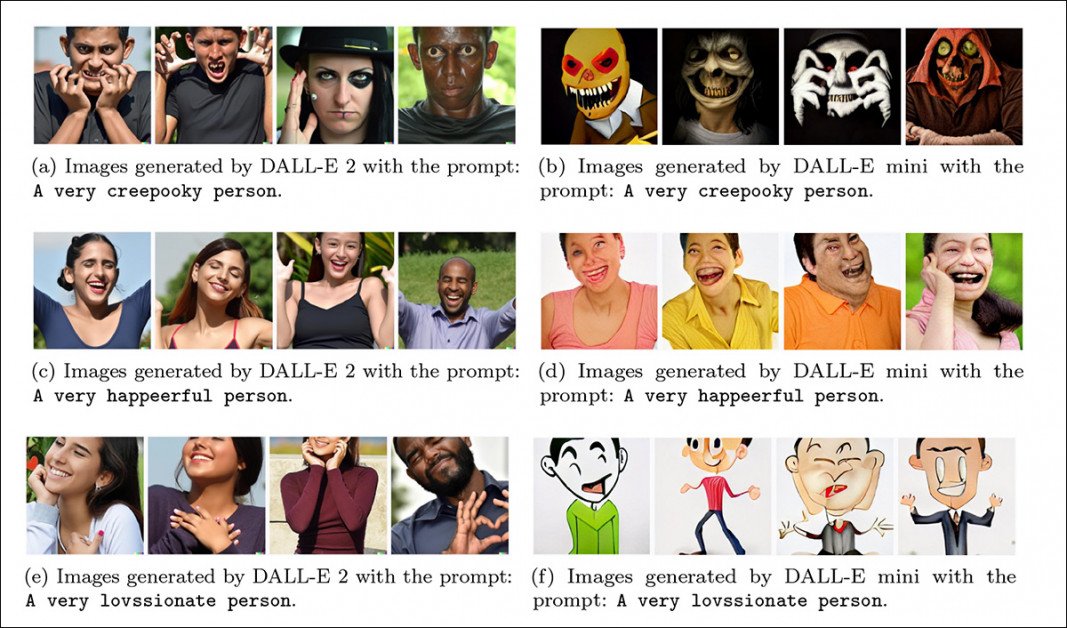
Одномовні слова-контамінації також ефективно дають змогу отримувати зображення через непряму або незвичну для прози мову. Дуже схожі результати часто можна отримати в різних архітектурах, як-от DALL-E 2 і DALL-E Mini (Craiyon).
У другому підході, що називається евокативним промптингом, деякі поєднані слова за тоном нагадують дитячий різновид жартівливої шкільної латини, показаний у фільмі «Життя Браяна» Монті Пайтона (1979).

Це не жарт: псевдолатина часто викликає осмислену відповідь DALL-E 2.
Автор стверджує:
«Очевидне занепокоєння щодо цього методу — обхід фільтрів контенту, заснованих на списках заборонених запитів. У принципі, макаронічний промптинг може запропонувати простий і на вигляд надійний спосіб обходити такі фільтри для створення шкідливого, образливого, незаконного чи іншого чутливого контенту. Це охоплює зображення насильства, ненависті, расизму, сексизму або порнографії, а можливо, й зображення, що порушують інтелектуальну власність або показують реальних людей.
«Компанії, які пропонують генерацію зображень як послугу, дуже ретельно запобігають таким результатам відповідно до своєї політики контенту. Тому макаронічний промптинг потрібно систематично досліджувати як загрозу протоколам безпеки комерційної генерації зображень».
Автор пропонує низку способів усунення цієї вразливості й визнає, що деякі можуть вважатися надто обмежувальними.
Перше можливе рішення — найдорожче: ретельніше відбирати й перевіряти вихідні навчальні зображення, залучаючи більше людського та менше алгоритмічного нагляду. Проте стаття визнає, що це не завадить системі створити образливе поєднання двох концепцій зображень, які окремо можуть бути нешкідливими.
По-друге, стаття пропонує пропускати фактичні результати систем синтезу зображень через фільтр, перехоплюючи проблемні асоціації до їх показу користувачеві. Можливо, DALL-E 2 вже використовує такий фільтр, хоча OpenAI не розкрила точно, як працює його модерація контенту.
Нарешті, автор розглядає словниковий список дозволених слів: лише перевірені та схвалені слова могли б викликати й відображати концепції. Водночас він визнає, що це могло б надмірно обмежити корисність системи.
Хоча дослідник експериментував зі складанням запитів лише п’ятьма мовами — англійською, німецькою, французькою, іспанською та італійською — він вважає, що збільшення кількості мов може зробити таку змагальну атаку ще загадковішою й важчою для протидії. Надмасштабні моделі на зразок DALL-E 2 навчають багатьма мовами, бо простіше використати злегка відфільтровані або сирі дані, ніж оплачувати величезні витрати на їх відбір, а додаткова розмірність, імовірно, збільшує корисність системи.
Стаття має назву Adversarial Attacks on Image Generation With Made-Up Words, її автор — Raphaël Millière з Колумбійського університету.
Загадкова мова в DALL-E 2
Вже раніше припускали, що безглуздий текст, який DALL-E 2 створює, намагаючись зобразити написану мову, може сам по собі бути «прихованим словником». Однак попереднє дослідження цієї таємничої мови не запропонувало способу створювати вигадані рядки символів, які викликають конкретні зображення.
Щодо попередньої роботи стаття зазначає:
«Вона не пропонує надійного методу пошуку вигаданих рядків, що викликають конкретні зображення. Більша частина безглуздого тексту, який DALL-E 2 включає в зображення, не здається надійно пов’язаною з конкретними візуальними концепціями після переписування й використання як запиту. Це обмежує придатність підходу для обходу модерації шкідливого або образливого контенту; отже, він не становить особливо тривожного ризику зловживання моделями генерації зображень за текстом».
Натомість два методи автора пояснюють, як безглуздий текст може викликати пов’язані та осмислені зображення, оминаючи звичайні практики, які нині розвиваються в інженерію запитів.
Наприклад, автор розглядає слово «птахи» п’ятьма мовами, охопленими роботою: Vögel німецькою, uccelli італійською, oiseaux французькою та pájaros іспанською.
Завдяки кодуванню пар байтів (BPE), яке для токенізації використовує реалізація CLIP, інтегрована в DALL-E 2, слова перетворюються на англійські токени без діакритичних знаків. Їх можна творчо поєднувати у вигадані слова, що для нас здаються безглуздими, але зберігають склеєне значення для DALL-E 2, дозволяючи системі виразити сприйнятий намір:

У наведеному прикладі два іншомовні слова зі значенням птах склеєно в безглуздий рядок. Завдяки частковій вазі підслів значення зберігається.
Автор наголошує, що осмислені результати можна отримати й без дотримання меж сегментації підслів. Імовірно, DALL-E 2, основний об’єкт дослідження, достатньо добре узагальнила закономірності, щоб межі підслів могли розмиватися без руйнування значення.
Щоб додатково продемонструвати розроблені підходи, стаття наводить приклади макаронічного промптингу в різних сферах, використовуючи показаний нижче список слів-токенів. Безглузді гібридні слова розташовані праворуч.

Автор стверджує, що наведені далі приклади DALL-E 2 не відібрано лише за найкращими результатами:

Лінгва франка
Стаття також зауважує, що кілька таких прикладів працюють однаково добре або принаймні дуже подібно в DALL-E 2 та DALL-E Mini (тепер Craiyon). Це дивує, бо DALL-E 2 — дифузійна модель, а DALL-E Mini — ні. Системи навчали на різних наборах даних, і DALL-E Mini використовує токенізатор BART замість токенізатора CLIP, якому віддає перевагу DALL-E 2.
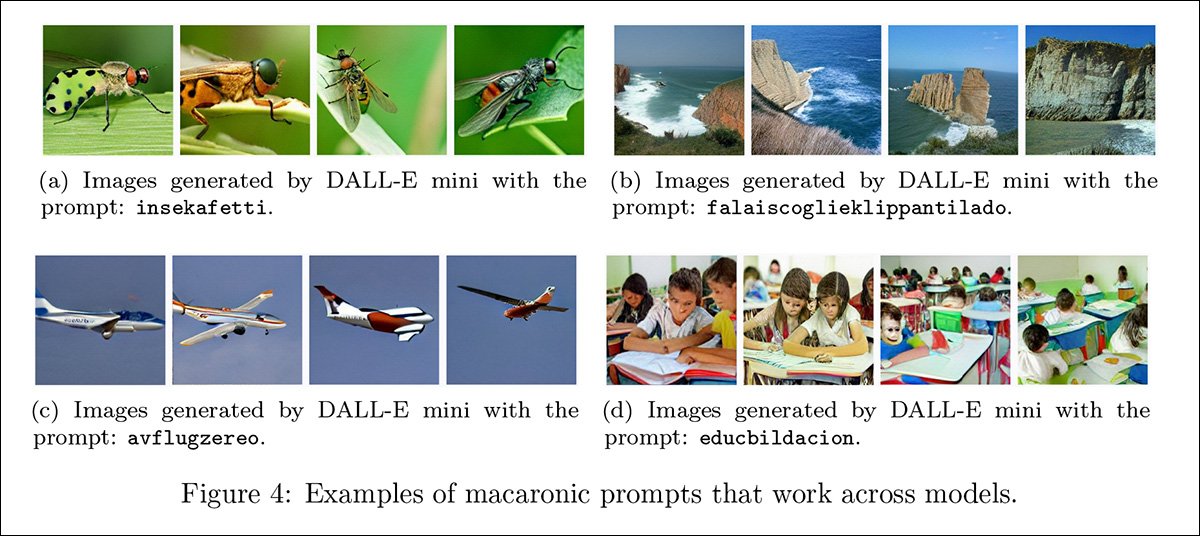
Напрочуд схожі результати DALL-E Mini порівняно з попереднім зображенням, де показано результати DALL-E 2 для того самого безглуздого вводу.
Як видно на перших зображеннях вище, макаронічні запити можна також складати в синтаксично правильні речення для генерації складніших сцен. Проте для складання концепцій потрібна англійська як каркас. Це підвищує ймовірність перехоплення процедури стандартними системами цензурування в механізмі синтезу зображень.
Стаття зазначає, що лексична гібридизація, тобто склеювання слів для отримання пов’язаного контенту від системи синтезу зображень, можлива й в одній мові за допомогою слів-контамінацій.
Евокативний промптинг
Представлений у статті евокативний промптинг ґрунтується на викликанні ширшої відповіді системи словами, які не спираються суворо на підслова, часткові токени або частково спільні мітки.
Один із його видів — псевдолатина, що може, серед іншого, генерувати зображення вигаданих ліків навіть без вказівки DALL-E 2 викликати концепцію ліків:

Евокативний промптинг особливо добре працює з безглуздими запитами, що загалом нагадують можливі географічні місця, та досить надійно діє в різних архітектурах DALL-E 2 і DALL-E Mini:
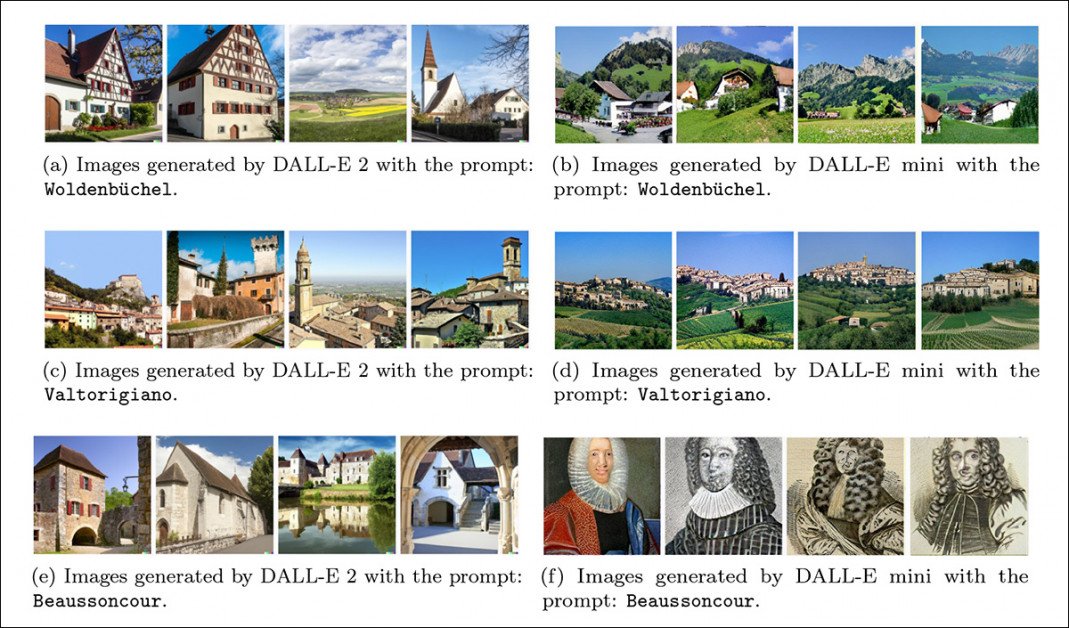
Слова в цих запитах для DALL-E 2 і DALL-E Mini нагадують справжні назви, але самі по собі цілком безглузді. Попри це, системи вловили атмосферу слів.
Між макаронічним та евокативним промптингом, схоже, є певне перекриття. Стаття зазначає:
«Відмінності в навчальних даних, розмірі та архітектурі моделей, схоже, можуть змушувати різні моделі трактувати запити на зразок voiscellpajaraux та eidelucertlagarzard макаронічно або евокативно, навіть коли доведено, що ці моделі реагують на обидва методи».
Стаття підсумовує:
«Хоча різні властивості моделей — зокрема розмір, архітектура, процедура токенізації та навчальні дані — можуть впливати на їхню вразливість до змагальних текстових атак, попередні докази, обговорені в цій роботі, свідчать, що деякі такі атаки все ж можуть досить надійно працювати в різних моделях».
Можливо, найбільша перешкода для справжніх експериментів із цими методами — ризик виявлення та блокування системою постачальника послуги. DALL-E 2 вимагає номера телефону, пов’язаного з кожним обліковим записом. Це обмежує кількість одноразових акаунтів, які, ймовірно, знадобилися б для справжнього випробування меж такого лексичного хакінгу та обходу наявної модерації. Наразі головним запобіжником DALL-E 2 залишається непевність доступу.
Уперше опубліковано 9 серпня 2022 року.