
Моделі та платформи ШІ
Мультимодальний ШІ розвивається: ChatGPT отримує здатність бачити завдяки GPT-4 Vision

 Додайте Unite.AI до бажаних джерел у Google

Ключові моментиOpenAI GPT-4V додає аналіз зображень до ChatGPT, розширюючи можливості ШІ за межі…
Показати більше
- OpenAI GPT-4V додає аналіз зображень до ChatGPT, розширюючи можливості ШІ за межі тексту.
- GPT-4V демонструє потенціал у технічних завданнях, але має критичні недоліки в медичному застосуванні.
- Мультимодальні моделі на кшталт Med-PaLM M просувають спеціалізовані сфери, такі як охорона здоров'я.
Прагнучи наблизити штучний інтелект до людських здібностей, OpenAI постійно розширює можливості моделей GPT. GPT-4 тепер може приймати запити, що містять як текст, так і зображення.
Мультимодальність у генеративному ШІ означає здатність моделі працювати з різними видами даних і створювати текст, зображення чи аудіо залежно від вхідних даних. Навчаючись на певних наборах даних, такі моделі засвоюють закономірності й генерують нові подібні матеріали, розширюючи застосування ШІ.
Останні досягнення мультимодального ШІ
Помітним кроком стала інтеграція DALL-E 3 у ChatGPT — значне оновлення технології OpenAI для створення зображень за текстом. ChatGPT допомагає формулювати точні запити для DALL-E 3, перетворюючи задуми користувачів на зображення. Хоча з DALL-E 3 можна взаємодіяти безпосередньо, участь ChatGPT робить цей процес зручнішим.
Докладніше про DALL-E 3 та інтеграцію з ChatGPT можна прочитати тут. Поєднання цих інструментів демонструє розвиток мультимодального ШІ й полегшує створення зображень.

Google Health у червні 2023 року представила Med-PaLM M — мультимодальну генеративну модель, яка кодує й інтерпретує різні біомедичні дані. Для цього PaLM-E донавчили на медичних завданнях із використанням відкритого бенчмарку MultiMedBench. Він містить понад мільйон прикладів семи типів біомедичних даних і 14 завдань, зокрема відповіді на медичні запитання та створення радіологічних звітів.
Різні галузі впроваджують мультимодальні інструменти ШІ, щоб розвивати бізнес, оптимізувати операції та покращувати взаємодію з клієнтами. Розвиток голосових, відео- й текстових можливостей стимулює цей напрям. Компанії шукають застосування, здатні змінити бізнес-моделі та процеси, відкриваючи можливості для всієї екосистеми генеративного ШІ — від інструментів роботи з даними до нових застосунків.
Після випуску GPT-4 у березні деякі користувачі помітили погіршення відповідей; про це також говорили розробники й учасники форумів OpenAI. Після початкового заперечення цих побоювань у статті наведено дослідження, яке повідомляло про зниження точності GPT-4 з 97,6% до 2,4% між березнем і червнем у досліджуваному завданні. Ці числа стосуються конкретного оцінювання, а не загальної точності всіх відповідей моделі.

Інтерес до ChatGPT від OpenAI знову зріс завдяки функції зору GPT-4V, яка дозволяє аналізувати надані користувачами зображення. На момент написання статті це була нова можливість, відкрита користувачам.
Додавання аналізу зображень до великих мовних моделей на кшталт GPT-4 вважають важливим кроком у дослідженнях ШІ. Мультимодальні LLM виходять за межі тексту, створюють нові інтерфейси та дозволяють розв’язувати нові типи завдань.
Навчання GPT-4V завершили у 2022 році, а ранній доступ надали в березні 2023 року. Візуальні можливості спираються на технологію GPT-4. Спочатку модель навчали передбачати наступне слово на великому наборі текстів і зображень із різних джерел, зокрема інтернету. Потім її донавчали на додаткових даних із використанням навчання з підкріпленням на основі людського зворотного зв’язку (RLHF), щоб отримувати відповіді, яким люди надають перевагу.
Механізми GPT-4 Vision
Попри вражаючі візуально-мовні можливості GPT-4, подробиці її внутрішніх механізмів залишаються обмеженими. Для дослідження подібних можливостей представили MiniGPT-4, яка використовує потужну мовну модель Vicuna. Це окрема модель, а не розкриття архітектури GPT-4.
MiniGPT-4 використовує попередньо навчені компоненти візуального енкодера та узгоджує отримані візуальні ознаки з Vicuna через один проєкційний шар. Проста, але ефективна архітектура зосереджена на узгодженні зорової та мовної інформації для покращення діалогу про зображення.
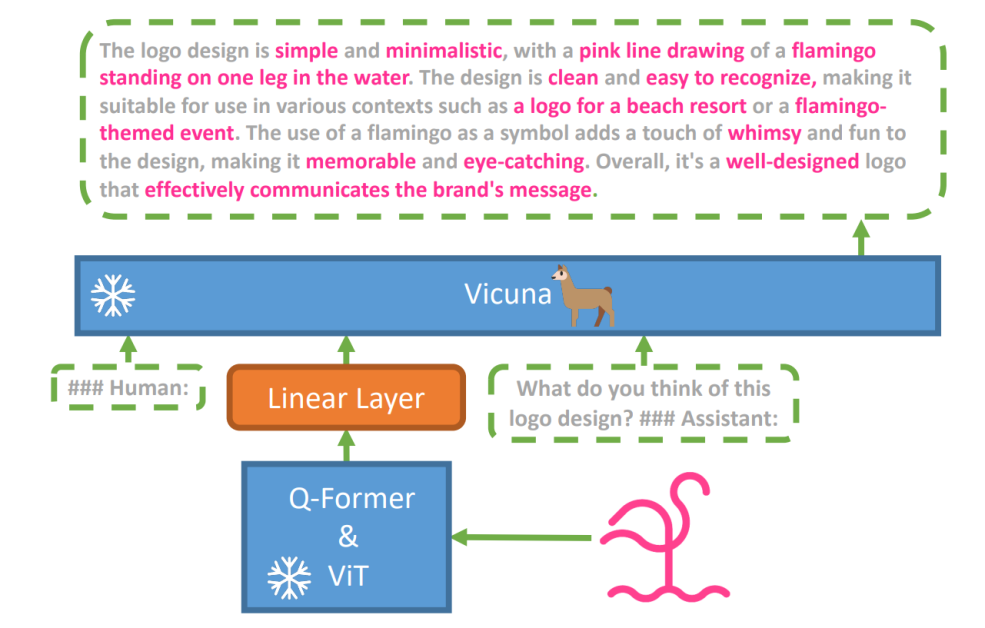
Авторегресійні мовні моделі дедалі частіше використовують у візуально-мовних завданнях. Перенесення знань між модальностями дає змогу поєднувати мовні й мультимодальні можливості.
MiniGPT-4 поєднує візуальну інформацію попередньо навченого енкодера з LLM, використовуючи Vicuna як мовний декодер. Навчання відбувається у два етапи: спочатку на великому наборі пар «зображення — текст» модель засвоює зв’язки між модальностями, а потім на меншому високоякісному наборі підвищує надійність і практичну придатність генерації.
Щоб зробити мову природнішою та кориснішою за нестачі відповідних даних для узгодження модальностей, дослідники створили спеціальний набір даних. Спочатку модель генерувала докладні описи зображень за діалоговим запитом у форматі Vicuna, який заохочував наводити якомога більше деталей.
Початковий запит для опису зображення:
###Human: <Img><ImageFeature></Img>Describe this image in detail. Give as many details as possible. Say everything you see. ###Assistant:
Під час подальшої обробки неузгодженості та помилки в описах виправляли за допомогою ChatGPT, а потім перевіряли вручну, забезпечуючи високу якість даних.
Шаблон запиту для другого етапу донавчання:
###Human: <Img><ImageFeature></Img><Instruction>###Assistant:
Це дослідження допомагає зрозуміти, як у мультимодальному генеративному ШІ можна поєднати зорову й мовну інформацію для створення зв’язних відповідей, що враховують контекст.
Досліджуємо GPT-4 Vision
Визначення місця зйомки
GPT-4 Vision розширює можливості ChatGPT аналізувати зображення та визначати їхнє географічне походження. Поєднання тексту й візуальної інформації може допомогти тим, хто хоче дізнатися більше про зображені місця.

Складні математичні поняття
GPT-4 Vision може пояснювати складні математичні ідеї, аналізуючи графіки чи рукописні вирази. Це робить її корисним допоміжним інструментом для навчання й розв’язування математичних завдань.

Перетворення рукописного тексту на LaTeX
GPT-4V може перетворювати рукописні записи на код LaTeX. Це корисно дослідникам, викладачам і студентам, яким потрібно оцифровувати математичні вирази та іншу технічну інформацію. Така можливість спрощує підготовку технічних документів.

Вилучення інформації з таблиць
GPT-4V може вилучати дані з таблиць і відповідати на пов’язані запитання. Аналітики та інші фахівці можуть використовувати її для перегляду таблиць, пошуку ключових висновків і з’ясування деталей.

Розуміння візуальних вказівок
GPT-4V може розуміти, на що вказує користувач на зображенні. Візуальні підказки додають контекст і допомагають моделі точніше зрозуміти запитання.

Створення простого макета сайту за малюнком
Надихнувшись цим дописом, я спробував створити макет сайту unite.ai.
Результат не зовсім відповідав моєму початковому задуму, але ось що вдалося отримати.

Обмеження й недоліки GPT-4V
Команда OpenAI провела якісні та кількісні оцінювання GPT-4V. Якісні включали внутрішні випробування та зовнішній експертний аналіз. Кількісні вимірювали відмови моделі й точність у сценаріях розпізнавання шкідливого вмісту, демографічних характеристик, захисту приватності, геолокації, кібербезпеки та мультимодальних спроб обійти обмеження безпеки.
Модель усе ще недосконала. У документі описано неправильні висновки та пропуск тексту чи символів на зображеннях. GPT-4V може вигадувати факти. Зокрема, вона непридатна для надійного визначення небезпечних речовин за зображеннями, оскільки часто помиляється.
Під час аналізу медичних зображень GPT-4V може давати непослідовні відповіді й не враховувати стандартні практики, що створює ризик помилкового діагнозу.

Модель також може не розуміти нюансів деяких символів ненависті та генерувати неприйнятний вміст на основі зображень. OpenAI застерігає від використання GPT-4V для критично важливих інтерпретацій, особливо в медичних або чутливих ситуаціях.
Підсумок

GPT-4 Vision відкриває нові можливості й водночас створює нові виклики. Перед випуском значну увагу приділили вивченню та зменшенню ризиків, особливо пов’язаних із зображеннями людей. Можливості моделі в медицині й науці обнадійливі, але потребують обережного оцінювання.
Залишаються важливі запитання: чи повинні такі моделі впізнавати відомих людей на фото, припускати стать, расову належність чи емоції людини за зображенням? Чи потрібні спеціальні налаштування для людей із порушеннями зору? Ці питання стосуються приватності, справедливості та ролі ШІ в нашому житті, і кожен повинен мати змогу долучитися до обговорення.


