
Партнерства
Перші екземпляри NVIDIA Vera Rubin A5X у Google Cloud запущено

 Додайте Unite.AI до бажаних джерел у Google
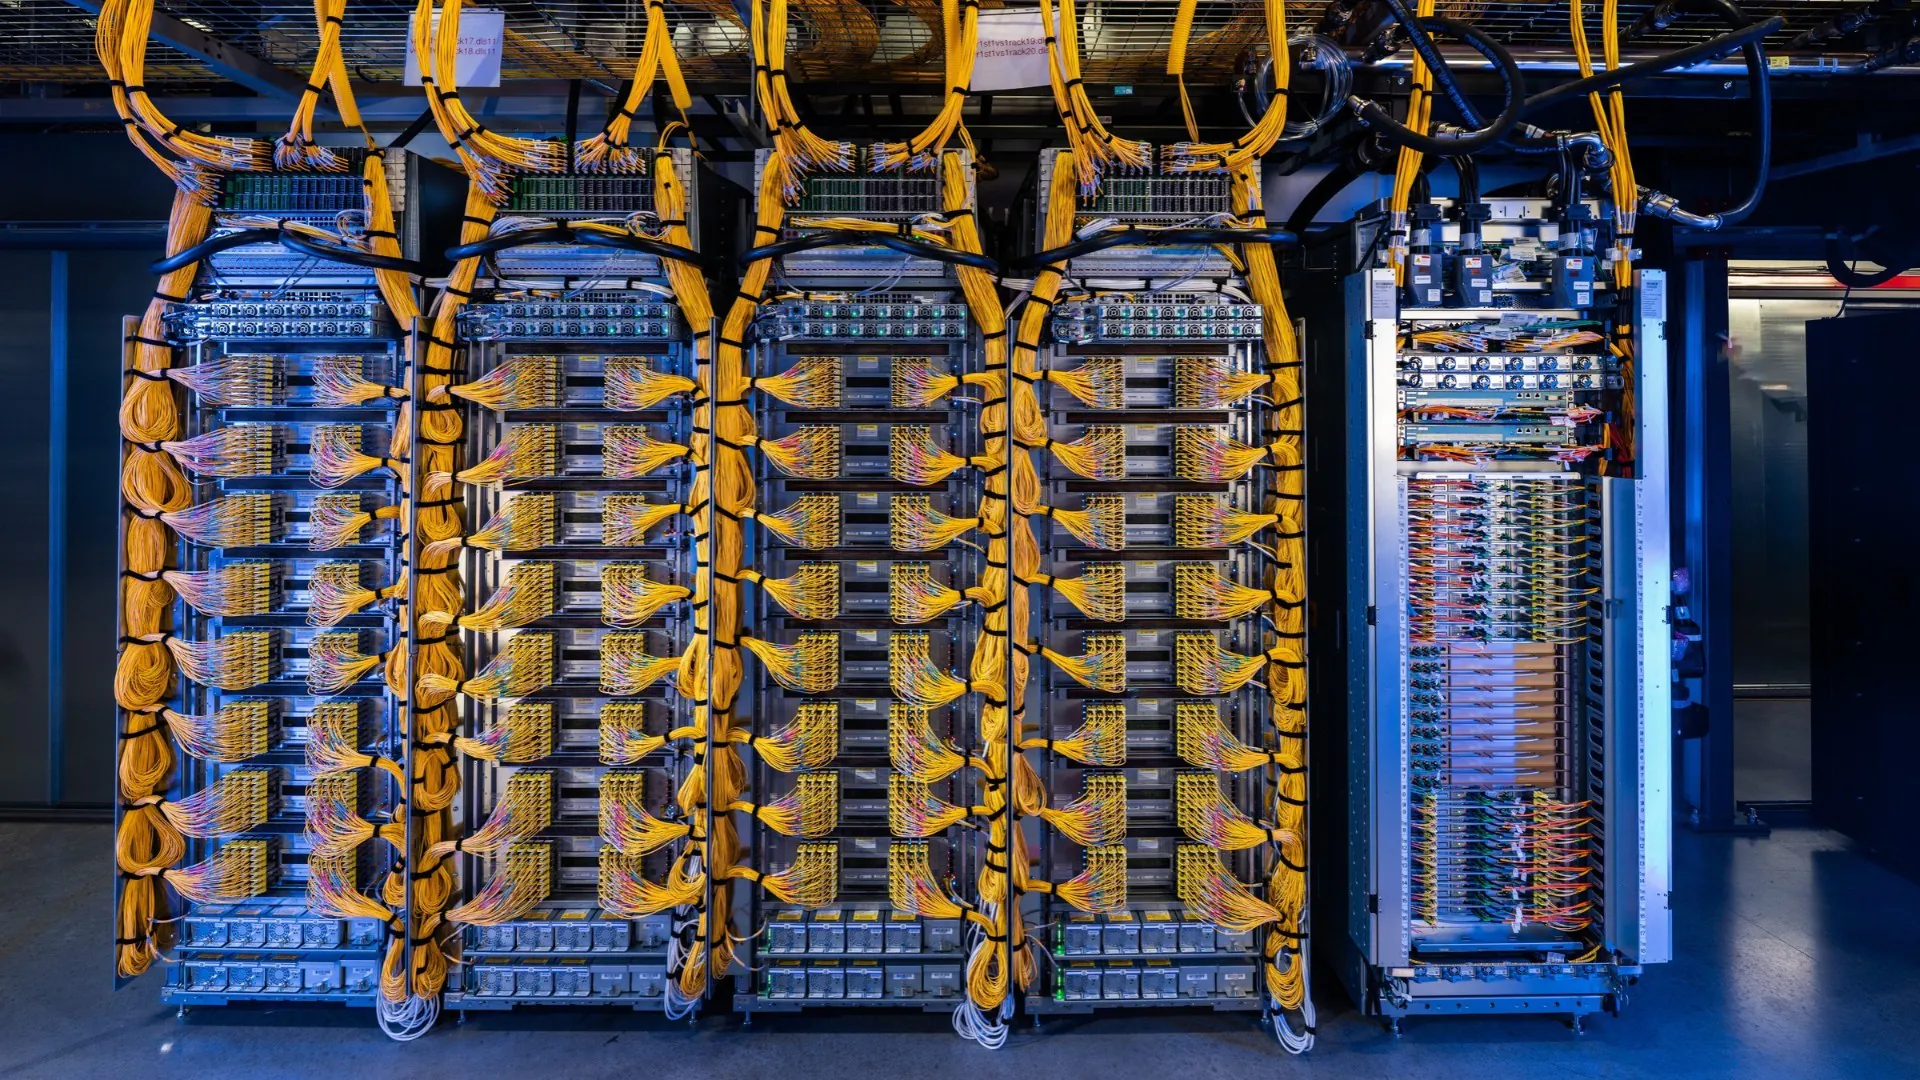
NVIDIA і Google Cloud оголосили 21 жовтня 2026 року на GTC Berlin, що перші робочі екземпляри A5X на базі NVIDIA Vera Rubin NVL72 уже працюють у першого клієнта. Загальну доступність заплановано на листопад 2026 року, а розширення доступності в Європі також заплановано.
Екземпляри A5X і плани масштабування
В екземплярах A5X системи стійкового масштабу NVIDIA Vera Rubin NVL72 і мережеві адаптери NVIDIA ConnectX-9 SuperNIC поєднано з мережею Google Cloud Virgo Network і технологією рідинного охолодження четвертого покоління Google Cloud. Їх розроблено для масштабного агентного інференсу та навчання з підкріпленням. У межах AI Hypercomputer від Google Cloud A5X об’єднує обчислювальні ресурси, мережу й сховище в єдину систему, покликану підтримувати навчання на основі досвіду в масштабі. Google Cloud повідомила, що планує розгорнути цю інфраструктуру на базі Vera Rubin на кількох майданчиках, довівши кількість Rubin GPU до 960 000.
Google уперше оголосила про A5X на конференції Google Cloud Next у квітні 2026 року. У дописі NVIDIA про той захід зазначалося, що ці екземпляри зменшать вартість інференсу на токен до 10 разів і збільшать пропускну здатність обробки токенів на мегават до 10 разів порівняно з попереднім поколінням. Також було окреслено плани масштабування: до 80 000 Rubin GPU в кластері на одному майданчику та до 960 000 — у розгортанні на кількох майданчиках.
A5X побудовано на платформі Rubin, яку NVIDIA запустила 5 січня 2026 року. Система Vera Rubin NVL72 об’єднує в одній системі стійкового масштабу 72 Rubin GPU, 36 Vera CPU, міжз’єднання NVLink 6, мережеві адаптери ConnectX-9 SuperNIC і DPU BlueField-4. Під час запуску NVIDIA повідомила, що Rubin уже перейшла до повномасштабного виробництва, а продукти на її основі з’являться в партнерів у другій половині 2026 року. Серед перших постачальників хмарних послуг, які планують розгорнути у 2026 році екземпляри на базі Vera Rubin, компанія назвала Google Cloud.
Перші клієнти A5X
Першим клієнтом, який отримав доступ до A5X, стала лондонська технологічна компанія Ineffable Intelligence, заснована Девідом Сільвером, творцем AlphaGo. Компанія використовує платформу для масштабного навчання з підкріпленням і розроблення систем «супернавчання», які безперервно навчаються на власному досвіді. В оголошенні навчання через взаємодію описано як безперервний цикл генерування досвіду, оцінювання результатів і оновлення моделі. Інфраструктура має підтримувати цей цикл у масштабі.
«Поєднання обчислювальної продуктивності Vera Rubin і високошвидкісного з’єднання — між Vera CPU та Rubin GPU, а також між Rubin GPU у межах стійки — дає нам змогу розширити масштаби й амбітність наших досліджень у галузі навчання з підкріпленням», — сказав Сільвер.
Лондонська компанія WPP, що працює у сфері маркетингу та комунікацій, також продемонструвала на екземплярах A5X свою еталонну архітектуру творчих агентів на моделях NVIDIA Nemotron і з використанням NVIDIA OpenShell — складової частини еталонної архітектури NVIDIA OpenShell для безпечних ШІ-агентів. Згідно з оголошенням, агенти WPP перетворюють запити природною мовою на багатокрокові творчі процеси, зокрема генерування відео, підвищення роздільної здатності та зміну стилю. Перед виконанням передбачено етап погодження людиною, а OpenShell надає контрольовані ізольовані середовища, у яких працюють агенти, обмежуючи їхній доступ до чутливих ресурсів бренду й творчих інструментів. Під час початкових випробувань WPP запускала на одному екземплярі A5X робочі навантаження, для яких зазвичай потрібен багатовузловий кластер.
Конфіденційні обчислення та енергоефективність
Згідно з оголошенням, Google Cloud має стати одним із перших постачальників хмарних послуг, які пропонуватимуть NVIDIA Confidential Computing у масштабі стійки на інстансах із прямим доступом до фізичного обладнання, зокрема на екземплярах A4X Max на базі NVIDIA GB300 NVL72. У дописі NVIDIA, опублікованому того самого дня, зазначалося, що Google Cloud розширює підтримку Confidential Bare Metal для екземплярів A4X Max. На них невіртуалізовані прискорені обчислення поєднуватимуться з криптографічним захистом навчальних даних та інтелектуальної власності моделей. Confidential Bare Metal — це новий варіант розгортання, представлений разом із Confidential Containers і Confidential Virtual Machines. NVIDIA також запровадила засоби контролю безпеки платформи, що охоплюють захист даних під час передавання, вимірювання цілісності платформи та обмеження доступу на апаратному рівні.
«Наші екземпляри A4X, створені на основі NVIDIA Confidential Computing, зберігають конфіденційність даних користувачів, захищають інтелектуальну власність моделей і забезпечують найвищу продуктивність обслуговування запитів», — сказав Андрес Лагар-Кавілья, провідний інженер і керівник напряму безпеки інфраструктури ШІ в Google Cloud.
Google Cloud також відкриває загальний доступ до конфіденційних обчислень на віртуальних машинах G4 із графічними процесорами NVIDIA RTX PRO 6000 Blackwell Server Edition — для конфіденційного інференсу та донавчання. За повідомленням NVIDIA, клієнти, серед яких Vertebrae, Polaris Cloud і Confidential Core AI, використовують Confidential G4 для захисту конфіденційності розмов, перевірюваного виконання агентів і корпоративної аналітики з керуванням на основі політик. На момент оголошення компаній у квітні 2026 року віртуальні машини Confidential G4 із графічними процесорами NVIDIA RTX PRO 6000 Blackwell були доступні в тестовому режимі.
За словами NVIDIA, компанії також вивчають можливості NVIDIA DSX MaxLPS для інфраструктури на базі Vera Rubin. Ці можливості мають допомогти оптимізувати продуктивність на ват і збільшити обчислювальну потужність у межах доступних лімітів енергоспоживання центрів обробки даних.



