
Погляд Anderson
Виявлення зорового контакту з позою тіла за допомогою машинного навчання

 Додайте Unite.AI до бажаних джерел у Google
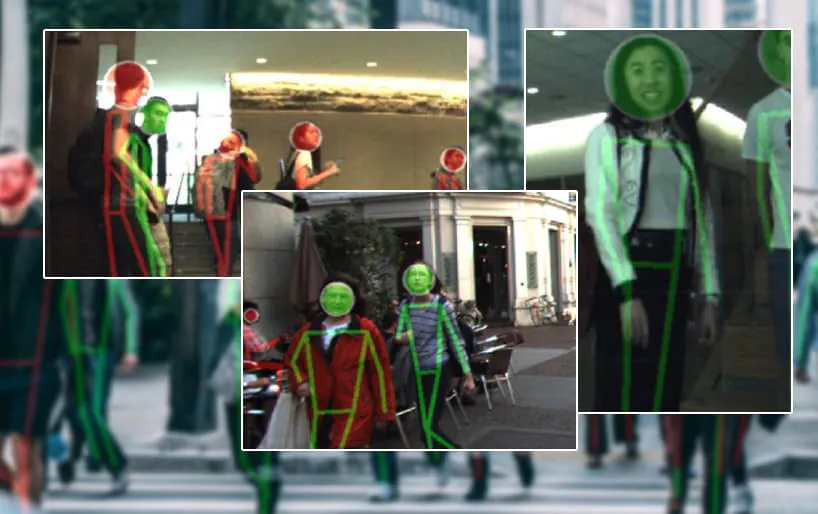
Дослідники з Франції та Швейцарії розробили систему комп’ютерного зору, яка може оцінити, чи дивиться людина прямо в камеру системи штучного інтелекту, ґрунтуючись лише на тому, як людина стоїть або рухається.
Нова структура використовує дуже скорочену інформацію для цього оцінювання, у вигляді семантичних ключових точок (див. зображення нижче), а не намагається в першу чергу аналізувати положення очей на зображеннях облич. Це робить метод виявлення дуже легким і рухливим у порівнянні з більш даними інтенсивними архітектурами виявлення об’єктів, такими як YOLO.

Нова структура оцінює, чи дивиться людина на вулиці в камеру штучного інтелекту, ґрунтуючись лише на положенні її тіла. Тут люди, виділені зеленим, ймовірно, дивляться в камеру, тоді як ті, хто виділені червоним, більш ймовірно дивляться в бік. Джерело: https://arxiv.org/pdf/2112.04212.pdf
Хоча робота мотивована розробкою кращих систем безпеки для автономних транспортних засобів, автори нової статті погоджуються, що вона може мати більш загальні застосування в інших галузях, відзначаючи ‘навіть у розумних містах виявлення зорового контакту може бути корисним для кращого розуміння поведінки пішоходів, наприклад, визначення того, куди вони дивляться або які публічні знаки вони розглядають’.
Щоб допомогти подальшому розвитку цієї та наступних систем, дослідники скомплектували новий і всебічний набір даних під назвою LOOK, який безпосередньо адресує конкретні виклики виявлення зорового контакту в довільних сценаріях, таких як вуличні сцени, сприйняті з камери самохідного транспортного засобу, або випадкові сцени натовпу, через які робот може потребувати навігації та ухилення від шляху пішоходів.

Результати структури, з ‘дивлячими’ ідентифікованими зеленим.
Дослід дослідження називається Чи звертають увагу пішоходи? Виявлення зорового контакту в дикій природі і походять від чотирьох дослідників з ініціативи Visual Intelligence for Transportation (VITA) у Швейцарії та одного з Сорбоннського університету.
Архітектура
Більшість попередньої роботи в цій галузі була зосереджена на увазі водія, використовуючи машинне навчання для аналізу виходу камер, звернених до водія, і спираючись на постійний, фіксований і близький вигляд водія – розкіш, яка вряд ли буде доступна в часто низькорозірених потоках громадських телевізійних камер, де люди можуть бути занадто віддалені для аналізу їхнього зорового положення, і де інші окулювання (такі як сонцезахисні окуляри) також заважають.
Більш центральна для заявленої мети проекту, камери, звернені назовні, в автономних транспортних засобах, не обов’язково будуть у оптимальному сценарії, роблячи ‘низькорівневу’ інформацію про ключові точки ідеальною основою для структури аналізу погляду. Системи автономних транспортних засобів потребують дуже чутливого і блискавично-швидкого способу розуміння, чи побачив пішохід – який може вийти з тротуару на шлях автомобіля – камеру AV. У такій ситуації затримка могла б означати різницю між життям і смертю.
Модульна архітектура, розроблена дослідниками, приймає на вході (зазвичай) повне зображення людини, з якого витягуються 2D-сполучення у базову, скелетну форму.

Архітектура нової французько-швейцарської системи виявлення зорового контакту.
Поза нормалізується для видалення інформації про осі Y, щоб створити ‘плоскую’ репрезентацію пози, яка ставить її в паритет з тисячами відомих поз, вивчених алгоритмом (які також були ‘сплесені’), і їхніми бінарними прапорцями/мітками (тобто 0: Не дивиться або 1: Дивиться).
Поза порівнюється з внутрішніми знаннями алгоритму про те, як добре ця поза відповідає зображенням інших пішоходів, які були ідентифіковані як ‘дивлячись в камеру’ – анотації, зроблені за допомогою спеціальних інструментів для браузера, розроблених авторами для працівників Amazon Mechanical Turk, які брали участь у розробці набору даних LOOK.
Кожне зображення в LOOK піддавалося перевірці чотирма працівниками AMT, і тільки зображення, де три з чотирьох погодилися з результатом, були включені до остаточного збору.
Інформація про обрізання голови, ядро багатьох попередніх робіт, є одним з найменш надійних індикаторів погляду в довільних міських сценаріях і включена як необов’язковий потік даних в архітектурі, де якість зйомки і покриття достатньо підтримують рішення про те, чи дивиться людина в камеру чи ні. У випадку з дуже віддаленими людьми ця інформація не буде корисною.
Дані
Дослідники отримали LOOK з декількох попередніх наборів даних, які за замовчуванням не підходять для цього завдання. Два набори даних, які безпосередньо поділяють мету проекту, – це JAAD і PIE, і кожен має обмеження.
JAAD – це пропозиція 2017 року від Університету Йорка в Торонто, що містить 390 000 позначених прикладів пішоходів, включаючи обмежувальні рамки і анотації поведінки. З них тільки 17 000 позначені як Дивлячись на водія (тобто на камеру еґо). Набір даних містить 346 кліпів з частотою 30 кадрів в секунду, що триває 5-10 секунд відеозапису з камер на борту, записаних в Північній Америці та Європі. JAAD має високу частоту повторень, а загальна кількість унікальних пішоходів становить лише 686.
Більш недавній (2019) PIE, з Університету Йорка в Торонто, схожий на JAAD, оскільки він містить відеозаписи з камер на борту з частотою 30 кадрів в секунду, цього разу отримані з шести годин їзди через центр Торонто, що дає 700 000 позначених пішоходів і 1842 унікальних пішоходів, з яких тільки 180 дивляться в камеру.
Натомість дослідники нової статті скомплектували найпридатniejsі дані з трьох попередніх наборів даних для автономного водіння: KITTI, JRDB і NuScenes, відповідно з Інституту технологій Карлсруе в Німеччині, Стенфордського університету та Університету Монаша в Австралії, і одного разу спін-оффу MIT – Nutonomy.
Ця кураторська робота призвела до різноманітного набору знімків з чотирьох міст – Бостона, Сінгапура, Тюбінгена і Пало-Альто. З близько 8000 позначених пішохідних перспектив автори стверджують, що LOOK є найбільш різноманітним набором даних для виявлення зорового контакту “у дикій природі”.
Навчання та результати
Витягування, навчання і оцінка були проведені на одному NVIDIA GeForce GTX 1080ti з 11 ГБ відеопам’яті, що працює на процесорі Intel Core i7-8700 з частотою 3,20 ГГц.
Автори виявили, що їхній метод не тільки покращує базові лінії SOTA至少 на 5%, але також, що отримані моделі, навчені на JAAD, дуже добре узагальнюються до невідомих даних, сценарію, протестованого шляхом змішування різних наборів даних.
Оскільки проведене тестування було складним і мало передбачати моделі, засновані на обрізанні (хоча ізоляція обличчя і обрізання не є центральними для архітектури нової ініціативи), див. статтю для детальних результатів.

Результати середньої точності (AP) як відсотка і функції висоти обмежувальної рамки в пікселях для тестування по набору даних JAAD, з результатами авторів, виділені жирним шрифтом.
Дослідники опублікували свій код публічно, з набором даних, доступним тут, і вихідним кодом на GitHub.
Автори закінчують зі сподіванням, що їхня робота надихне подальші дослідження в галузі, яку вони описують як ‘важливу, але недооцінену тему’.
JAAD набір даних, з результатами авторів, виділені жирним шрифтом.[/caption] Дослідники випустили свій код публічно, з набором даних, доступним тут, і вихідним кодом на GitHub. Автори закінчують зі сподіванням, що їхня робота надихне подальші дослідження в галузі, яку вони описують як ‘важливу, але недооцінену тему’.


