
Інтерв’ю
Алекс Ретнер, генеральний директор і співзасновник Snorkel AI — серія інтерв’ю

 Додайте Unite.AI до бажаних джерел у Google
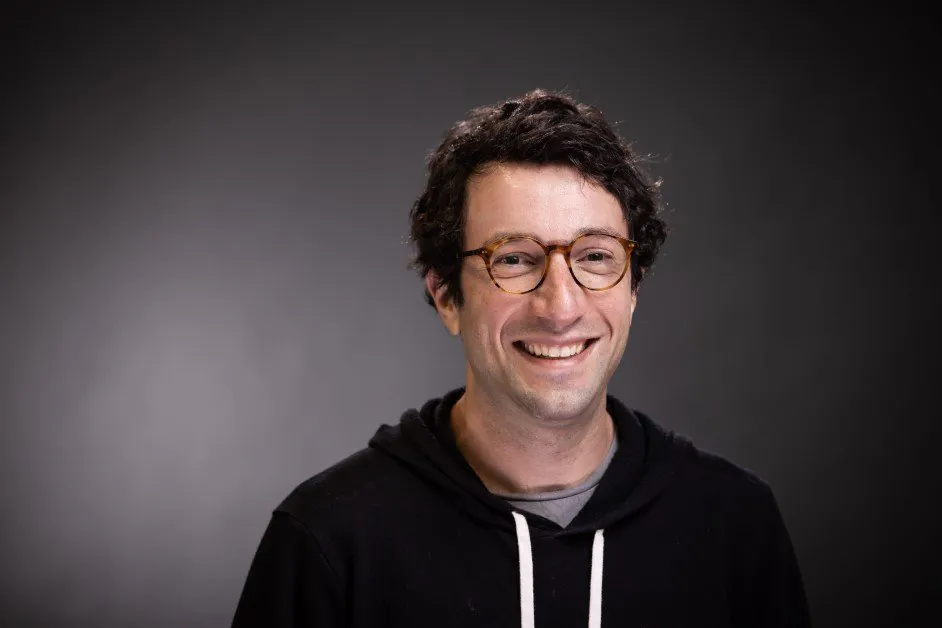
Олекс Ретнер – CEO та співзасновник Snorkel AI, компанії, створеної в Стенфордській лабораторії штучного інтелекту.
Snorkel AI робить розвиток штучного інтелекту швидким і практичним, перетворюючи ручні процеси розвитку штучного інтелекту на програмні рішення. Snorkel AI дозволяє підприємствам розробляти штучний інтелект, який працює для їхніх унікальних робочих навантажень, використовуючи їхні власні дані та знання в 10-100 разів швидше.
Що спочатку привернуло вашу увагу до комп’ютерних наук?
Є дві дуже цікаві сторони комп’ютерних наук, коли ви молоді. По-перше, ви можете вивчати так швидко, як хочете, завдяки експериментам і будівництву, отримуючи миттєвий зворотний зв’язок, а не чекаючи на вчителя. По-друге, ви можете будувати багато без потреби запитувати дозволу в когось!
Я зайнявся програмуванням, коли був молодим хлопчиком, через ці причини. Я також любив точність, яку це вимагало. Мені подобався процес абстрагування складних процесів і процедур, а потім кодування їх у модульний спосіб.
Пізніше, як дорослий, я повернувся до комп’ютерних наук професійно через роботу в консалтинговій компанії, де мені було доручено написати скрипти для проведення базових аналізів патентного корпусу. Мене зацікавило, як багато людських знань – все, що хто-небудь вважав патентним – було легко доступне, але водночас так недоступне, оскільки було дуже складно проводити навіть найпростіші аналізи над складними технічними текстами та мультимодальними даними.
Це повернуло мене на шлях комп’ютерних наук, і врешті-решт повернуло мене до аспірантури в Стенфорді, де я зосередився на NLP, тобто області застосування машинного навчання та штучного інтелекту до природної мови.
Ви вперше створили і очолили проєкт Snorkel під час навчання в Стенфорді. Розкажіть нам про цю ранню історію.
Тоді ми, як і багато хто в галузі, зосередилися на розробці нових алгоритмів і – тобто всього “вишуканих” методів машинного навчання, над яким люди в спільноті проводили дослідження і публікували статті.
Однак ми завжди були дуже прив’язані до ґрунтування цього в реальних проблемах – здебільшого з лікарями і вченими в Стенфорді. Але кожен раз, коли ми пропонували нову модель або алгоритм, відповідь була “так, ми спробуємо це, але нам потрібні всі ці розмічені навчальні дані, яких у нас немає часу створювати!”
Ми бачили, що великою невисловленою проблемою було питання позначення і кураторства цих тренувальних даних – тому ми змінили всю нашу увагу на це, і так розпочався проєкт Snorkel і концепція “даних-орієнтованого штучного інтелекту”.
Snorkel має підхід даних-орієнтованого штучного інтелекту. Як ви визначаєте це і як воно відрізняється від моделі-орієнтованого розвитку штучного інтелекту?
Даних-орієнтований штучний інтелект означає зосередження на побудові кращих даних для побудови кращих моделей.
Це протиставляється, але працює в тандемі з моделі-орієнтованим штучним інтелектом. У моделі-орієнтованому штучному інтелекті дані-науковці або дослідники припускають, що дані є статичними, і вкладають свою енергію в регулювання архітектури моделей і параметрів для досягнення кращих результатів.
Дослідники все ще проводять велику роботу в моделі-орієнтованому штучному інтелекті, але готові моделі і техніки автоматичного машинного навчання покращились так сильно, що вибір моделі став комодитизованим під час виробництва. Коли це відбувається, найкращим способом поліпшення цих моделей є забезпечення їх кращими даними.
Які основні принципи даних-орієнтованого підходу?
Основний принцип даних-орієнтованого штучного інтелекту простий: кращі дані будують кращі моделі.
У наших академічних роботах ми назвали це “програмуванням даних”. Ідея полягає в тому, що якщо ви подасте достатньо надійній моделі достатню кількість прикладів входів та очікуваних виходів, модель вчиться дублювати ці закономірності.
Це представляє більшу складність, ніж ви можете очікувати. Більшість даних не мають позначень – або, принаймні, немає корисних позначень для вашого застосування. Позначення цих даних вручну вимагає монотонності, часу і людських зусиль.
Наявність розміченого набору даних також не гарантує якості. Людська помилка проникає всюди. Кожен неправильний приклад у вашій еталонній розмітці погіршить продуктивність кінцевої моделі. Жодне налаштування параметрів не може приховати цю проблему. Дослідники навіть знайшли неправильно позначені записи в основних відкритих наборах даних.
Розкажіть про те, що означає програмний підхід для даних-орієнтованого штучного інтелекту.
Ручне позначення даних представляє серйозні складності. Воно вимагає багато людських годин, і іноді ці людські години можуть бути дорогими. Медичні документи, наприклад, можуть бути позначені тільки лікарями.
Крім того, ручне позначення часто являє собою одноразові проєкти. Позначники анотують дані згідно з жорсткою схемою. Якщо бізнесові потреби змінюються і вимагають іншого набору позначень, позначники повинні почати спочатку.
Програмні підходи до даних-орієнтованого штучного інтелекту мінімізують обидві ці проблеми. Програмна система позначення Snorkel AI включає різноманітні сигнали – від моделей-легасі до існуючих позначень до зовнішніх баз знань – для розробки ймовірнісних позначень у масштабі. Наш основний сигнал надходить від фахівців у галузі, які співпрацюють з фахівцями з науки про дані для побудови функцій позначення. Ці функції кодують їхню експертну оцінку у масштабовані правила, дозволяючи зусиллям, вкладеним у одне рішення, вплинути на десятки або сотні пунктів даних.
Ця структура також гнучка. Замість початку з нуля, коли бізнесові потреби змінюються, користувачі додають, видаляють і регулюють функції позначення, щоб застосовувати нові позначення за години, а не дні.
Як цей даних-орієнтований підхід дозволяє швидко масштабувати непозначені дані?
Наш програмний підхід до даних-орієнтованого штучного інтелекту дозволяє швидко масштабувати непозначені дані, посилюючи вплив кожного рішення. Як тільки фахівці у галузі встановили початковий, малий набір еталонної розмітки, вони починають співпрацювати з фахівцями з науки про дані для швидкої ітерації. Вони визначають кілька функцій позначення, тренують швидку модель, аналізують вплив своїх функцій позначення, а потім додають, видаляють або регулюють функції позначення за потребою.
Кожен цикл покращує продуктивність моделі, поки вона не відповідає або не перевищує цілей проєкту. Це може скоротити місяці робіт з позначення даних до кількох годин. У одному з дослідницьких проєктів Snorkel двоє наших дослідників позначили 20 000 документів за один день – обсяг, який міг би зайняти ручних позначників десять тижнів або довше.
Snorkel пропонує кілька рішень штучного інтелекту, включаючи Snorkel Flow, Snorkel GenGlow і Snorkel Foundry. Які відмінності між цими пропозиціями?
Набір інструментів Snorkel AI дозволяє користувачам створювати функції позначення (наприклад, пошук ключових слів або закономірностей у документах) для програмного позначення мільйонів пунктів даних за хвилини, а не ручного позначення одного пункту даних за раз.
Він стискає час, необхідний компаніям для перетворення власних даних у виробничі моделі і початку отримання цінності з них. Snorkel AI дозволяє підприємствам масштабувати підходи “людина в циклі” шляхом ефективного включення людської оцінки та знань фахівців у галузі.
Це призводить до більш прозорого і пояснюваного штучного інтелекту, що дозволяє підприємствам керувати упередженнями і забезпечувати відповідальні результати.
Заглибляючись у деталі, рішення Snorkel AI дозволяють підприємствам Fortune 500:
- Розробляти високоякісні позначені дані для тренування моделей або покращення RAG;
- Налаштовувати великі мовні моделі за допомогою тонкого налаштування;
- Дистилювати великі мовні моделі у спеціалізовані моделі, які значно менші і дешевші у використанні;
- Будувати доменні і завдання-специфічні великі мовні моделі з попереднім тренуванням.
Ви написали деякі революційні статті, на вашу думку, яка з них найважливіша?
Одна з ключових статей була оригінальною статтею про програмування даних (позначення тренувальних даних програмно) і про Snorkel.
Яке ваше бачення майбутнього Snorkel?
Я бачу Snorkel як довіреного партнера для всіх великих підприємств, які серйозно ставляться до штучного інтелекту.
Snorkel Flow повинен стати універсальним інструментом для команд фахівців із науки про дані у великих підприємствах – незалежно від того, чи вони налаштовують спеціальні великі мовні моделі для своїх підприємств, чи будують моделі класифікації зображень, чи будують прості, розгортані логістичні регресійні моделі.
Незалежно від того, які моделі потрібні бізнесу, їм будуть потрібні високоякісні позначені дані для тренування.
Дякуємо за чудове інтерв’ю, читачам, які бажають дізнатися більше, слід відвідати Snorkel AI,



