Yapay zeka temelleri
K-Means Kümeleme Nedir?

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
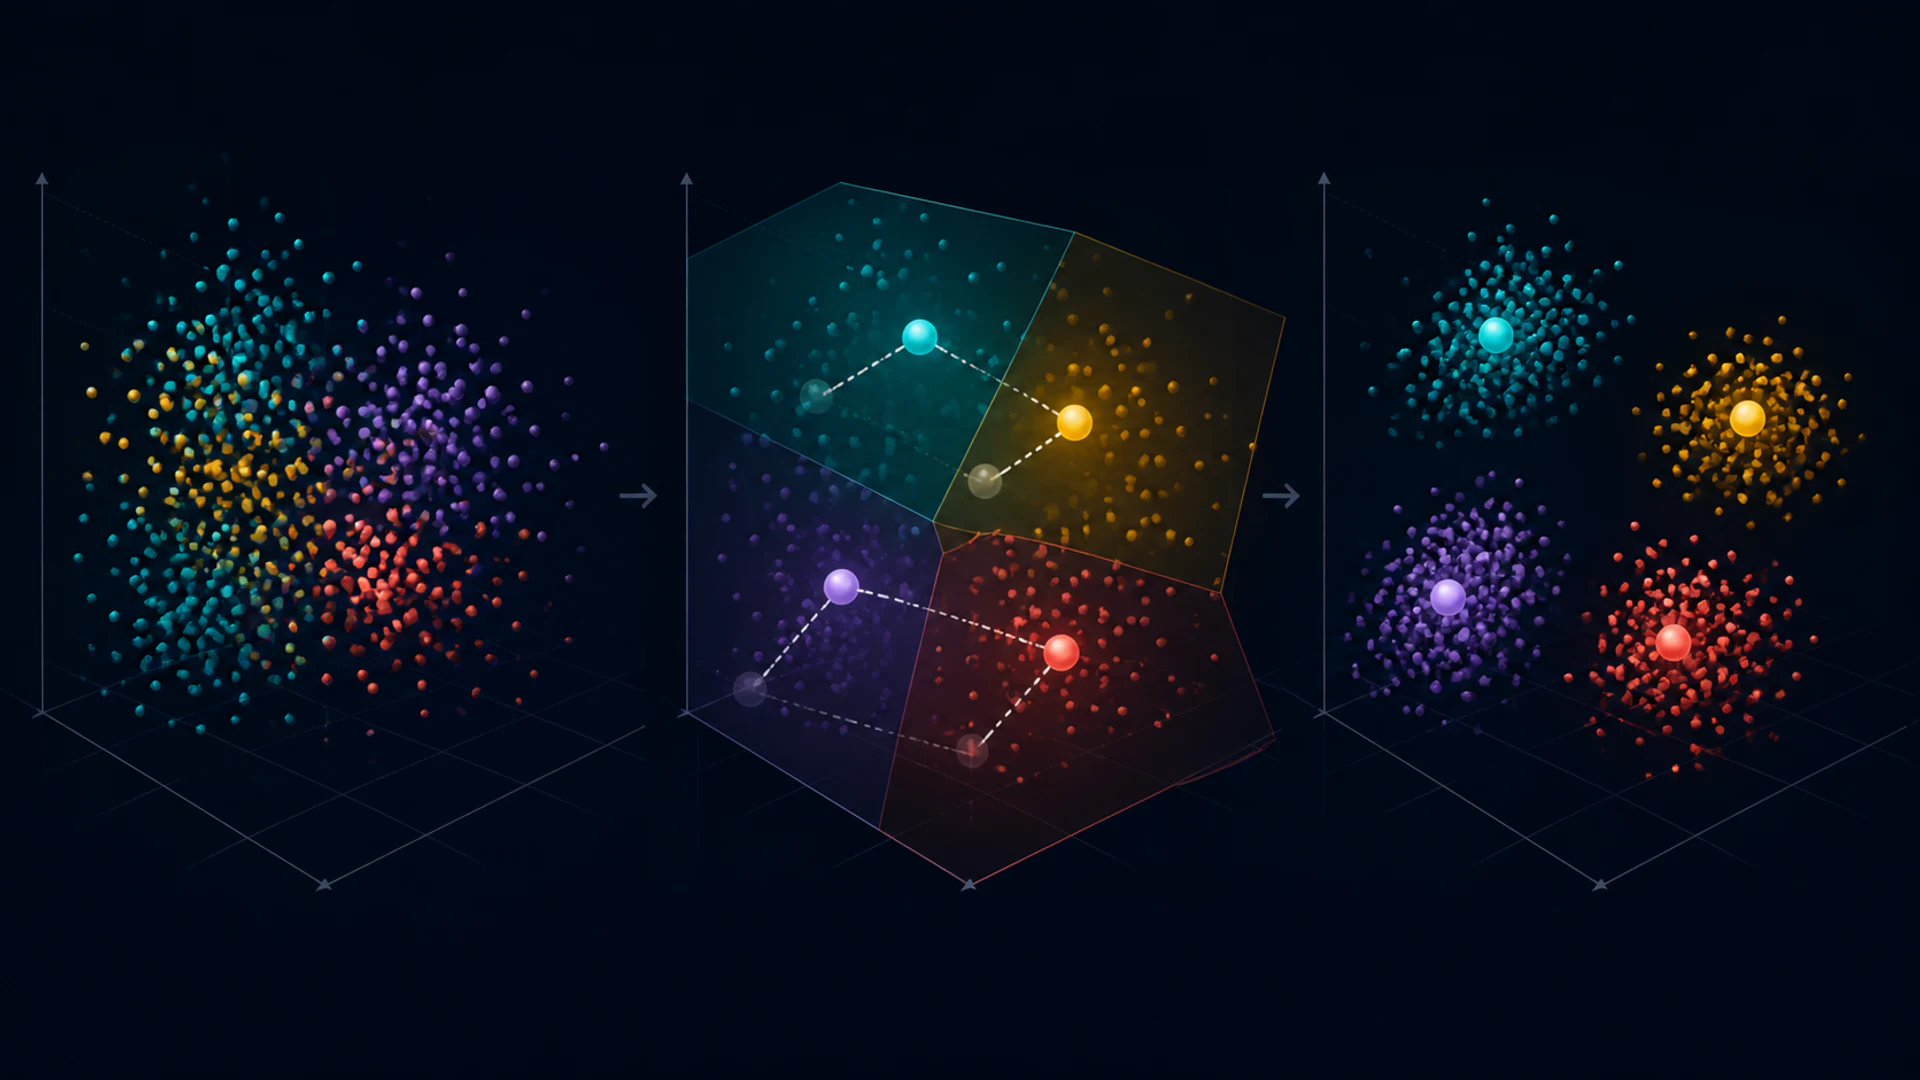
K-means sayısal gözlemleri k kümeye ayıran denetimsiz bir algoritmadır. Her bir noktayı en yakın merkezine atama ve her merkeziyi, ona atanan noktaların ortalaması olarak yeniden hesaplama arasında geçiş yapar.
Algoritma hızlı ve kullanışlıdır, ancak sonucu ölçekleme, mesafe, başlangıç ve seçilen k değerine bağlıdır. Bir küme matematiksel bir bölünmedir, otomatik olarak gerçek dünya kategorisi anlamına gelmez.
Temel Çıkarımlar
- K-means, küme içi kare Euclidean mesafesini merkezlere minimize eder.
- Başlangıç önemlidir; k-means++ başlangıç merkezlerini yayar ve genellikle sonuçları iyileştirir.
- Özelliklerin birimleri veya ölçekleri eşit katkı sağlamalıysa standartlaştırın.
- K-means, aykırı değerler, küresel olmayan kümeler, eşit olmayan yoğunluklar ve kategorik verilerle zorlanır.
Amaç ve Güncelleme Döngüsü
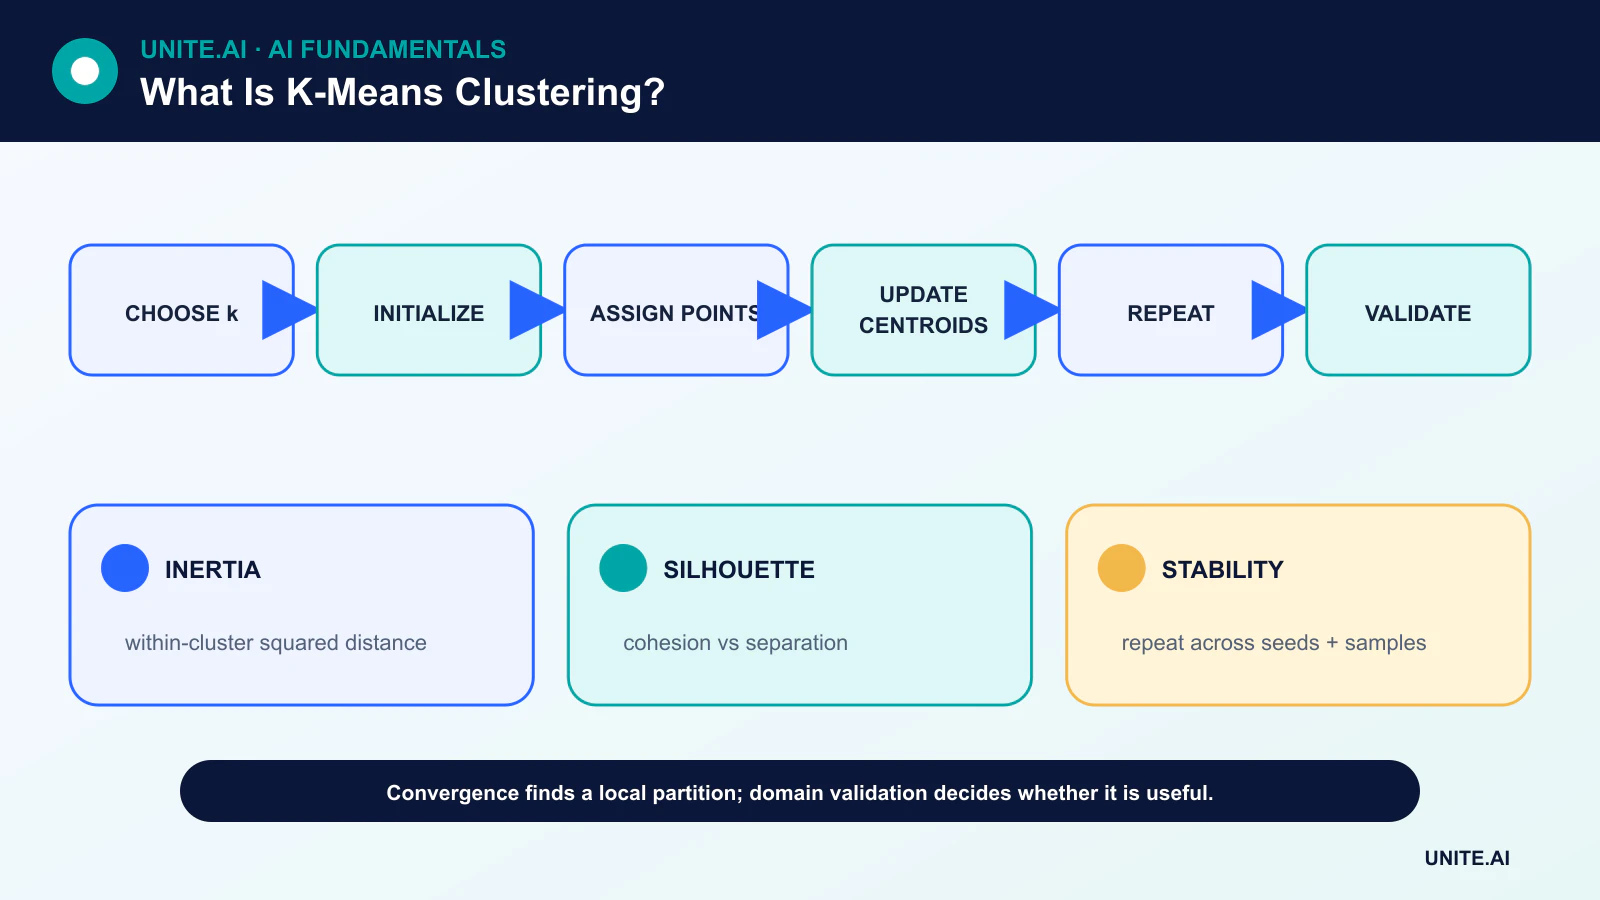
k merkez verildiğinde, atama adımı her gözlemi en yakın merkeze gönderir. Güncelleme adımı ise her merkezi, ona atanan gözlemlerin ortalamasıyla değiştirir. Bu adımlar altında küme içi kareler toplamı artamaz, bu yüzden süreç yerel bir optimuma yakınsar.
Yakınsama küresel optimumu garanti etmez. Farklı başlangıç merkezleri farklı bölünmelere yol açabilir; bu yüzden uygulamalar birden fazla başlangıç çalıştırır ve en düşük ataletli çözümü tutar.
Başlatma ve k-means++
Tüm başlangıç merkezlerini tek bir yoğun bölgeden rastgele seçmek kötü bir çözüm veya yavaş yakınsama üretebilir. k-means++ mevcut tohumlardan uzaklığa bağlı olasılıkla tohumlar seçer, böylece veri kümesinin kapsamını teşvik eder.
Birden çok çalıştırma hâlâ faydalıdır. Sonuçların yeniden üretilebilmesi için rastgele tohum ve başlangıç sayısını kaydedin.
Ölçekleme ve Mesafe
Kare Euclidean mesafe, K-means’i birimlere duyarlı hâle getirir. Binlerce birimde ölçülen bir özellik, 0 ile 1 arasında ölçülen bir diğerine göre baskın olabilir. Standartlaştırma yaygındır, ancak eşit standart varyansın eşit önemi yansıtıp yansıtmadığı alan bilgisiyle karar verilmelidir.
Aykırı değerler ortalamayı tipik noktalardan uzaklaştırabilir. Sağlam ölçekleme, kırpma ya da medoid tabanlı yöntemler daha iyi olabilir. Tek‑sıcak kodlu (one‑hot) kategorik özellikler, kategori benzerliğiyle uyuşmayabilecek bir mesafe geometrisi oluşturur.
k Seçimi ve Kümelerin Doğrulanması
İnertial, k arttıkça azalır, bu yüzden yalnızca k seçilemez. Dirsek yöntemi azalan iyileşmeyi arar. Silüet analizi, bütünlük ve ayrımı karşılaştırır. Örnekler ve tohumlar arasındaki istikrar ek bir kontrol sağlar.
En güçlü doğrulama, hedef alan için faydalı olmaktır. Kümeleri bilinen sonuçlarla, uzman incelemesiyle ya da bir sonraki görevle karşılaştırın; sonradan elde edilen etiketlerin nesnel olarak keşfedildiğini iddia etmeyin.
Sınırlamalar ve Alternatifler
K-means, benzer ölçekli, kompakt ve yaklaşık küresel grupları tercih eder. Gaussian karışım modelleri olasılıksal elipsoidal bileşenleri temsil eder; DBSCAN tarzı yöntemler yoğun bölgeleri ve gürültüyü tanımlar; hiyerarşik kümeleme bir birleştirme ağacı üretir.
Boyut indirgeme, hızı artırabilir veya girdileri gürültüden arındırabilir, ancak tam veri kümesi üzerinde uygulanması doğrulama sorusunu değiştirebilir. Mini‑batch K-means, yaklaşık bir güncelleme karşılığında büyük veri kümeleri için hesaplamayı azaltır.
Amaç, Başlatma ve Yakınsama
K-means, sayısal gözlemleri k kümeye, küme içi kare Euclidean mesafesini merkezlere minimize ederek ayırır. Lloyd algoritması, her noktayı en yakın merkezine atama ve merkezleri yeniden hesaplama arasında geçiş yapar; atamalar ya da amaç fonksiyonu sabitlenene kadar devam eder. Yerel bir optimuma yakınsar, mutlaka küresel en iyiyi vermez. k-means++ başlatması, başlangıç merkezlerini yayar ve genellikle sonuçları iyileştirir, ancak birden çok tohum hâlâ önemlidir. Birimler eşit katkı sağlamalıysa özellikleri standartlaştırın; çünkü kare mesafe yüksek ölçekli değişkenleri ve aykırı değerleri büyütür.
Yöntem, Euclidean geometri altında yaklaşık kompakt, küresel ve benzer ölçekli kümeler varsayar. Uzunlamasına manifoldlar, eşitsiz yoğunluk, kategorik veri, yoğun aykırı değerler ve iç içe yapı ile zorlanır. Boş kümeler ve yinelenen noktalar tanımlı bir işleme ihtiyaç duyar. Mini‑batch k-means, bir yaklaşım karşılığında büyük verilere ölçeklenir. Seyrek metinler için kosinüs‑odaklı küresel k-means yönle daha iyi eşleşebilir; karışımlar, yoğunluk yöntemleri, hiyerarşik kümeleme ya da k‑medoidler diğer varsayımları kodlar.
k Seçimi ve Anlamın Doğrulanması
Dirsek eğrileri, silüet puanları, ilgili modellerdeki bilgi kriterleri ve istikrar k hakkında bilgi verir, ancak hiçbiri tek bir doğru sayı keşfetmez. İş faydası ve alan yorumu önemlidir. Örnekler ve tohumlar arasında yeniden uyarlayın, merkez hareketini ve atama tutarlılığını karşılaştırın ve kümeleri onları oluşturmakta kullanılmayan bağımsız sonuçlarla doğrulayın. İki‑boyutlu bir projeksiyon ayrımı çarpıtabilir; bu yüzden mesafeleri ve örnekleri orijinal ya da doğrulanmış temsil uzayında inceleyin.
Kümeler, seçilen özellikler ve ölçütle oluşturulan tanımlayıcı gruplardır; doğal türler ya da nedensel segmentler değildir. Kümeleme için kullanılan aynı değişkenlere dayalı profiller döngüsel olabilir. Ayrı tutulan özellikler ve niteliksel inceleme kullanın; kümelerin öncelikle coğrafya, veri kaynağı ya da hassas özellikleri yeniden üretip üretmediğini kontrol edin. Küçük kümeler anormallik ya da artefakt olabilir. Bir kümeye isim vermek, tüm üyelerin etikete uymasını sağlamaz.
Dağıtım ve Bakım
Ölçekleme, özellik sırası, merkezler, mesafe tanımı ve küme etiketlerini birlikte depolayın. Yeni noktalar için, atanan merkeze olan mesafeyi ve eğitim desteğinin çok ötesindeki oranı izleyin; her durumu bir kümeye zorlamak yerine bilinmeyen bir durum sağlayın. Zaman içinde küme boyutlarını, merkezleri ve sonuç alâkasını izleyin. Yeniden eğitim küme kimliklerini değiştirir; bu yüzden aşağı akış kurallarını haritalayın ya da sürümleyin, eski adları sessizce yeniden kullanmayın. K-means, geometrisi soruya uyduğunda faydalı bir sıkıştırma ve segmentasyon temeli olup, evrensel bir keşif motoru değildir.
Uygulamalı Örnek: K-means ile Müşteri Segmentasyonu
Bir abonelik şirketi, kullanım özelliklerini sabit bir zaman diliminde standartlaştırır, hesap kimliklerini kaldırır ve k’yı farklı tohumlarla test eder. İstikrar, silüet ve tutulan iş sonuçları incelenir; ancak ürün ekipleri temsilci ve sınır hesapları da gözden geçirir. Bir kümenin sadece daha kısa gözlem süresine sahip yeni müşteriler olduğunu keşfederler; bu yüzden kıdem açıkça ele alınır. K-means, hiyerarşik ve yoğunluk‑tabanlı alternatiflerle karşılaştırılır; uygun olduğu varsayılmaz. Çalışma denetimsiz öğrenme olarak ele alınır, etiket keşfi olarak değil.
Segmentler, araştırma ve mesaj deneylerini yönlendirir; uygunluk ya da fiyatı belirlemez. Her merkeze uzak yeni hesaplar bilinmeyen bir atama alır. Ölçekleme, özellikler, merkezler ve isimler sürümlenir; yeniden eğitim yeni kümeleri yalnızca kanıtla eskiye eşler. İzleme, küme boyutunu, mesafeyi ve sonuç alâkasını takip eder. Hassas özellikler ve vekiller denetlenir; ekip, kümeleri seçilen davranışların matematiksel bölünmeleri olduğunu unutarak doğal kişilik tipleri gibi tanımlamaktan kaçınır.
Uygulama Kanıtları ve Operasyonel Hazırlık
Üretim kararı, başarılı bir gösterimden daha fazlasını gerektirir. Hedef kullanıcıları, çalışma ortamını, girdileri, çıktıları, bağımlılıkları, sorumluyu ve her önemli hatanın sonucunu tanımlayın. Ayarlamadan önce tekrarlanabilir bir temel ve sürümlenmiş bir değerlendirme seti oluşturun. Normal durumları, sınır koşullarını, hatalı ya da eksik girdileri, dağılım kaymasını, bağımlılık kesintisini, kötü kullanımı ve muhtemelen hizmet dışı kalacak grup ya da ortamları test edin. Görev kalitesini kalibrasyon ya da belirsizlik, gecikme, verim, kaynak maliyeti, erişilebilirlik, gizlilik ve güvenlik ile ölçün. Bağımsız bir inceleyicinin sonucu yeniden üretebilmesi ve kanıtı çekici bir prototipten ayırabilmesi için her dönüşüm ve eşik kaydedilsin.
Başlamadan önce, sürüm, istisna, değişiklik, geri alma ve emeklilik yetkisini atayın. Aşamalı bir dağıtım kullanın, güvenli bir geri dönüşü koruyun ve kasıtlı olarak eklenen hatalarla izlemeyi doğrulayın. Operasyonel telemetri, gereksiz hassas veri toplamayarak giriş kalitesini, çıktı davranışını, model ya da kural sürümünü, bağımlılık sağlığını, insan müdahalelerini ve doğrulanmış sonuçları ortaya koymalıdır. Uyarı eşikleri ve bir yanıt sorumlusu tanımlayın; ardından çevrim dışı performansın devam edeceğini varsaymak yerine dağıtımdan sonra gerçek dünya kanıtını gözden geçirin. Veri kaynakları, kullanıcılar, modeller, satıcılar, politikalar, donanım ya da hedefler değiştiğinde yeniden değerlendirin. Bakımlı bir sistem, belgelenmiş kurtarma, olay öğrenimi, silme ve saklama prosedürleri ve devre dışı bırakılması ya da değiştirilmesi gereken net bir noktaya da ihtiyaç duyar.
Sıkça Sorulan Sorular
K-means denetimli mi yoksa denetimsiz mi?
Denetimsizdir çünkü özellikler ve seçilen küme sayısı alır, hedef etiketleri almaz.
K-means yeni verileri sınıflandırır mı?
Model eğitildikten sonra, yeni bir nokta en yakın merkezine atanabilir. Bu, küme atamasıdır; mutlaka denetimli sınıf tahmini değildir.
Temel Referanslar