
AI-modeller och plattformar
Nya färdiga (OTS) datamängder från Appen accelererar AI-distribution

 Lägg till Unite.AI bland dina föredragna källor på Google
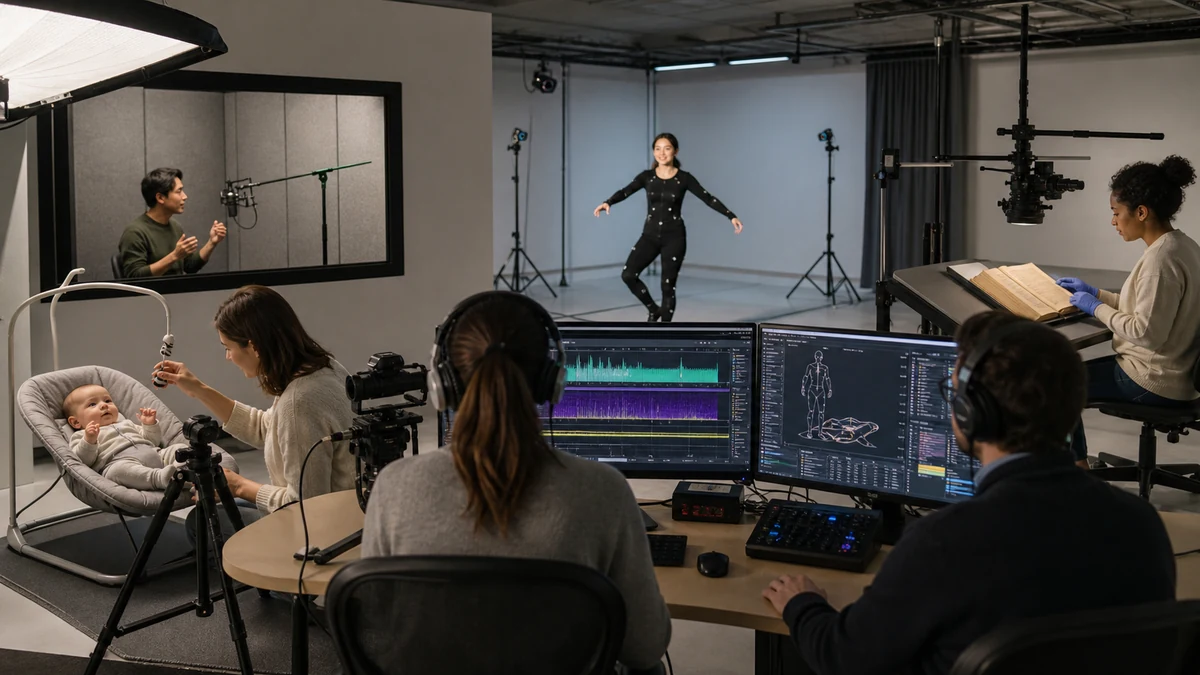
Appen Limited (ASX:APX), den ledande leverantören av högkvalitativa träningsdata för organisationer som bygger effektiva AI-system i stor skala, meddelade idag nya färdiga (OTS) datamängder. Dessa datamängder är utformade för att göra det lättare och snabbare för företag att skaffa den högkvalitativa träningsdata som behövs för att accelerera sina artificiella intelligens (AI) och maskinlärningsprojekt (ML). De nya OTS-datamängderna inkluderar mänsklig kroppsrörelse och innovativa babyljud, samt skriptat tal och bilder med text som lämpar sig för optisk teckenigenkänning (OCR) för hög efterfrågade men svåra att erhålla språk, såsom arabiska, kroatiska, grekiska, ungerska, thailändska och fler. Med de utvidgade datamängderna omfattar Appens totala OTS-erbjudande över 250 datamängder, bestående av över 11 000 timmar ljud, över 25 000 bilder och över 8,7 miljoner ord på 80 språk och flera dialektaler.
Appens OTS-datamängder är ett snabbt och kostnadseffektivt verktyg för att starta ett AI- eller ML-projekt med konsekvent högkvalitativ träningsdata. Team som utvidgar sin AI-kapacitet kan också utnyttja OTS-datamängder för att effektivt förbättra noggrannheten, utveckla nya modellfärdigheter och införa andra förbättringar i sina AI-modeller. En OTS-datamängd levereras ofta inom en vecka, till exempel, jämfört med de åtta till tolv veckor för ett nytt datamängdsinsamling- och annoteringsprojekt – eller ännu längre, beroende på komplexitet. Alla Appen-datamängder utvecklas med en fullständigt transparent, frivillig metod, så att AI-specialister kan vara säkra på att deras data är ren och följer reglerna, vilket eliminerar risken för negativa reaktioner och skador på ryktet.
”AI-team runt om i världen som arbetar med projekt med tidsbegränsningar och flexibla datakrav kan dra nytta av att använda färdiga datamängder”, sa Wilson Pang, CTO på Appen. ”OTS-datamängder förkortar tiden till värde och ger tillgång till högkvalitativa data till en lägre total kostnad än traditionella metoder. Vi på Appen vidtar nödvändiga åtgärder för att säkerställa att alla våra datamängder är etiskt framställda och demografiskt balanserade, vilket möjliggör för företag att upprätthålla ansvarsfulla AI-praxis genom att minimera fördomar i sina modeller och säkerställa rättvis behandling av dataannotatorer. Du vet alltid den exakta kvaliteten på en OTS-datamängd, vilket hjälper till att bygga bättre AI som fungerar i den verkliga världen.”
MediaInterface har levererat lösningar för språkteknologi till hälso- och sjukvårdsrelaterade institutioner i Tyskland och andra delar av Europa under mer än 20 år. När företaget utvidgade sin verksamhet till Frankrike hade de fullständigt lokaliserad programvara, men saknade franska lexikondatabaser, särskilt franska namn och platser, som ofta hänvisas till i patienternas hälsouppgifter. Med hjälp av Appens OTS-datamängder förvärvade MediaInterface cirka 21 000 franska namn och 14 000 platser. ”Den kritiska datan från Appen har införts i vår bakgrundslexikon för att framgångsrikt lansera på en ny marknad, och detta hjälper oss att bygga ut nya ordlistor för våra kunder och stärka vår strategi för framtida marknadsintroduktioner”, sa Ines Wendler, produktchef på MediaInterface.
De mest erfarna AI-experterna kombinerar OTS-datamängder med beställningsbaserade datamängdsinsamling- och annoteringsprojekt för att tillgodose sina komplexa AI-modellträningsdatabehov. Appen är ledande inom att erbjuda kontinuerligt stöd genom en rad specifika datamängdstjänster, såsom kontinuerlig dataannotering och smart etikettering, genom AI-drivna verktyg och automatiserade arbetsflöden för att maximera effektiviteten.
”Vi interagerar med AI från det ögonblick vi vaknar till det ögonblick vi går och lägger oss – genom virtuella assistenter, chattbotar, sökmotorer, sociala nätverk, medicinska enheter, smarta bilar och andra tillämpningar”, sa Judith Bishop, Appens senior chef för AI-specialister, som leder ett team på 100 AI-lingvister och språkexperter. ”Språk är ofta den primära gränssnittet för många av dessa tilltalande AI-användningsfall, så för att garantera en bra upplevelse måste modellen tränas för att fungera för alla. Appens åtagande för högkvalitativa data och ansvarsfull, etisk AI-utveckling tillåter företag som köper våra färdiga datamängder att accelerera sina AI-projekt med fullständig tillförsikt i sina data.”
Följande lista med nya Appen OTS-datamängder som nu är tillgängliga, utöver de hundratals datamängder som redan finns på appen.com, inkluderar:
- Skriptat tal för arabiska (Egypten), arabiska (Saudiarabien), arabiska (Förenade Arabemiraten), central khmer (Kambodja), kroatiska, grekiska, ungerska, polska, spanska (Spanien) och turkiska
- Bild-OCR för förenklad kinesisk tryckt text, thailändsk tryckt text och finsk tryckt text – Inkluderar förinspelade skyltar, yttre förpackningar, skyltar, tidningar och menyer för att träna och uppdatera datorseende-OCR-modeller
- Mänsklig kroppsrörelse (Kina) – Inkluderar annoterade videor av människor i rörelse, spårad på pixelnivå, lämplig för spelutveckling, fitnessappar och mer
- Babyljud (Kina) – Inkluderar förinspelade och annoterade babyljud som kan användas för att träna AI-modeller att känna igen olika gråtande ljud och varna föräldrar
För mer information och för att begära en Appen OTS-datamängdsprov, klicka här.


