
AI-modeller och plattformar
DIRFA Omvandlar Ljudklipp till Livlika Digitala Ansikten

 Lägg till Unite.AI bland dina föredragna källor på Google
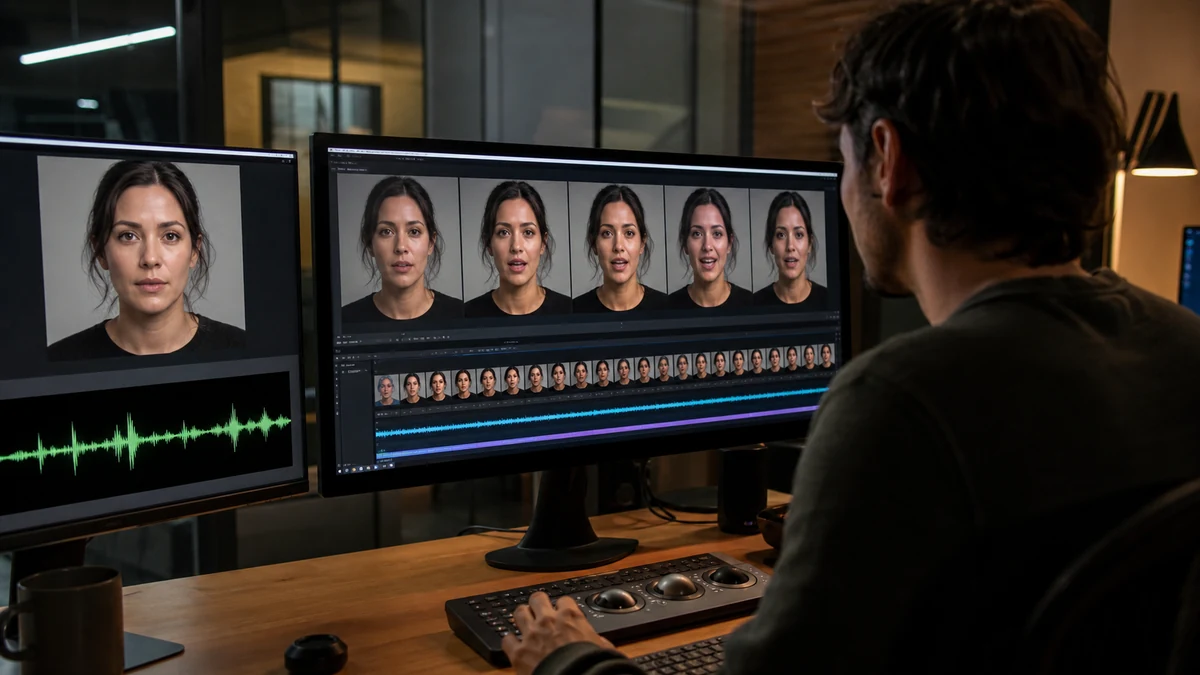
I ett remarkabelt framsteg för artificiell intelligens och multimediakommunikation har en grupp forskare vid Nanyang Technological University, Singapore (NTU Singapore) presenterat ett innovativt datorprogram som kallas DIRFA (Diverse yet Realistic Facial Animations).
Detta AI-baserade genombrott visar en imponerande förmåga: att omvandla ett enkelt ljudklipp och en statisk ansiktsbild till realistiska, 3D-animerade videor. Videorna visar inte bara exakt läppsynkronisering med ljudet, utan också en rik variation av ansiktsuttryck och naturliga huvudrörelser, vilket utvidgar gränserna för digital mediaskapelse.
Utveckling av DIRFA
DIRFAs kärnfunktionalitet ligger i dess avancerade algoritm som sömlöst kombinerar ljudinmatning med fotografisk bild för att generera tredimensionella videor. Genom att noggrant analysera talmodeller och toner i ljudet, förutsäger och replikerar DIRFA intelligent ansiktsuttryck och huvudrörelser. Detta innebär att den resulterande videon visar talaren med en hög grad av realism, deras ansiktsrörelser perfekt synkroniserade med nyanserna i deras talade ord.
DIRFAs utveckling markerar en betydande förbättring jämfört med tidigare teknologier inom detta område, som ofta kämpade med komplexiteten i varierande poser och emotionella uttryck.
Traditionella metoder kämpade vanligtvis för att exakt replikera subtiliteterna i mänskliga känslor eller var begränsade i sin förmåga att hantera olika huvudposer. DIRFA, å andra sidan, excellerar i att fånga en bred variation av emotionella nyanser och kan anpassa sig till olika huvudriktningar, vilket erbjuder en mycket mer mångsidig och realistisk utdata.
Denna framsteg är inte bara ett steg framåt i AI-teknologi, utan det öppnar också upp nya horisonter för hur vi kan interagera med och utnyttja digital media, och ger en glimt av en framtid där digital kommunikation antar en mer personlig och uttrycksfull natur.
Träning och Teknologi Bakom DIRFA
DIRFAs förmåga att replikera mänskliga ansiktsuttryck och huvudrörelser med sådan exakthet är ett resultat av en omfattande träningsprocess. Teamet vid NTU Singapore tränade programmet på en enorm dataset – över en miljon audiovisuella klipp från VoxCeleb2 Dataset.
Denna dataset omfattar en mångfald av ansiktsuttryck, huvudrörelser och talmodeller från över 6 000 individer. Genom att utsätta DIRFA för en sådan omfattande och varierad samling av audiovisuella data, lärde programmet sig att identifiera och replikera de subtila nyanser som kännetecknar mänskliga uttryck och tal.
Associate Professor Lu Shijian, den korresponderande författaren till studien, och Dr. Wu Rongliang, den första författaren, har delat värdefulla insikter om betydelsen av deras arbete.
“Studiens påverkan kan vara djupgående och långsiktig, eftersom den revolutionerar området för multimediakommunikation genom att möjliggöra skapandet av högrealistiska videor av individer som talar, med hjälp av tekniker som AI och maskinlärning”, sa Assoc. Prof. Lu. “Vårt program bygger också på tidigare studier och representerar en förbättring av teknologin, eftersom videor skapade med vårt program är fullständiga med exakt läpprörelse, livfulla ansiktsuttryck och naturliga huvudposer, med hjälp av endast deras ljudinspelningar och statiska bilder.”
Dr. Wu Rongliang tillade, “Tal visar en mångfald av variationer. Individer uttalar samma ord på olika sätt i olika sammanhang, vilket omfattar variationer i varaktighet, amplitud, ton och mer. Dessutom, utöver dess lingvistiska innehåll, förmedlar tal rik information om talarens emotionella tillstånd och identitetsfaktorer som kön, ålder, etnicitet och till och med personlighetsdrag. Vår approach representerar ett banbrytande företag i att förbättra prestanda ur perspektivet av audio-representationsinlärning i AI och maskinlärning.”

Jämförelser av DIRFA med state-of-the-art audio-driven talking face generation approaches. (NTU Singapore)
Potentiella Tillämpningar
En av de mest lovande tillämpningarna av DIRFA är inom hälso- och sjukvårdsindustrin, särskilt i utvecklingen av sofistikerade virtuella assistenter och chattbotar. Med dess förmåga att skapa realistiska och responsiva ansiktsanimationer, kan DIRFA avsevärt förbättra användarupplevelsen i digitala hälso- och sjukvårdsplattformar, vilket gör interaktionerna mer personliga och engagerande. Denna teknologi kan vara avgörande för att tillhandahålla emotionellt stöd och personlig vård genom virtuella medier, en viktig aspekt som ofta saknas i nuvarande digitala hälso- och sjukvårds Lösningar.
DIRFA har också stor potential för att hjälpa individer med talsvårigheter eller ansiktsfunktionshinder. För de som möter utmaningar i verbala interaktioner eller ansiktsuttryck, kan DIRFA fungera som ett kraftfullt verktyg, vilket möjliggör för dem att uttrycka sina tankar och känslor genom uttrycksfulla avatarer eller digitala representationer. Det kan förbättra deras förmåga att kommunicera effektivt, vilket brottas med klyftan mellan deras avsikter och uttryck. Genom att tillhandahålla ett digitalt uttrycksmedel, kan DIRFA spela en avgörande roll i att ge dessa individer en ny väg att interagera och uttrycka sig i den digitala världen.
Utmaningar och Framtida Riktningar
Att skapa livlika ansiktsuttryck enbart från ljudinmatning presenterar en komplex utmaning inom området för AI och multimediakommunikation. DIRFAs nuvarande framgång inom detta område är anmärkningsvärd, men subtiliteterna i mänskliga uttryck innebär att det alltid finns utrymme för förbättring. Varje individs talmodell är unik, och deras ansiktsuttryck kan variera dramatiskt även med samma ljudinmatning. Att fånga denna mångfald och subtilitet kvarstår som en nyckelutmaning för DIRFA-teamet.
Dr. Wu erkänner vissa begränsningar i DIRFAs nuvarande iteration. Specifikt behöver programmet gränssnittet och graden av kontroll över uttryck förbättras. Till exempel är oförmågan att justera specifika uttryck, som att ändra en sur min till ett leende, en begränsning som de siktar på att övervinna. Att hantera dessa begränsningar är avgörande för att utvidga DIRFAs tillämpbarhet och användaråtkomlighet.
I framtiden planerar NTU-teamet att förbättra DIRFA med en mer mångfaldig dataset, som omfattar en bredare variation av ansiktsuttryck och röstljudklipp. Denna expansion förväntas ytterligare förfinas och öka realismen i de ansiktsanimationer som genereras av DIRFA, vilket gör dem mer mångsidiga och anpassningsbara till olika sammanhang och tillämpningar.
DIRFAs Påverkan och Potential
DIRFA, med sin banbrytande approach för att syntetisera realistiska ansiktsanimationer från ljud, är på väg att revolutionera området för multimediakommunikation. Denna teknologi utvidgar gränserna för digital interaktion, suddar ut gränsen mellan den digitala och fysiska världen. Genom att möjliggöra skapandet av exakta, livlika digitala representationer, förbättrar DIRFA kvaliteten och äktheten i digital kommunikation.
Framtiden för teknologier som DIRFA i att förbättra digital kommunikation och representation är omfattande och spännande. När dessa teknologier fortsätter att utvecklas, lovar de att erbjuda mer immersiva, personliga och uttrycksfulla sätt att interagera i den digitala rymden.
Du kan hitta den publicerade studien här.


