Grunderna i AI
Kodning och AI: En nybörjareväg till artificiell intelligens

 Lägg till Unite.AI bland dina föredragna källor på Google
Du kan börja lära dig AI utan tidigare professionell programmeringserfarenhet, men för att bygga pålitliga system krävs så småningom tillräcklig kodnings‑, data‑ och utvärderingsförmåga för att kunna granska vad verktygen gör. Den snabbaste vägen är en kort serie projekt som är knutna till grunderna snarare än en lång resa genom orelaterade handledningar.
AI‑assisterad kodning kan förklara syntax, generera exempel och hjälpa till med felsökning. Behandla dess resultat som ett utkast: kör det, testa det, läs dokumentationen och förstå data och behörigheter innan du litar på det.
Viktiga slutsatser
- Lär dig grundläggande Python, notebook‑miljöer, Git, kommandoraden och hur man läser felmeddelanden.
- Bygg ett litet övervakat‑inlärningsprojekt innan du hoppar till agenter eller stora modeller.
- Använd tränings‑, validerings‑ och testdata korrekt; jämför med en enkel baslinje.
- Låt AI assistera återkopplingsloopen, men verifiera kod, källor, licenser, säkerhet och resultat själv.
Steg 1: programmeringsgrunder
Lär dig variabler, samlingar, villkor, loopar, funktioner, moduler, filer, miljöer och undantag. Öva på att läsa en CSV, transformera poster, anropa ett dokumenterat API, skriva ett test och använda Git för att spåra förändringar.
Du behöver inte avancerad matematik innan du skriver kod, men du bör lära dig grundläggande sannolikhet, vektorer, medelvärden, fördelningar och diagram när de blir relevanta. Computational thinking hjälper till att omvandla ett vagt mål till testbara steg.
Steg 2: ett komplett ML‑projekt
Välj en liten offentlig datamängd och en tydlig förutsägelsefråga. Utforska data, skapa en oberoende delning, bygg en baslinje, träna en enkel modell, granska fel och notera begränsningar. Använd scikit-learn innan en egen neural nätverk när det passar.
Detta projekt gör maskininlärningskoncept konkreta: funktioner, etiketter, läckage, överanpassning, mått, reproducerbarhet och skillnaden mellan ett modellresultat och ett användbart beslut.
Steg 3: djupinlärning och språkmodeller
Lär dig tensorer, batcher, förlust, gradientnedstigning och bakåtspridning genom en liten bild‑ eller textmodell. Använd sedan en förtränad modell via ett API eller ett öppet bibliotek, registrera prompts och versioner och jämför den med en enklare metod.
Utforska generative AI genom en avgränsad applikation med återhämtning eller verktygsanvändning. Lägg till validering, källhänvisningar, behörigheter och reservlösningar så att projektet lär ut systemteknik såväl som prompting.
Använd AI‑kodassistenter medvetet
Be om små funktioner, tester, förklaringar, kantfall och dokumentationsreferenser. Kör statiska kontroller och tester, granska beroendeförändringar och klistra aldrig in hemligheter eller privat data utan tillstånd. Om du inte kan förklara en kritisk rad, sakta ner.
En användbar portfölj visar frågan, datarättigheter, baslinjen, metoden, utvärderingen, fel och vad du skulle förbättra. Avslutade, dokumenterade små projekt visar mer omdöme än kopierad kod från en stor demo.
En praktisk inlärningsväg från problem till prototyp
Börja med en specifik uppgift och en liten uppsättning representativa exempel snarare än en bred ambition att ‘lära sig AI.’ Att klassificera supportmeddelanden, extrahera fakturafält eller besvara frågor från godkända dokument ger observerbara in‑ och utdata. Skriv ner hur ett bra resultat ser ut innan du väljer en modell eller ett verktyg.
No‑code‑gränssnitt kan lära prompting, datapreparering, utvärdering och arbetsflödesdesign, men de eliminerar inte behovet av tekniskt omdöme. Lär dig tabeller, filer, API:er, autentisering, variabler, villkor och grundläggande statistik. Dessa koncept förklarar hur data flödar, varför integrationer misslyckas och vad ett modellresultat betyder – och inte betyder.
Bygg en baslinje med en enkel regel, sökmetod, kalkylblad eller liten modell. Jämför sedan ett AI‑tillvägagångssätt på samma testfall. En baslinje visar om komplexitet tillför värde och ger nybörjare ett konkret felsökningsmål. Håll testdata separata från exempel som används för att konfigurera eller prompta systemet.
Prompting, API:er och övergången till kod
En användbar prompt anger uppgiften, relevant kontext, begränsningar, utschemas och exempel när det behövs. Prompt‑ändringar är programvaruändringar: versionera dem, testa dem mot en fast utvärderingsuppsättning och granska fel. Behandla inte flytande förklaringar från modellen som bevis för att svaret eller den citerade evidensen är korrekt.
Arbetsflödesbyggare kopplar modellanrop till formulär, databaser, filer och affärsapplikationer. Förstå vilken data varje steg skickar till tredje part, hur autentiseringsuppgifter lagras och vad som händer vid timeout eller återförsök. Lägg till indata‑validering, strukturerade utdata, hastighetsgränser, mänskligt godkännande och loggar innan du använder en prototyp med riktiga användare.
Kod blir värdefull när arbetsflödet kräver anpassad logik, repeterbara tester, skalning, prestanda, portabilitet eller detaljerade säkerhetskontroller. Python och JavaScript är vanliga ingångspunkter, men språket är mindre viktigt än grunderna: funktioner, datastrukturer, paket, fel, versionskontroll och tester. Använd genererad kod först efter att ha läst och kört den på ett säkert sätt.
Portföljprojekt, utvärdering och karriärutveckling
Ett starkt nybörjarprojekt dokumenterar problemet, användarna, databehörigheter, baslinjen, arkitekturen, utvärderingsuppsättningen, mått, fel, risker och nästa steg. Ett polerat gränssnitt utan utvärdering visar mindre än ett litet, reproducerbart experiment. Ta bort privat data och hemligheter innan du publicerar kod, skärmbilder, prompts eller loggar.
Utvärdera uppgiftens framgång snarare än modellens imponerande egenskaper. Klassificering kräver klassspecifik precision och återkallelse; extraktion kräver fält‑noggrannhet; återhämtning kräver evidenskcoverage; generering kräver faktualitet, nytta, säkerhet, svarstid och kostnad. Granska prestanda över språk, kantfall och berörda grupper, och definiera när en människa måste fatta beslut.
AI‑arbete omfattar produktledning, domänexpertis, dataoperationer, utvärdering, design, säkerhet, policy och förändringshantering samt modellutveckling. Bygg djup inom ett område och tillräcklig teknisk läskunnighet för att samarbeta över roller. Trovärdiga portföljer förklarar avvägningar och begränsningar istället för att presentera varje prototyp som produktionsklar automation.
Arbetsexempel: en nybörjare bygger en dokumenttriage‑assistent
En lärande samlar en liten mängd offentliga eller tillåtna dokument och definierar tre kategorier samt ett ‘osäkert’ resultat. De märker exempel med en skriven regel, reserverar en testuppsättning och implementerar en nyckelordsbaslinje i ett kalkylblad. En no‑code‑modell eller ett API returnerar sedan en strukturerad kategori och sannolikhet, som jämförs med samma fall. Felaktiga och tvetydiga exempel blir lärmaterialet, inte något dolt i en demo.
Arbetsflödet accepterar en fil, extraherar text, tar bort ej stödda format, anropar modellen med ett fast schema, validerar svaret och skickar osäkra fall till granskning. Det lagrar endast nödvändiga fält och inkluderar aldrig autentiseringsuppgifter i prompts eller delade skärmbilder. Lernaren registrerar modellnamn, prompt‑version, svarstid, kostnad och utdata så att förändringar kan testas istället för att bedömas från minnet.
En portföljrapport redovisar precision och återkallelse per klass, integritetsantaganden, felexempel och gränsen mellan prototyp och produktion. Nästa kodsteg kan ersätta en skör manuell integration med en liten testad funktion eller ett API. Denna utveckling lär ut överförbara färdigheter: problemdefinition, datakvalitet, utvärdering, gränssnitt, felhantering, säkerhet och kommunikation. Dessa grunder är viktigare än att påstå att man har byggt en sofistikerad agent efter ett enda lyckat exempel.
Praktisk implementeringschecklista
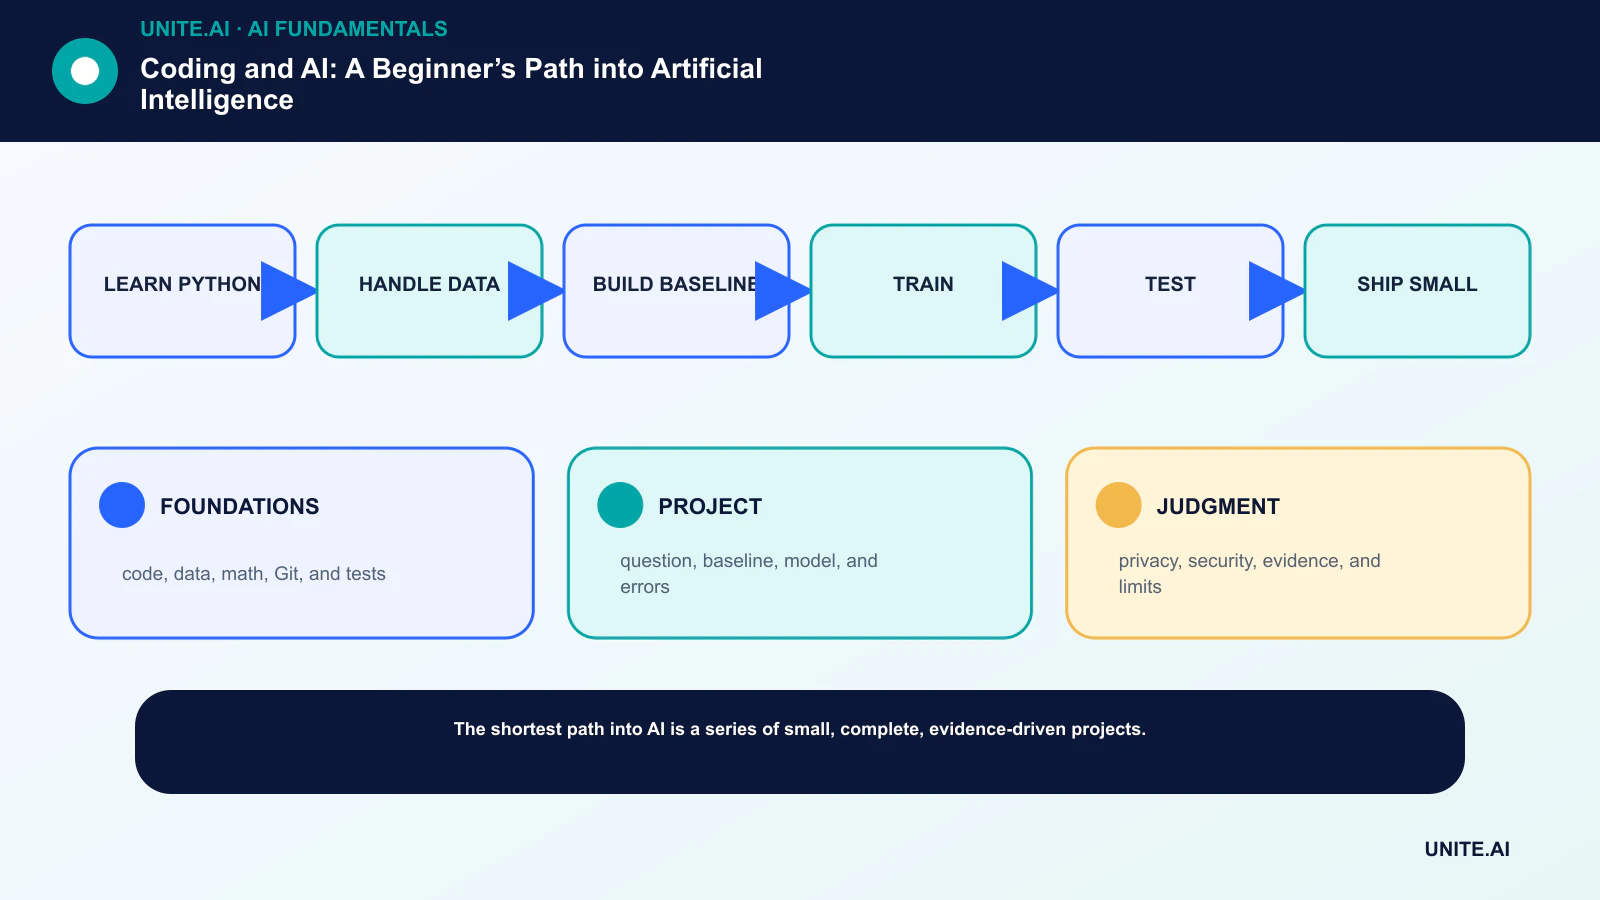
Omvandla konceptet till ett avgränsat, testbart arbetsflöde: lär dig python → hantera data → bygg baslinje → träna → testa → leverera i liten skala. Utse en ansvarig ägare, dokumentera data och beroenden, etablera en enkel baslinje, sätt acceptans‑ och stoppkriterier, testa representativa fel och definiera övervakning, återställning och granskning innan du utökar omfattningen. Registrera versioner och antaganden så att ett annat team kan reproducera resultatet och förstå vad som förändrats.
Innan lansering, genomför en dokumenterad beredskapsgranskning med de personer som bygger, driver, säkrar och påverkas av systemet. Testa normala fall, gränsvillkor, beroendefel och missbruk; bevara bevisen och olösta risker. Definiera vem som kan godkänna en release, ändra ett tröskelvärde, åsidosätta ett resultat eller stoppa driften. Ompröva beslutet när verkliga data anländer, eftersom ett tekniskt framgångsrikt pilotprojekt inte garanterar pålitlig prestanda i större skala.
- GRUNDER: kod, data, matematik, Git och tester.
- PROJEKT: fråga, baslinje, modell och fel.
- BEDÖMNING: integritet, säkerhet, evidens och gränser.
Vanliga frågor
Behöver jag en datavetenskaplig examen för att arbeta med AI?
Nej. Roller inkluderar teknik, forskning, produkt, design, drift, data, utvärdering, policy och domänexpertis. Varje roll har ett olika djup av kodningskrav.
Vilket programmeringsspråk bör en nybörjare lära sig?
Python är ett praktiskt första val eftersom dess syntax är lättillgänglig och dess data‑ och ML‑ekosystem är omfattande. De underliggande problemlösningsfärdigheterna överförs till andra språk.
Primära referenser