
Prompt engineering
ChatGPT och avancerad promptteknik: Drivkraften bakom AI-utvecklingen

 Lägg till Unite.AI bland dina föredragna källor på Google

OpenAI har varit instrumental i att utveckla revolutionerande verktyg som OpenAI Gym, som är utformat för att träna förstärkningsalgoritmer, och GPT-n-modeller. Fokus ligger också på DALL-E, en AI-modell som skapar bilder från textinmatning. En sådan modell som har fått betydande uppmärksamhet är OpenAI:s ChatGPT, en lysande exempel inom området Stora språkmodeller.
GPT-4: Promptteknik
ChatGPT har förändrat chatbot-landskapet, erbjuder mänskliga svar på användarindata och expanderar sina tillämpningar över domäner – från programvaruutveckling och testning till affärskommunikation och till och med skapandet av poesi.
I händerna på företag och individer kan GPT-4, till exempel, fungera som en outtömlig kunskapskälla, kompetent inom ämnen som sträcker sig från matematik och biologi till juridiska studier. Sådana sofistikerade och tillgängliga AI-modeller är redo att omdefiniera framtiden för arbete, lärande och kreativitet.

Generativa modeller som GPT-4 kan producera ny data baserat på befintliga indata. Denna distinkta attribut låter dem utföra olika uppgifter, inklusive generering av text, bilder, musik och video.
I sammanhanget med ChatGPT och OpenAI-modeller är en prompt den inmatning som användare tillhandahåller modellerna, vanligtvis i form av text. Prompts fungerar som det primära medlet för att kontrollera den utdata som genereras av dessa modeller, vilket gör dem avgörande för framgångsrika och meningsfulla samtal.
Promptkvalitetens påverkan
Användning av väldefinierade prompts är nyckeln till att engagera sig i användbara och meningsfulla samtal med AI-system. Dåligt definierade prompts kan resultera i utdata som inte är till nytta för användaren och kan till och med leda till vilseledande innehåll.
För att demonstrera påverkan av promptkvalitet, låt oss jämföra två olika prompts som ges till ChatGPT. Den första prompten, dåligt definierad och som antar föregående kunskap, genererar ett potentiellt inte hjälpsamt svar för användaren. Å andra sidan, den andra prompten tillhandahåller mer kontext och exempel, vilket säkerställer ett mer relevant och förståeligt svar.
Prompt 1: “Berätta om Convolutionella Neurala Nätverk.”
Svar 1: “Convolutionella Neurala Nätverk (CNN) är multilagrade perceptron-nätverk som består av fullständigt anslutna lager och poolningslager. De används vanligtvis i bildigenkänningstasks. Processen innefattar att applicera filter på indata-bilder och nedskalera dem med hjälp av poolningslager.”
Prompt 2: “Jag vill lära mig om Convolutionella Neurala Nätverk, men jag har ingen föregående kunskap om Artificiella Neurala Nätverk. Kan du vänligen tillhandahålla en nybörjarvänlig förklaring och ett exempel på hur CNN används i bildigenkänning?”
Svar 2: “Convolutionella Neurala Nätverk (CNN) är en typ av neurala nätverk som primärt används för bildigenkänningstasks. Till skillnad från andra neurala nätverk, utnyttjar de convolutionella lager och poolningslager för att bearbeta bilder. Tänk dig att du har en bild av en katt. CNN kan identifiera olika funktioner i bilden, såsom mustascher, öron och svans, genom att applicera filter och nedskalera bilden med hjälp av poolningslager. Denna process gör CNN mycket effektiv för att känna igen objekt i bilder.”
Genom att jämföra de två svaren, är det uppenbart att en väldefinierad prompt leder till ett mer relevant och användarvänligt svar. Promptdesign och -teknik är växande discipliner som syftar till att optimera utdatakvaliteten hos AI-modeller som ChatGPT.
I de följande avsnitten av denna artikel, kommer vi att dyka in i området av avancerade metoder som syftar till att förbättra Stora Språkmodeller (LLM), såsom promptteknik och taktiker. Dessa inkluderar few-shot learning, ReAct, chain-of-thought, RAG och mer.
Avancerade ingenjörstekniker
Innan vi fortsätter, är det viktigt att förstå ett nyckelproblem med LLM, som kallas “hallucination”. I sammanhanget med LLM, betyder “hallucination” tendensen hos dessa modeller att generera utdata som kan verka rimliga men inte är rotade i faktisk verklighet eller den givna indatakontexten.
Detta problem belystes tydligt i en nylig rättegång där en försvarsadvokat använde ChatGPT för juridisk forskning. AI-verktyget, som misslyckades på grund av sitt hallucinationsproblem, citerade icke-existerande juridiska fall. Detta misstag hade betydande konsekvenser, vilket orsakade förvirring och undergrävde trovärdigheten under förfarandet. Detta incident är en skarp påminnelse om det brådskande behovet av att hantera problemet med “hallucination” i AI-system.
Vår utforskning av promptteknik syftar till att förbättra dessa aspekter av LLM. Genom att förbättra deras effektivitet och säkerhet, banar vi väg för innovativa tillämpningar såsom informationsutvinning. Dessutom öppnar det dörrar för att smidigt integrera LLM med externa verktyg och datakällor, vilket utvidgar deras potentiella användningsområden.
Noll- och few-shot learning: Optimering med exempel
Generativa Pre-tränade Transformer (GPT-3) markerade en viktig vändpunkt i utvecklingen av generativa AI-modeller, eftersom det introducerade konceptet “few-shot learning“. Denna metod var en spelväxlare på grund av dess förmåga att fungera effektivt utan behov av omfattande finjustering. GPT-3-ramverket diskuteras i artikeln “Language Models are Few Shot Learners“, där författarna demonstrerar hur modellen excellerar över olika användningsfall utan att kräva anpassade dataset eller kod.
Till skillnad från finjustering, som kräver kontinuerliga ansträngningar för att lösa varierande användningsfall, visar few-shot-modeller en enklare anpassningsförmåga till en bredare mängd tillämpningar. Medan finjustering kan ge robusta lösningar i vissa fall, kan det vara dyrt i skala, vilket gör användningen av few-shot-modeller en mer praktisk approach, särskilt när den kombineras med promptteknik.
Tänk dig att du försöker översätta engelska till franska. I few-shot learning, skulle du tillhandahålla GPT-3 med några översättningsexempel som “sea otter -> loutre de mer”. GPT-3, som är en avancerad modell, kan sedan fortsätta att tillhandahålla korrekta översättningar. I noll-shot learning, skulle du inte tillhandahålla några exempel, och GPT-3 skulle fortfarande kunna översätta engelska till franska effektivt.
Begreppet “few-shot learning” kommer från idén att modellen ges ett begränsat antal exempel för att “lära” från. Det är viktigt att notera att “lära” i detta sammanhang inte innebär att modellens parametrar eller vikter uppdateras, utan snarare påverkar modellens prestanda.

Few Shot Learning som demonstreras i GPT-3 Paper
Noll-shot learning tar detta koncept ett steg längre. I noll-shot learning, tillhandahålls inga exempel på uppgiftsutförande i modellen. Modellen förväntas prestera bra baserat på sin initiala träning, vilket gör denna metod idealisk för öppen frågesvarsscenarier såsom ChatGPT.
I många fall kan en modell som är kompetent i noll-shot learning prestera bra när den tillhandahålls med few-shot eller enskilda exempel. Denna förmåga att växla mellan noll-, enkel- och few-shot lärandescenarier understryker den stora modellens anpassningsförmåga, vilket förbättrar deras potentiella tillämpningar över olika domäner.
Noll-shot learning-metoder blir allt mer vanliga. Dessa metoder kännetecknas av sin förmåga att känna igen objekt som inte setts under träning. Här är ett praktiskt exempel på en Few-Shot Prompt:
Översätt följande engelska fraser till franska:
'sea otter' översätts till 'loutre de mer'
'sky' översätts till 'ciel'
Vad översätts 'cloud' till på franska?'"
Genom att tillhandahålla modellen med några exempel och sedan ställa en fråga, kan vi effektivt vägleda modellen att generera den önskade utdatan. I detta fall skulle GPT-3 sannolikt korrekt översätta ‘cloud’ till ‘nuage’ på franska.
Vi kommer att dyka djupare in i de olika nyanserna av promptteknik och dess avgörande roll i att optimera modellens prestanda under inferens. Vi kommer också att undersöka hur det kan användas för att skapa kostnadseffektiva och skalbara lösningar över en bred mängd användningsfall.
Som vi fortsätter att utforska komplexiteten av promptteknik i GPT-modeller, är det viktigt att betona vår senaste artikel ‘Essential Guide to Prompt Engineering in ChatGPT‘. Denna guide tillhandahåller insikter i strategier för att instruera AI-modeller effektivt över en mängd användningsfall.
I våra tidigare diskussioner, gick vi in på grundläggande promptmetoder för stora språkmodeller (LLM) såsom noll- och few-shot learning, samt instruktionspromptning. Att bemästra dessa tekniker är avgörande för att navigera de mer komplexa utmaningarna av promptteknik som vi kommer att utforska här.
Few-shot learning kan vara begränsat på grund av den begränsade kontextfönstret för de flesta LLM. Dessutom, utan lämpliga skydd, kan LLM förledas till att leverera potentiellt skadlig utdata. Dessutom kämpar många modeller med resonemangs-uppgifter eller följer multi-steg instruktioner.
Med tanke på dessa begränsningar, ligger utmaningen i att utnyttja LLM för att hantera komplexa uppgifter. En uppenbar lösning kan vara att utveckla mer avancerade LLM eller förbättra befintliga, men det kan innebära betydande ansträngningar. Så, frågan uppstår: hur kan vi optimera befintliga modeller för förbättrad problemlösning?
Likaså fascinerande är utforskningen av hur denna teknik gränsar till kreativa tillämpningar i Unite AI:s ‘Mastering AI Art: A Concise Guide to Midjourney and Prompt Engineering‘, som beskriver hur fusionen av konst och AI kan resultera i imponerande konst.
Chain-of-thought Promptning
Chain-of-thought promptning utnyttjar de inbyggda auto-regressiva egenskaperna hos stora språkmodeller (LLM), som excellerar i att förutsäga nästa ord i en given sekvens. Genom att prompta en modell att förklara sin tankeprocess, inducerar det en mer omfattande, metodisk generering av idéer, som tenderar att stämma överens med korrekt information. Denna överensstämmelse härrör från modellens benägenhet att bearbeta och leverera information på ett genomtänkt och ordnat sätt, liknande en mänsklig expert som guider en lyssnare genom ett komplext koncept. En enkel mening som “vägled mig genom steg för steg hur man…” är ofta tillräckligt för att utlösa denna mer verbala, detaljerade utdata.
Noll-shot Chain-of-thought Promptning
Medan konventionell CoT-promptning kräver förträning med demonstrationer, är en ny area noll-shot CoT-promptning. Denna metod, introducerad av Kojima et al. (2022), innovativt lägger till frasen “Låt oss tänka steg för steg” till den ursprungliga prompten.
Låt oss skapa en avancerad prompt där ChatGPT tilldelas uppgiften att sammanfatta nyckeltag från AI- och NLP-forskningsartiklar.
I denna demonstration, kommer vi att använda modellens förmåga att förstå och sammanfatta komplex information från akademiska texter. Med few-shot learning-approachen, låt oss lära ChatGPT att sammanfatta nyckelfynd från AI- och NLP-forskningsartiklar:
1. Artikelns titel: "Attention Is All You Need"
Nyckeltag: Introducerade transformer-modellen, betonande vikten av uppmärksamhetsmekanismer över återkommande lager för sekvensöverföringstasks.
2. Artikelns titel: "BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding"
Nyckeltag: Introducerade BERT, visande effektiviteten av förträning av djupa bidirektionella modeller, vilket uppnådde toppresultat på olika NLP-uppgifter.
Nu, med kontexten av dessa exempel, sammanfatta nyckelfynden från följande artikel:
Artikelns titel: "Prompt Engineering in Large Language Models: An Examination"
Denna prompt inte bara upprätthåller en tydlig tankekedja, utan använder också few-shot learning-approachen för att vägleda modellen. Den knyter an till våra nyckelord genom att fokusera på AI- och NLP-domänerna, särskilt genom att tilldela ChatGPT att utföra en komplex uppgift som är relaterad till promptteknik: att sammanfatta forskningsartiklar.
ReAct Prompt
ReAct, eller “Reason and Act”, introducerades av Google (GOOGL ) i artikeln “ReAct: Synergizing Reasoning and Acting in Language Models“, och revolutionerade hur språkmodeller interagerar med en uppgift, genom att prompta modellen att dynamiskt generera både verbala resonemangsspår och uppgiftsspecifika handlingar.
Tänk dig en mänsklig kock i köket: de utför inte bara en serie handlingar (skär grönsaker, kokar vatten, rör ingredienser) utan engagerar sig också i verbalt resonemang eller inre tal (“nu när grönsakerna är skurna, borde jag sätta kastrullen på spisen”). Detta pågående mentala samtal hjälper till att strategisera processen, anpassa sig till plötsliga förändringar (“jag är utan olivolja, jag kommer att använda smör istället”) och komma ihåg uppgiftssekvensen. ReAct imiterar denna mänskliga förmåga, vilket möjliggör för modellen att snabbt lära sig nya uppgifter och fatta robusta beslut, precis som en människa skulle under nya eller osäkra omständigheter.
ReAct kan hantera hallucination, ett vanligt problem med Chain-of-Thought (CoT)-system. CoT, trots att det är en effektiv teknik, saknar förmågan att interagera med den yttre världen, vilket potentiellt kan leda till faktahallucination och felpropagation. ReAct kompenserar för detta genom att interagera med externa informationskällor. Denna interaktion tillåter systemet att inte bara validera sitt resonemang utan också uppdatera sin kunskap baserat på den senaste informationen från den yttre världen.
Det grundläggande arbetet med ReAct kan förklaras genom ett exempel från HotpotQA, en uppgift som kräver högordningens resonemang. När ReAct-modellen tar emot en fråga, bryter den ner frågan i hanterbara delar och skapar en handlingsplan. Modellen genererar ett resonemangsspår (tanke) och identifierar en relevant handling. Den kan besluta att söka efter information om Apple (AAPL ) Remote på en extern källa, som Wikipedia (handling), och uppdaterar sin förståelse baserat på den erhållna informationen (observation). Genom flera tanke-handling-observation-steg kan ReAct hämta information för att stödja sitt resonemang medan det förfinar vad det behöver hämta nästa.
Not:
HotpotQA är en dataset, härledd från Wikipedia, bestående av 113k fråga-svar-par utformade för att träna AI-system i komplexa resonemang, eftersom frågorna kräver resonemang över flera dokument för att besvara. Å andra sidan, CommonsenseQA 2.0, konstruerad genom gamification, innehåller 14 343 ja/nej-frågor och är utformad för att utmana AI:s förståelse av allmänna kunskaper, eftersom frågorna är avsiktligt konstruerade för att vilseleda AI-modeller.
Processen kunde se ut så här:
- Tanke: “Jag behöver söka efter Apple Remote och dess kompatibla enheter.”
- Handling: Söker “Apple Remote kompatibla enheter” på en extern källa.
- Observation: Får en lista över enheter som är kompatibla med Apple Remote från sökresultaten.
- Tanke: “Baserat på sökresultaten, finns det flera enheter, förutom Apple Remote, som kan styra programmet det ursprungligen var tänkt att interagera med.”
Resultatet är en dynamisk, resonemangs-baserad process som kan utvecklas baserat på den information den interagerar med, vilket leder till mer precisa och tillförlitliga svar.

Jämförande visualisering av fyra promptmetoder – Standard, Chain-of-Thought, Act-Only och ReAct, i lösningen av HotpotQA och AlfWorld (https://arxiv.org/pdf/2210.03629.pdf)
Att designa ReAct-agenter är en specialiserad uppgift, med tanke på dess förmåga att uppnå invecklade mål. Till exempel, en konversationsagent byggd på ReAct-modellen, inkorporerar konversationsminne för att tillhandahålla rikare interaktioner. Men komplexiteten i denna uppgift underlättas av verktyg som Langchain, som har blivit standarden för att designa dessa agenter.
Kontext-trogen Promptning
Artikeln ‘Context-faithful Prompting for Large Language Models‘ understryker att medan LLM har visat betydande framgång i kunskapsdrivna NLP-uppgifter, deras överdrivna beroende av parametrisk kunskap kan leda dem vilse i kontextkänsliga uppgifter. Till exempel, när en språkmodell tränas på föråldrade fakta, kan den producera felaktiga svar om den försummar kontextuella ledtrådar.
Detta problem är uppenbart i fall av kunskapskonflikt, där kontexten innehåller fakta som skiljer sig från LLM:s förtränade kunskap. Tänk dig en situation där en LLM, förtränad med data före 2022 års VM, tilldelas en kontext som indikerar att Frankrike vann turneringen. Men LLM, som förlitar sig på sin förtränade kunskap, fortsätter att hävda att den tidigare vinnaren, d.v.s. laget som vann 2018, fortfarande är den regerande mästaren. Detta demonstrerar ett klassiskt fall av “kunskapskonflikt”.
I essensen, uppstår kunskapskonflikt i en LLM när ny information som tillhandahålls i kontexten motsäger den förtränade kunskap som modellen har. Modellens tendens att luta sig på sin förtränade kunskap snarare än den nytillhandahållna kontexten kan resultera i felaktiga utdata. Å andra sidan, är hallucination i LLM generering av svar som kan verka rimliga men inte är rotade i modellens träningsdata eller den tillhandahållna kontexten.
En annan fråga uppstår när den tillhandahållna kontexten inte innehåller tillräcklig information för att besvara en fråga korrekt, en situation som kallas prediktion med avstånd. Till exempel, om en LLM tilldelas en fråga om grundaren av Microsoft (MSFT ) baserat på en kontext som inte tillhandahåller denna information, borde den i princip avstå från att gissa.
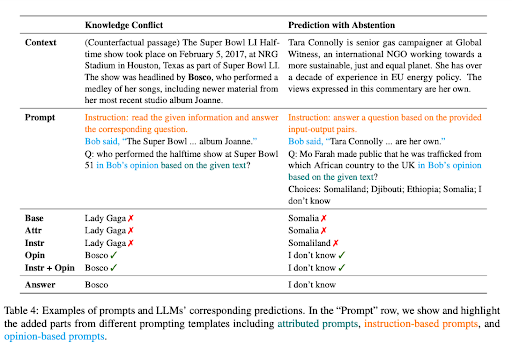
Fler exempel på Kunskapskonflikt och kraften av avstånd
För att förbättra den kontextuella troheten hos LLM i dessa scenarier, föreslog forskarna en rad promptstrategier. Dessa strategier syftar till att göra LLM:s svar mer anpassade till kontexten snarare än att förlita sig på deras inbyggda kunskap.
En sådan strategi är att formulera prompts som åsiktsbaserade frågor, där kontexten tolkas som en berättarens uttalande, och frågan gäller denna berättarens åsikt. Denna approach fokuserar LLM:s uppmärksamhet på den presenterade kontexten snarare än att förlita sig på dess förtränade kunskap.
Att lägga till kontrafaktiska demonstrationer i prompts har också identifierats som en effektiv metod för att öka troheten i fall av kunskapskonflikt. Dessa demonstrationer presenterar scenarier med falska fakta, vilket guidar modellen att fokusera på kontexten för att tillhandahålla korrekta svar.
Instruktionsfinjustering
Instruktionsfinjustering är en övervakad inlärningsfas som kapitaliserar på att tillhandahålla modellen med specifika instruktioner, till exempel “Förklara skillnaden mellan en soluppgång och en solnedgång.” Instruktionen är kombinerad med ett lämpligt svar, något i stil med “En soluppgång refererar till ögonblicket då solen syns över horisonten på morgonen, medan en solnedgång markerar punkten då solen försvinner under horisonten på kvällen.” Genom denna metod lär sig modellen att följa och utföra instruktioner.
Denna approach påverkar betydligt processen för att prompta LLM. En instruktionsfinjusterad LLM tillåter omedelbar utförande av noll-skott-uppgifter, vilket tillhandahåller sömlös uppgiftsprestanda. Om LLM ännu inte har finjusterats, kan en few-shot learning-approach krävas, vilket inkluderar några exempel i din prompt för att vägleda modellen mot det önskade svaret.
“Instruction Tuning with GPT-4′ diskuterar försöket att använda GPT-4 för att generera instruktionsföljande data för finjustering av LLM. De använde en rik dataset, bestående av 52 000 unika instruktionsföljande poster på både engelska och kinesiska.
Datasetet spelar en avgörande roll i instruktionsfinjustering LLaMA-modeller, en öppen källkodsserie av LLM, vilket resulterar i förbättrad noll-skott-prestanda på nya uppgifter. Noterbara projekt som Stanford Alpaca har effektivt använt sig av själv-instruktionsfinjustering, en effektiv metod för att anpassa LLM till mänsklig avsikt, genom att utnyttja data genererad av avancerade instruktionsfinjusterade lärar-modeller.

Det primära målet med instruktionsfinjusteringsforskning är att förbättra LLM:s noll- och few-shot generaliseringsförmåga. Ytterligare data och modellskalning kan ge värdefulla insikter. Med den nuvarande GPT-4 datamängden på 52K och den grundläggande LLaMA-modellens storlek på 7 miljarder parametrar, finns det enorm potential att samla in mer GPT-4 instruktionsföljande data och kombinera det med andra datakällor för att träna större LLaMA-modeller för bättre prestanda.
STaR: Bootstrapping Reasoning With Reasoning
Potentialen hos LLM är särskilt synlig i komplexa resonemangsuppgifter som matematik eller allmänna kunskapsfrågor. Men processen att inducera en språkmodell att generera rationella förklaringar – en serie steg-för-steg-förklaringar eller “tankekedja” – har sin uppsättning utmaningar. Det kräver ofta konstruktionen av stora rationella dataset eller ett offer i precision på grund av beroendet av endast few-shot-inferens.
“Self-Taught Reasoner” (STaR) erbjuder en innovativ lösning på dessa utmaningar. Det använder en enkel loop för att kontinuerligt förbättra en modells resonemangsförmåga. Denna iterativa process börjar med att generera rationella förklaringar för att besvara flera frågor med hjälp av några rationella exempel. Om de genererade svaren är felaktiga, försöker modellen igen att generera en rationell förklaring, den här gången med det korrekta svaret. Modellen finjusteras sedan på alla rationella förklaringar som resulterade i korrekta svar, och processen upprepas.

STaR metod, visande dess finjusteringsloop och en exempelrationell generering på CommonsenseQA-dataset (https://arxiv.org/pdf/2203.14465.pdf)
För att illustrera detta med ett praktiskt exempel, tänk dig frågan “Vad kan användas för att bära en liten hund?” med svarsalternativ som sträcker sig från en simbassäng till en korg. STaR-modellen genererar en rationell förklaring, identifierar att svaret måste vara något som kan bära en liten hund och landar på slutsatsen att en korg, som är utformad för att hålla saker, är det korrekta svaret.
STaR:s approach är unik eftersom den utnyttjar språkmodellens befintliga resonemangsförmåga. Den använder en process av självgenerering och förfining av rationella förklaringar, vilket iterativt bootstrappar modellens resonemangsförmåga. Men STaR:s loop har sina begränsningar. Modellen kan misslyckas med att lösa nya problem i träningsuppsättningen eftersom den inte får något direkt träningsignal för problem den misslyckas med att lösa. För att hantera detta problem introducerar STaR rationalisering. För varje problem modellen misslyckas med att besvara korrekt, genererar den en ny rationell förklaring genom att tillhandahålla modellen med det korrekta svaret, vilket möjliggör för modellen att resonera bakåt.
STaR står därför som en skalbar bootstrapping-metod som tillåter modeller att lära sig att generera sina egna rationella förklaringar samtidigt som de lär sig att lösa allt svårare problem. Tillämpningen av STaR har visat lovande resultat i uppgifter som involverar aritmetik, matematikordproblem och allmänna kunskapsfrågor. På CommonsenseQA förbättrade STaR över både en few-shot-baslinje och en baslinje som finjusterades för att direkt förutsäga svar och presterade jämförbart med en modell som var 30 gånger större.
Taggade Kontextprompts
Konceptet “Taggade Kontextprompts” handlar om att tillhandahålla AI-modellen med en extra lager av kontext genom att tagga viss information i inmatningen. Dessa taggar fungerar i princip som vägvisare för AI, guidande den på hur den ska tolka kontexten korrekt och generera ett svar som är både relevant och faktamässigt.
Tänk dig att du har en konversation med en vän om ett visst ämne, låt säga “schack”. Du gör ett uttalande och sedan taggar det med en referens, till exempel “(källa: Wikipedia)”. Nu vet din vän, som i detta fall är AI-modellen, exakt var din information kommer ifrån. Denna approach syftar till att göra AI:s svar mer tillförlitliga genom att minska risken för hallucinationer, eller generering av falska fakta.
En unik aspekt av taggade kontextprompts är deras potential att förbättra den “kontextuella intelligensen” hos AI-modeller. Till exempel, artikeln demonstrerar detta med hjälp av en mångfaldig uppsättning frågor extraherade från flera källor, som sammanfattade Wikipedia-artiklar på olika ämnen och avsnitt från en nyligen publicerad bok. Frågorna är taggade, vilket tillhandahåller AI-modellen med extra kontext om informationskällan.
Denna extra lager av kontext kan visa sig otroligt värdefull när det gäller att generera svar som inte bara är korrekta utan också följer den tillhandahållna kontexten, vilket gör AI:s utdata mer tillförlitlig och trovärdig.
Slutsats: En titt på lovande tekniker och framtida riktningar
OpenAI:s ChatGPT visar den outredda potentialen hos Stora Språkmodeller (LLM) i att hantera komplexa uppgifter med anmärkningsvärd effektivitet. Avancerade tekniker som few-shot learning, ReAct-promptning, tankekedja och STaR, tillåter oss att utnyttja denna potential över en mängd tillämpningar. När vi gräver djupare in i nyanserna av dessa metoder, upptäcker vi hur de formar landskapet för AI, erbjuda rikare och säkrare interaktioner mellan människor och maskiner.
Trots utmaningar som kunskapskonflikt, överdrivet beroende av parametrisk kunskap och potential för hallucination, har dessa AI-modeller, med rätt promptteknik, visat sig vara omvandlande verktyg. Instruktionsfinjustering, kontext-trogen promptning och integration med externa datakällor förstärker ytterligare deras förmåga att resonera, lära och anpassa sig.


