Andersons vinkel
AI‑bildmatning som förstår scener

 Lägg till Unite.AI bland dina föredragna källor på Google
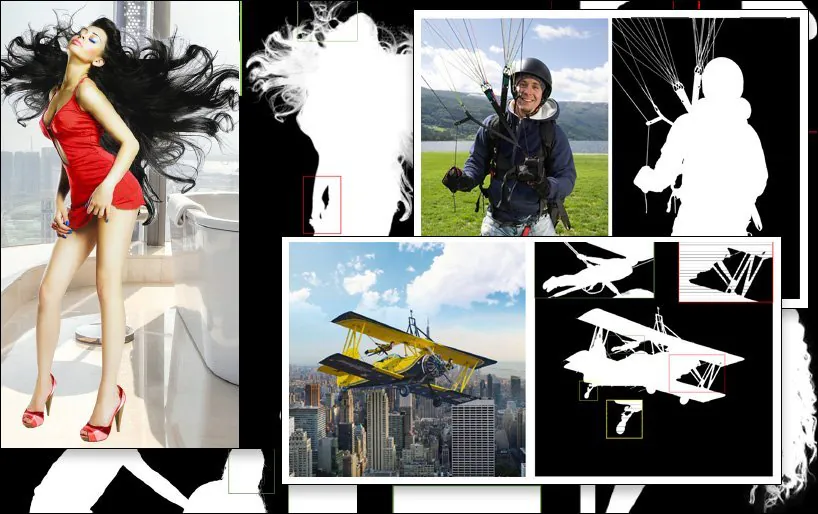
I extradokumentären som följer med 2003 års DVD‑utgåva av Alien3 (1992) minns VFX‑legenden Richard Edlund med skräck den ’sumowrestling’ som fotokemisk matteextraktion innebar och som dominerade VFX‑arbetet mellan sent 1930‑tal och sent 1980‑tal. Edlund beskrev processens träff‑och‑miss‑karaktär som ’sumowrestling’, i jämförelse med de digitala blå‑/grönskärm‑teknikerna som tog över i början av 1990‑talet (och han har återgått till metaforen sedan dess).
Att extrahera ett förgrundselement (t.ex. en person eller en rymdskeppsmodell) från en bakgrund, så att den utskurna bilden kan komponeras in i en bakgrundsplatta, gjordes ursprungligen genom att filma förgrundsobjektet mot en enhetlig blå eller grön bakgrund.
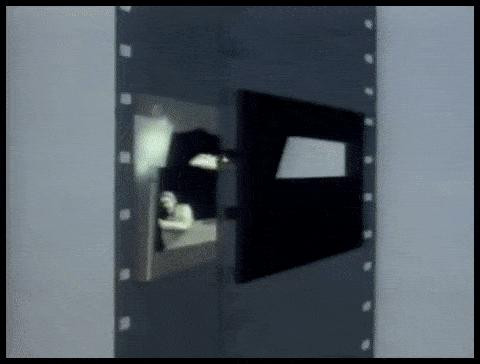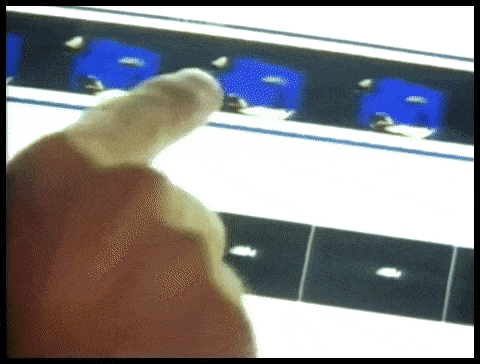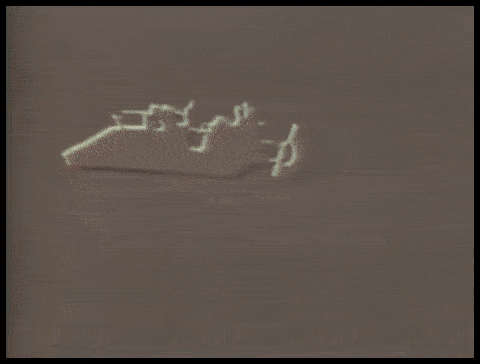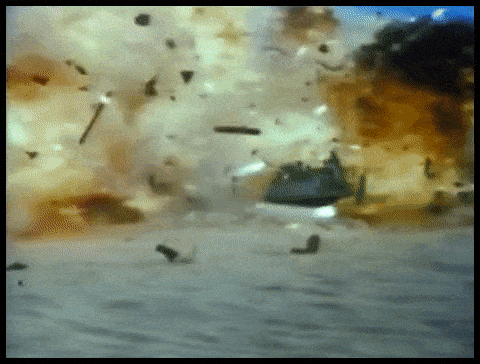
Laborious photochemical extraction processes for a VFX shot by ILM for ‘Return of the Jedi’ (1983).
I det resulterande materialet isolerades bakgrundsfärgen därefter kemiskt och användes som mall för att återtrycka förgrundsobjektet (eller personen) i en optisk skrivare som ett ’flytande’ objekt i en annars transparent filmcell.
Processen kallades färgseparationsöverlagring (CSO) – även om denna term så småningom blev mer förknippad med de grova ‘Chromakey’-videoeffekterna i lågbudgeterad TV‑produktion under 1970‑ och 1980‑talen, vilka uppnåddes med analoga snarare än kemiska eller digitala metoder.

A demonstration of Color Separation Overlay in 1970 for the British children’s show ‘Blue Peter’. Source: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
I vilket fall som helst, oavsett om det gäller film‑ eller videoelement, kunde det extraherade materialet därefter infogas i vilket annat material som helst.
Även om Disneys märkbart dyrare och proprietära natriumånga‑process (som nycklade på gult specifikt, och som också användes för Alfred Hitchcocks skräckfilm The Birds från 1963) gav bättre definition och skarpare mattor, förblev fotokemisk extraktion mödosam och opålitlig.

Disney’s proprietary sodium vapor extraction process required backgrounds near the yellow end of the spectrum. Here, Angela Lansbury is suspended on wires during the production of a VFX-laced sequence for ‘Bedknobs and Broomsticks’ (1971). Source
Beyond Digital Matting
På 1990‑talet gjorde den digitala revolutionen sig av med kemikalierna, men inte behovet av grönskärmar. Det blev nu möjligt att ta bort den gröna (eller vilken färg som helst) bakgrunden bara genom att söka efter pixlar inom ett toleransintervall för den färgen, i pixelredigeringsprogram som Photoshop, samt en ny generation av videokompositionssviter som automatiskt kunde nyckla bort färgade bakgrunder. På nolltid lades sextio år av den optiska tryckeribranschen åt historien.
De senaste tio åren av GPU‑accelererad datorsynsforskning för in matteextraktion i en tredje era, där forskare uppmanas att utveckla system som kan extrahera högkvalitativa mattor utan behov av grönskärmar. På Arxiv ensam är artiklar om innovationer inom maskininlärningsbaserad förgrundsextraktion ett veckovis inslag.
Putting Us in the Picture
Detta centrum för akademiskt och industriellt intresse för AI‑extraktion har redan påverkat konsumentområdet: grova men fungerande implementationer är bekanta för oss alla i form av Zoom och Skype-filter som kan ersätta våra vardagsrumsbakgrunder med tropiska öar med mera i videokonferenssamtal.
Dock kräver de bästa mattorna fortfarande en grönskärm, enligt vad Zoom noterade i onsdags.

Left, a man in front of a green screen, with well-extracted hair via Zoom’s Virtual Background feature. Right, a woman in front of a normal domestic scene, with hair extracted algorithmically, less accurately, and with higher computing requirements. Source: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
Ett ytterligare inlägg från Zoom‑supportplattformen varnar för att extraktion utan grönskärm också kräver större beräkningskraft i inspelningsenheten.
The Need to Cut It Out
Förbättringar i kvalitet, bärbarhet och resurseffektivitet för ’i det vilda’ matte‑extraktionssystem (dvs. att isolera personer utan behov av grönskärmar) är relevanta för många fler sektorer och tillämpningar än bara videokonferensfilter.
För datasetutveckling ger förbättrad ansikts-, helhuvud- och helkroppsigenkänning möjlighet att säkerställa att överflödiga bakgrundselement inte tränas in i datorseendets modeller av mänskliga subjekt; mer exakt isolering skulle kraftigt förbättra semantisk segmentering-tekniker avsedda att särskilja och assimilera domäner (t.ex. ‘cat’, ‘person’, ‘boat’), samt förbättra VAE och transformer-baserade bildsyntessystem som OpenAI:s nya DALL‑E 2; och bättre extraktionsalgoritmer skulle minska behovet av dyr manuell rotoscoping i kostsamma VFX‑pipeline.
Faktum är att uppgången av multimodala (vanligtvis text/bild) metoder, där en domän som ’cat’ kodas både som en bild och med tillhörande textreferenser, redan gör framsteg inom bildbehandling. Ett nyligt exempel är Text2Live-arkitekturen, som använder multimodal (text/bild) träning för att skapa videor av, bland otaliga andra möjligheter, kristallsvanar och glasgiraffer.
Scene-Aware AI Matting
En stor del av forskningen kring AI‑baserad automatisk matning har fokuserat på kantigenkänning och utvärdering av pixelbaserade grupperingar i en bild eller videoram. Ny forskning från Kina erbjuder dock en extraktionspipeline som förbättrar avgränsning och mattkvalitet genom att utnyttja textbaserade beskrivningar av en scen (en multimodal metod som har fått genomslag inom datorsynsforskning under de senaste 3‑4 åren), och påstår sig ha förbättrat tidigare metoder på flera sätt.

An example SPG-IM extraction (last image, lower right), compared against competing prior methods. Source: https://arxiv.org/pdf/2204.09276.pdf
Utmaningen för extraktionsforskningsundersektorn är att producera arbetsflöden som kräver ett minimalt manuellt annoterings- och mänskligt ingripande – helst inget alls. Förutom kostnadseffekterna observerar forskarna i den nya artikeln att annotationer och manuella segmenteringar utförda av outsourcade crowdworkers i olika kulturer kan leda till att bilder märks eller till och med segmenteras på olika sätt, vilket resulterar i inkonsekventa och otillfredsställande algoritmer.
Ett exempel på detta är den subjektiva tolkningen av vad som definierar ett ’förgrundsobjekt’:

From the new paper: prior methods LFM and MODNet (‘GT’ signifies Ground Truth, an ‘ideal’ result often achieved manually or by non-algorithmic methods), have different and variously effective takes on the definition of foreground content, whereas the new SPG-IM method more effectively delineates ‘near content’ through scene context.
För att tackla detta har forskarna utvecklat en tvåstegs‑pipeline med titeln Situational Perception Guided Image Matting (SPG‑IM). Den tvåstegs‑encoder/decoder‑arkitekturen består av Situational Perception Distillation (SPD) och Situational Perception Guided Matting (SPGM).

The SPG-IM architecture.
Först förtränar SPD visuellt‑till‑textuella funktionstransformationer och genererar bildtexter som passar de associerade bilderna. Därefter möjliggörs förgrundsmaskförutsägelsen genom att koppla pipelinen till en ny saliensprediktion-teknik.
Sedan producerar SPGM en uppskattad alfa‑matte baserad på den råa RGB‑bildinmatningen och den genererade masken som erhölls i den första modulen.
Målet är vägledning genom situationsuppfattning, där systemet har en kontextuell förståelse av vad bilden består av, vilket möjliggör att exempelvis rama in utmaningen att extrahera komplext hår från en bakgrund mot kända egenskaper för en så specifik uppgift.

In the example below, SPG-IM understands that the cords are intrinsic to a ‘parachute’, where MODNet fails to retain and define these details. Likewise above, the complete structure of the playground apparatus is arbitrarily lost in MODNet.
Den nya artikeln heter Situational Perception Guided Image Matting och kommer från forskare vid OPPO Research Institute, PicUp.ai och Xmotors.
Intelligent Automated Mattes
SPG‑IM erbjuder också ett Adaptive Focal Transformation (AFT) Refinement‑nätverk som kan bearbeta lokala detaljer och global kontext separat, vilket möjliggör ’intelligenta mattor’.

Understanding scene context, in this case ‘girl with horse’, can potentially make foreground extraction easier than prior methods.
The paper states:
‘Vi tror att visuella representationer från den visuellt‑till‑textuella uppgiften, t.ex. bildtextning, fokuserar på mer semantiskt omfattande signaler mellan a) objekt till objekt och b) objekt till den omgivande miljön för att generera beskrivningar som kan täcka både den globala informationen och lokala detaljer. Dessutom, jämfört med den kostsamma pixel‑annoteringen av bildmatning, kan textuella etiketter samlas in i stor skala till mycket låg kostnad.’
SPD‑grenen i arkitekturen förtränas gemensamt med University of Michigan:s VirTex-transformer‑baserade textdekoder, som lär sig visuella representationer från semantiskt täta bildtexter.

VirTex jointly trains a ConvNet and Transformers via image-caption couplets, and transfers the obtained insights to downstream vision tasks such as object detection. Source: https://arxiv.org/pdf/2006.06666.pdf
Bland andra tester och ablationsstudier testade forskarna SPG‑IM mot toppmoderna trimap-baserade metoder Deep Image Matting (DIM), IndexNet, Context‑Aware Image Matting (CAM), Guided Contextual Attention (GCA), FBA och Semantic Image Mapping (SIM).
Andra tidigare ramverk som testades inkluderade trimap‑fria tillvägagångssätt LFM, HAttMatting och MODNet. För rättvis jämförelse anpassades testmetoderna utifrån de olika metodologierna; där koden inte var tillgänglig reproducerades artiklarnas tekniker från den beskrivna arkitekturen.
The new paper states:
‘Vår SPG‑IM överträffar alla konkurrerande trimap‑fria metoder ([LFM], [HAttMatting] och [MODNet]) med stor marginal. Samtidigt visar vår modell en anmärkningsvärd överlägsenhet gentemot toppmoderna (SOTA) trimap‑baserade och mask‑styrda metoder när det gäller alla fyra metrik på de offentliga datasetten (dvs. Composition‑1K, Distinction‑646 och Human‑2K), samt vårt Multi‑Object‑1K‑benchmark.’
And continues:
‘Det är tydligt att vår metod bevarar fina detaljer (t.ex. hårspetsar, transparenta texturer och kanter) utan trimap‑vägledning. Dessutom, jämfört med andra konkurrerande trimap‑fria modeller, kan vår SPG‑IM behålla bättre global semantisk fullständighet.’


Först publicerad 24 april 2022.