
Andersons vinkel
Konsekvent AI-videoinnehållsredigering med textstyrd inmatning

 Lägg till Unite.AI bland dina föredragna källor på Google
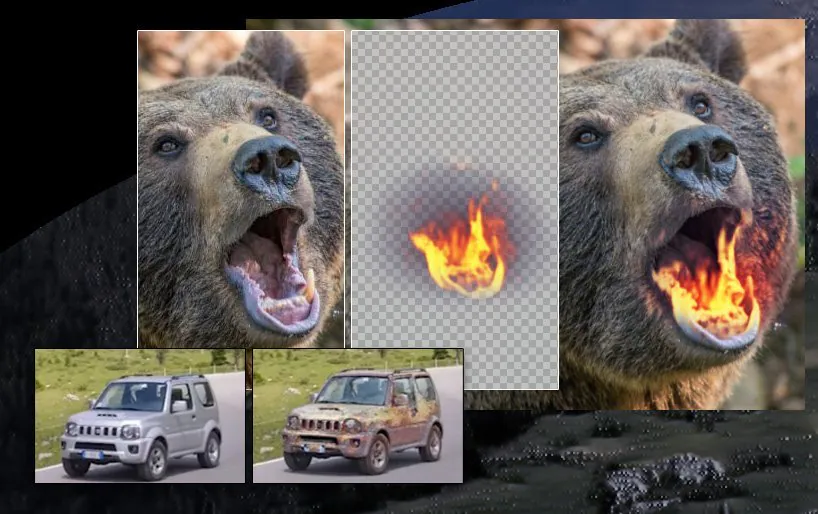
Viktiga punkterText2Live möjliggör konsekventa videoredigeringar från textprompter utan bearbetning…
Visa mer
- Text2Live möjliggör konsekventa videoredigeringar från textprompter utan bearbetning per bildruta.
- Systemet använder ett neuralt lageratlas för att tillämpa redigeringar en gång över hela videotidslinjen.
- Text2Live automatiserar maskering och kompositering, vilket eliminerar behovet av rotoskopering eller greenscreen.
Medan den professionella VFX-gemenskapen är fascinerad – och ibland känner sig lite hotad – av nya innovationer inom bild- och videosyntes, så förpassas många av dessa ansträngningar till den “psykedeliska” sfären på grund av bristen på tidskontinuitet i de flesta AI-baserade videoredigeringsprojekt, med skimrande och snabbt ändrade texturer och strukturer, inkonsekventa effekter och den typen av grov teknologi som påminner om dett fotokemiska eran av visuella effekter.
Om du vill ändra något mycket specifikt i en video som inte faller inom området för deepfakes (dvs. påtvinga en ny identitet på befintliga inspelningar av en person), så fungerar de flesta av de nuvarande lösningarna under ganska allvarliga begränsningar, när det gäller den precision som krävs för produktionskvalitetsvisuella effekter.
Ett undantag är det pågående arbetet av en lös association av akademiker från Weizmann Institute of Science. 2021 meddelade tre av dess forskare, i samarbete med Adobe (ADBE ), en ny metod för att bryta ner video och lägga till en konsekvent inre karta – en skiktad neural atlas – i en sammansatt utdata, komplett med alfa-kanaler och tidskoherent utdata.
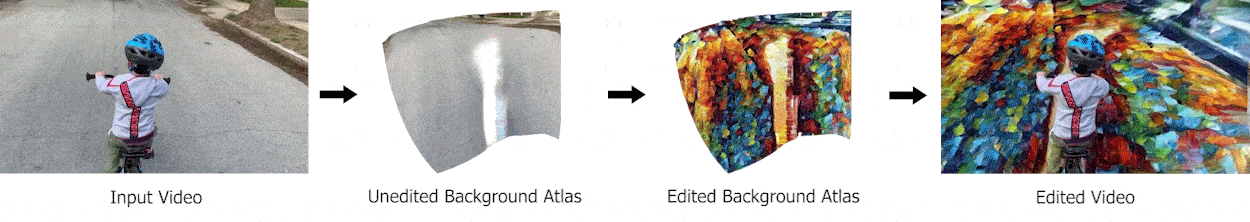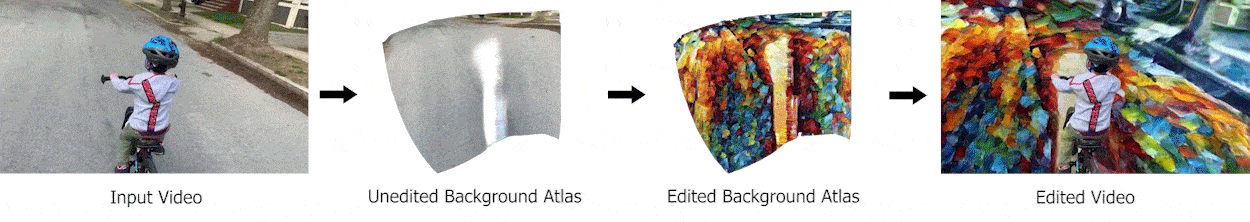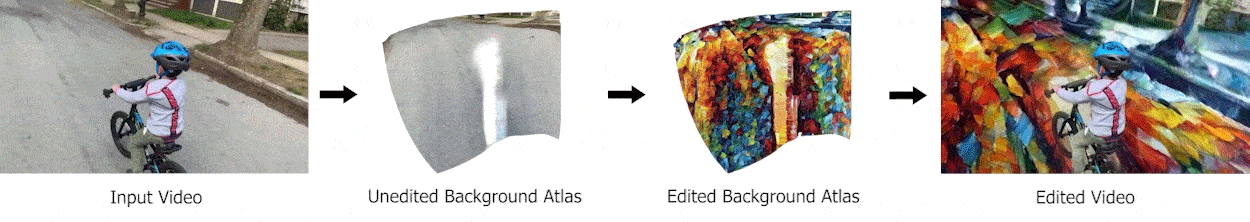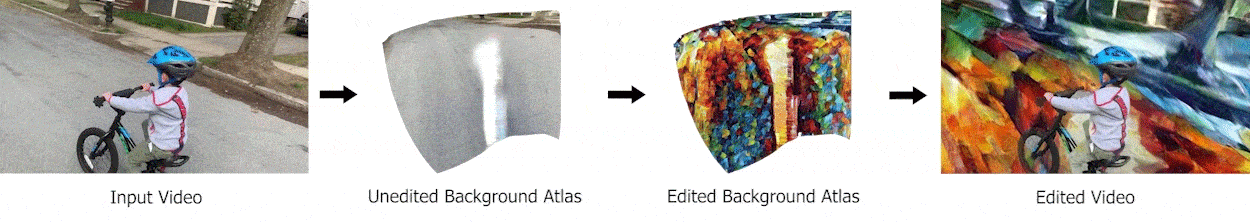
Från 2021 års forskningsartikel: en uppskattning av den fullständiga genomresan av vägen i källklippet redigeras via ett neuronnätverk på ett sätt som traditionellt skulle kräva omfattande rotoskoping och match-moving. Eftersom bakgrundselement och förgrundsobjekt hanteras av olika nätverk är maskerna verkligen ‘automatiska’. Källa: https://layered-neural-atlases.github.io/
Även om det ligger någonstans i det område som täcks av optiskt flöde i VFX-pipeliner, har den skiktade atlasen ingen direkt motsvarighet i traditionella CGI-arbetsflöden, eftersom den i princip utgör en “tids-texturkarta” som kan produceras och redigeras genom traditionella programvarumetoder. I den andra bilden i illustrationen ovan representeras vägytan (figurativt) över hela videons löptid. Att ändra den här underliggande bilden (tredje bilden från vänster i illustrationen ovan) producerar en konsekvent förändring i bakgrunden.
Bilderna av den «utvikta» atlasen ovan visar endast enskilda tolkade bildrutor. Konsekventa ändringar i en bildruta i målvideon mappas tillbaka till den ursprungliga bildrutan, samtidigt som nödvändiga skymningar och andra sceneffekter, till exempel skuggor och reflektioner, bevaras.
Kärnarkitekturen använder en flerskiktsperceptron (MLP) för att representera de utvikta atlaserna, alfakanalerna och mappningarna. Allt optimeras gemensamt och helt i ett tvådimensionellt rum. Därmed behövs inte den förhandskunskap om 3D-geometripunkter, djupkartor och liknande CGI-strukturer som NeRF-baserade metoder förutsätter.
Referensatlasen för enskilda objekt kan också ändras på ett tillförlitligt sätt:
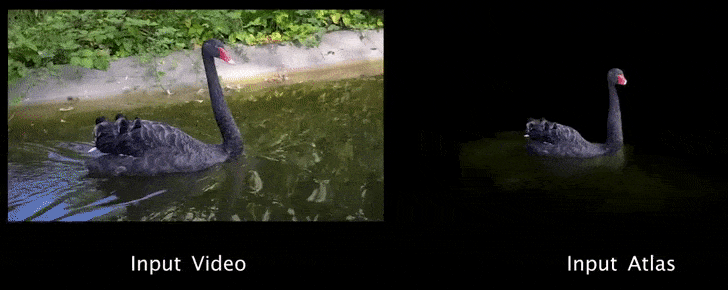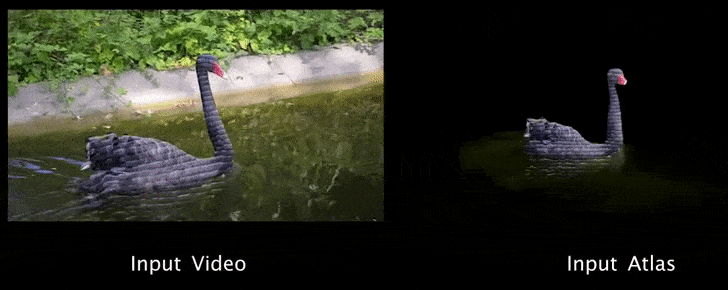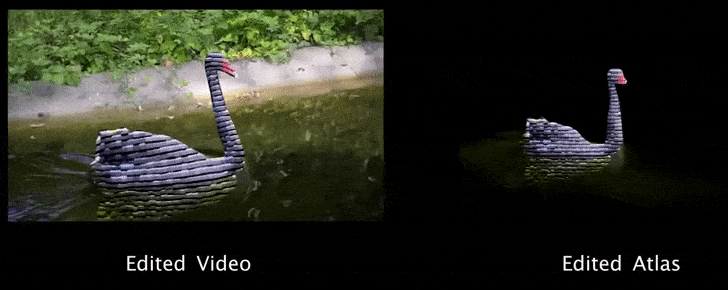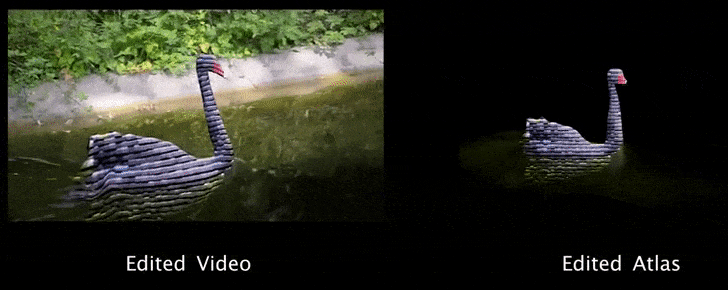
Konsekvent förändring av ett rörligt objekt under 2021-ramverket. Källa: https://www.youtube.com/watch?v=aQhakPFC4oQ
I princip kombinerar 2021-systemet geometrijustering, match-moving, kartläggning, omtexturering och rotoskoping till en diskret neural process.
Text2Live
De tre ursprungliga forskarna bakom artikeln från 2021, tillsammans med NVIDIA (NVDA ) Research, är bland bidragsgivarna till en ny innovation på tekniken som kombinerar kraften i skiktade atlaser med den typen av textstyrd CLIP-teknologi som har återvänt till framträdande ställning den här veckan med OpenAI:s utgåva av DALL-E 2-ramverket.
Den nya arkitekturen, med titeln Text2Live, tillåter en slutanvändare att skapa lokaliserade redigeringar av faktiskt videoinnehåll baserat på textprompt:
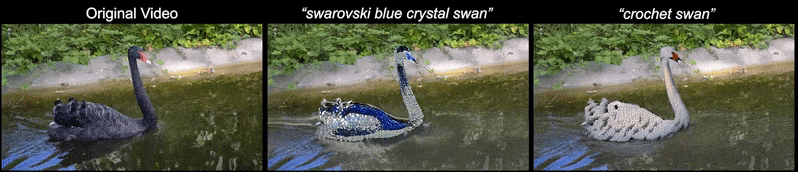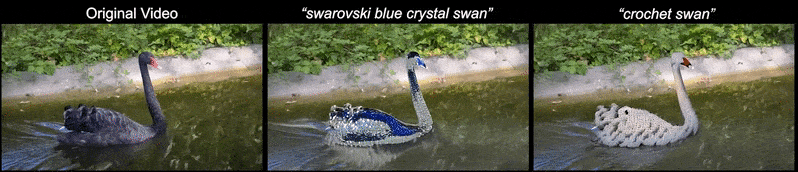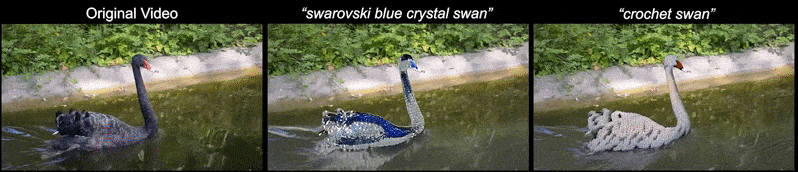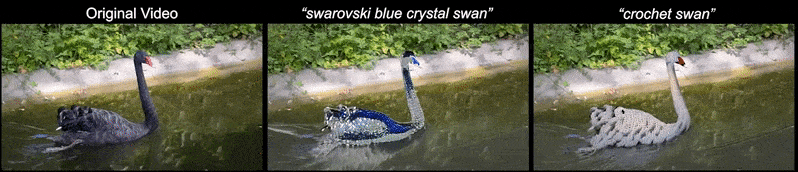
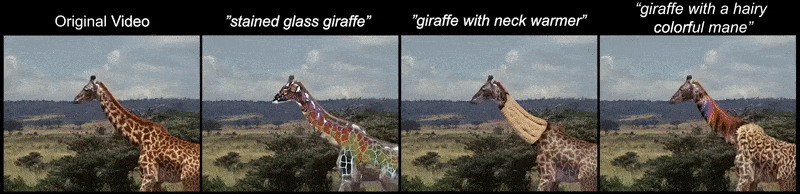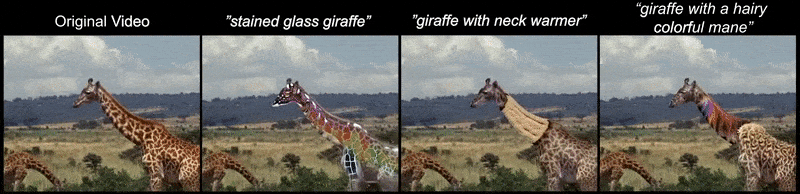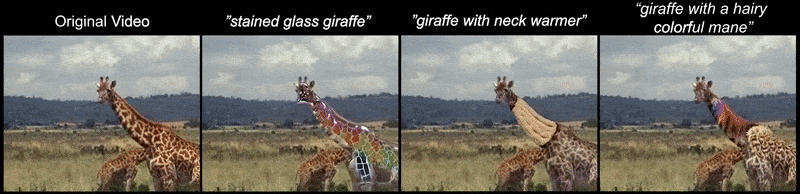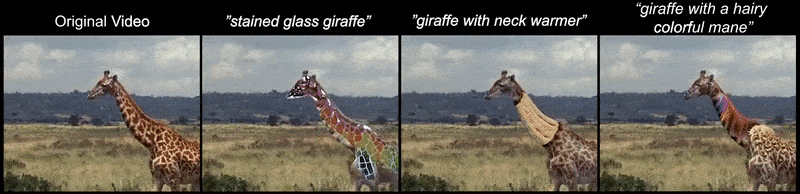
Två exempel på redigering av förgrunden. För bättre upplösning och skärpa, se de ursprungliga videorna på https://text2live.github.io/sm/pages/video_results_atlases.html
Text2Live erbjuder semantisk och högt lokaliserad redigering utan användning av en förtränad generator, genom att utnyttja en intern databas som är specifik för det videoklipp som bearbetas.

Bakgrund och förgrunds (objekt) transformationer under Text2Live. Källa: https://text2live.github.io/sm/pages/video_results_atlases.html
Tekniken kräver inga masker som användaren själv tillhandahåller, som i ett vanligt rotoskopi- eller green screen-arbetsflöde, utan uppskattar i stället relevanskartor genom en bootstrapping-teknik baserad på 2021 forskning från The School of Computer Science at Tel Aviv University och Facebook AI Research (FAIR).

Utmatningskartor genererade via en transformer-baserad generisk uppmärksamhetsmodell.
Den nya forskningsartikeln har titeln Text2LIVE: Text-Driven Layered Image and Video Editing. Det ursprungliga teamet från 2021 har fått sällskap av Omer Bar-Tal från Weizmann och Yoni Kasten från NVIDIA Research.
Arkitektur
Text2Live består av en generator som tränats på en enda inmatningsbild och måltextprompt. En Contrastive Language-Image Pretraining (CLIP) modell förtränad på 400 miljoner text/bildpar tillhandahåller associerat visuellt material från vilket användarindata transformationer kan tolkas.

Generatorn tar emot en inmatningsbild (bildruta) och producerar ett RGBA-mållager som innehåller färg- och opacitetsinformation. Detta lager komponeras sedan in i den ursprungliga filmen med ytterligare förstärkningar.

Alfa-kanalen i det genererade RGBA-lagret tillhandahåller en intern kompositfunktion utan återgång till traditionella pipelines som involverar pixelbaserad programvara som After Effects.
Genom att träna på interna bilder som är relevanta för målvideon eller bilden, undviker Text2Live kravet att antingen invertera inmatningsbilden till det latenta rummet i ett generativt adversariellt nätverk (GAN), en praxis som för närvarande är långt ifrån exakt nog för produktionsvideo redigeringskrav, eller använda en Diffusionsmodell som är mer exakt och konfigurerbar, men inte kan upprätthålla trohet till målvideon.

Varierande prompt-baserad transformationsredigering från Text2Live.
Tidigare tillvägagångssätt har antingen använt propageringsbaserade metoder eller optiskt flödesbaserade tillvägagångssätt. Eftersom dessa tekniker i någon utsträckning utgår från enskilda bildrutor kan ingen av dem ge ändringarna ett konsekvent utseende över tid i den färdiga videon. En skiktad neural atlas ger i stället ett gemensamt rum där ändringarna kan hanteras, så att de förblir trogna den valda förändringen när videon fortsätter.
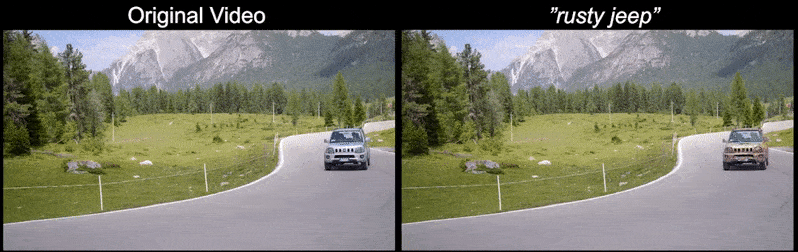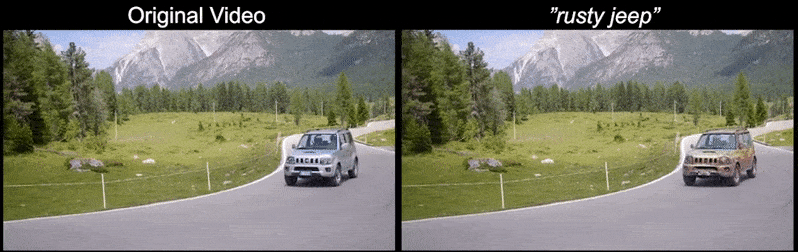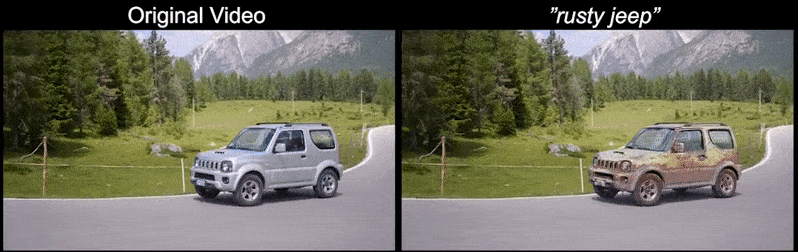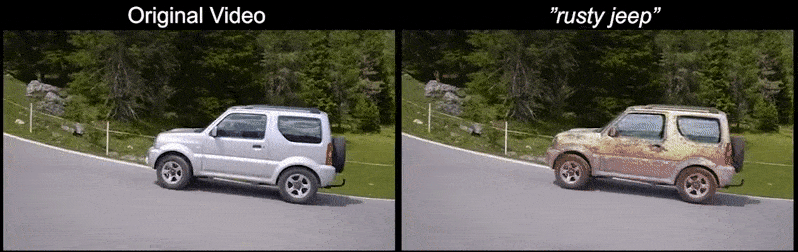
Inget flimmer eller slumpmässiga hallucinationer: Text2Live erhåller en tolkning av textprompten ‘rostig jeep’, och tillämpar den en gång på den skiktade neurala atlasen av bilen i videon, istället för att starta om transformationen för varje tolkad ram.

Arbetsflöde för Text2Lives konsekventa transformation av en Jeep till en rostig relikt.
Text2Live är närmare ett genombrott i AI-baserad kompositing, snarare än i den fruktbara text-till-bild-rymden som har dragit så mycket uppmärksamhet den här veckan med utgåvan av den andra generationen av OpenAI:s DALL-E-ramverk (som kan inkorporera målbilder som en del av transformationsprocessen, men förblir begränsad i sin förmåga att direkt ingripa i ett foto, utöver censur av källträningsdata och påtvingande av filter, utformade för att förhindra användarmissbruk).
Text2Live tillåter istället slutanvändaren att extrahera en atlas och sedan redigera den i ett enda steg i pixelbaserade miljöer med hög grad av kontroll som Photoshop (och eventuellt ännu mer abstrakta bildsyntes-ramverk som NeRF), innan den matas tillbaka till en korrekt orienterad miljö som ändå inte förlitar sig på 3D-estimering eller CGI-metoder som håller fast vid äldre arbetssätt.
Text2Live, hävdar författarna, är det första jämförbara ramverket som uppnår maskering och kompositing på ett helt automatiskt sätt.
Publicerad första gången 7 april 2022.





