
Andersons vinkel
En maskinlärningssystem för att om skriva en artikel medan du läser den

 Lägg till Unite.AI bland dina föredragna källor på Google
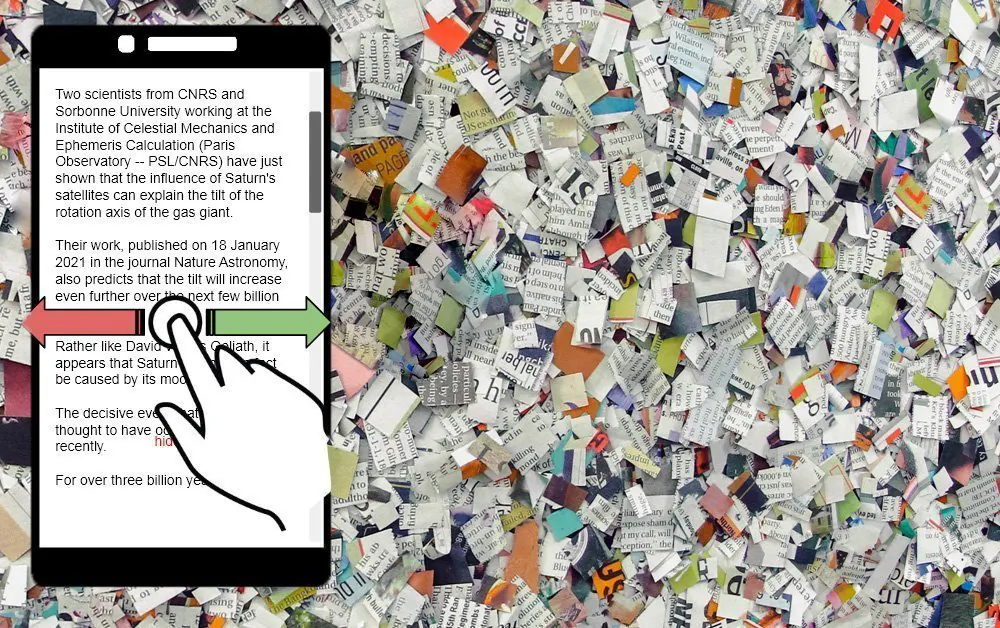
Ny forskning från Kanada föreslår en metod för att automatiskt om skriva en artikel medan du läser den, baserat på Tinder-liknande “swiping” eller på passiv observation av läsarens interaktion med olika typer av innehåll som artikeln innehåller.
Systemet, med titeln Hone As You Read (HARE), presenteras i en artikel från Western University i Ontario, Kanada, med motsvarande Python-kod på GitHub.
Det centrala idéen bakom projektet är att en artikel kan innehålla olika typer av innehåll, som utvecklas (liksom denna) från rubriken ned till ytterligare detaljer. Senare delar av en artikel kan innehålla olika typer av stödmaterial, användningsfall eller hypoteser eller antaganden om nyheternas konsekvenser.
Under HARE, om du inte gillar den typen av material, kan du rösta bort det på ett stycke-för-stycke-basis medan systemet lär sig dina preferenser, så att när du rullar ner, innehåll som liknar det material som du “ner-röstat” har redan tagits bort eller om skrivits. Om du inte vill delta aktivt i att träna systemet, kan HARE dra slutsatser om dina val genom att observera dina passiva interaktioner med dokumentet.
Tinder-liknande röstning för besvärliga meningar
I bilden nedan ser vi tre möjliga typer av inferrade kategoriseringar för HARE, baserat på användarens explicita eller implicita beteende. I det första fallet (vänster), “swipar” användaren aktivt “vänster” (eller höger), i en Tinder-liknande röstningsgest som uttrycker godkännande eller ogillande av innehållet i stycket eller meningen, eller i dess stil, komplexitet eller ton.

Källa: https://arxiv.org/pdf/2105.02923.pdf
I det andra fallet (mitten), använder systemet dwell-time som en måttstock för användarens intresse, baserat på positionen och varaktigheten av scroll-pausen.
I det tredje fallet (höger), använder HARE smartphone-kameran för att uppskatta vägen och dwell-tiden för tittarens blickläge över styckena i de synliga dokumenten.
Forskarna hävdar att ökad dwell-time på något stycke kan indikera ökat användarintresse, även om detta logiskt sett inte alltid är fallet där tittaren försöker assimilera text som kan vara komplicerad eller bara dåligt skriven.

Användarfeedback redigerar, om skriver eller raderar helt osynliga delar av artikeln.
Förbearbetning av innehåll enligt användarens preferenser
Artikeln behandlar användarupplevelsen av HARE på en per-artikel-basis, men det är tydligt att användarens historiska interaktion med dokument tillåter anpassning av framtida läsupplevelser, genom att konsekvent känna igen typer av innehåll och applicera mallade användarpreferenser på nya artiklar, så att behovet av interaktion minskar när användaren ser mindre och mindre “oönskat” innehåll.
HARE karakteriseras som en sammanfattning-algoritm, som tillåter osynligt innehåll längre ner på sidan att om skrivas i fråga om stil eller koncision innan användaren når det; men artikeln gör det tydligt att det också kan förhindra att innehåll tas bort baserat på användarfeedback.
För teständamål använde systemet en korpus på 11 222 artiklar från Storbritanniens Daily Mail-tidning, och utvärderades via en testdistribution på Telegram-chattappen. Artiklar med färre än tio stycken avsattes för teständamål.

Telegram HARE-appen i en testfas med användare.
Forskarnas metodik använder K-Means-clustering på SBERT-meningsinbäddningar i artiklarna, med initialt slumpmässiga vikter för begrepp som behandlas.
Bland en stor grupp av algoritmer och tillvägagångssätt, har HARE tre jämförelsemodeller, den första av dessa (ORACLEGREEDY) har tillgång till tidigare användarpreferenser, vilket indikerar att algoritmen kunde förbearbeta artiklar vid lastning, snarare än interaktivt.
De andra modellerna, ORACLESORTED och ORACLEUNIFORM, väljer meningar baserat på intresse eller slumpmässigt genom hela artikeln.
Innehållsborttagning och om skrivning
Förvånansvärt nog överträffade ORACLEUNIFORM kontrolluppsättningen, trots att den inte har tillgång till tidigare användarintressen. Forskarna hävdar att detta beror på att den behandlar hela artikeln i ett svep, “väljer endast de mest intressanta meningarna”. Forskarna medger att detta kan begränsa det tillgängliga innehållet till meningar som enbart behandlar det viktigaste begreppet, logiskt sett tar bort annat innehåll som kan behandla konsekvenser eller utvärdering av begreppet.
De extraktiva sammanfattningarna som används i HARE är LexRank, SumBasic och TextRank.
HARE testades på 13 frivilliga under 70 försök och varierande algoritmiska tillvägagångssätt, och kunde uppdatera sammanfattningar (om skrivna/excerperade texter) på mellan 1,3 millisekunder och 100 ms på en konsumentdator, beroende på den modell som testades. Resultaten visade att modellerna som tog bort mest text inte presterade bra, huvudsakligen eftersom detta kan påverka kohärensen i den återstående texten.
Etiska implikationer av dynamisk artikelomskrivning
Forskarna erkänner etiska problem kring teknologier av detta slag:
‘HARE-uppgiften är avsedd för designen av framtida användarorienterade applikationer. Genom designen har dessa applikationer förmågan att kontrollera vad en användare läser från en given artikel. Det är möjligt att, när de distribueras utan tillräcklig omsorg, dessa verktyg kunde förvärra “eko-kammareffekten” som redan produceras av automatiserade nyhetsflöden, sökresultat och online-samhällen.’
Men de noterar också att ett sådant system kunde användas i framtida applikationer för att mildra eko-kammareffekten genom att injicera text som föreslår alternativa perspektiv som kanske inte var närvarande i artikeln från början. De observerar: ‘Viktningsfaktorns viktning kunde justeras för att ge både en engagerande läsupplevelse och exponering för en mångfald av idéer.’
De som sannolikt kommer att dra nytta av ett sådant system, enligt forskarna, är läsare som vill spara tid på att ta in information, och innehållspublikationer.


