

Модели и платформы ИИ
Zero123++: базовая диффузионная модель для согласованных изображений с разных ракурсов по одному снимку

 Добавьте Unite.AI в избранные источники в Google

Ключевые моментыZero123++ объединяет шесть видов в одно изображение, чтобы обеспечить…
Показать больше
- Zero123++ объединяет шесть видов в одно изображение, чтобы обеспечить 3D-согласованность при генерации нескольких видов.
- В модель введено масштабированное Reference Attention для сохранения локальной текстуры из исходного одиночного изображения.
- Модель использует линейный график шума для улучшения глобальной структуры по сравнению с масштабированно-линейным графиком.
За последние несколько лет мы стали свидетелями быстрого прогресса в производительности, эффективности и генеративных возможностях новых генеративных моделей ИИ, которые используют обширные наборы данных и методы генерации 2D-диффузии. Сегодня модели генеративного AI способны генерировать различные формы 2D- и, в некоторой степени, 3D-медиаконтента, включая текст, изображения, видео, GIF и многое другое.
В этой статье мы будем говорить о фреймворке Zero123++, модели генеративного AI, которая использует диффузию для генерации 3D-согласованных многоракурсных изображений из одного входного изображения. Чтобы максимально использовать преимущества предварительно обученных моделей, фреймворк Zero123++ реализует различные методы обучения и условирования для минимизации усилий, необходимых для дообучения моделей диффузии изображений. Мы также рассмотрим архитектуру, работу и результаты фреймворка Zero123++ и проанализируем его возможности генерации согласованных многоракурсных изображений высокого качества из одного изображения. Итак, начнем.
Zero123 и Zero123++: Введение
Фреймворк Zero123++ – это модель генеративного AI, которая использует диффузию для генерации 3D-согласованных многоракурсных изображений из одного входного изображения. Фреймворк Zero123++ является продолжением фреймворка Zero123 или Zero-1-to-3, который использует метод синтеза изображений с новых ракурсов без дополнительного обучения (zero-shot), положенный в основу открытых решений преобразования одного изображения в 3D. Хотя фреймворк Zero123++ показывает перспективные результаты, изображения, сгенерированные фреймворком, имеют видимые геометрические несоответствия, и это основная причина, по которой разрыв между 3D-сценами и многоракурсными изображениями все еще существует.
Фреймворк Zero-1-to-3 служит основой для нескольких других фреймворков, включая SyncDreamer, One-2-3-45, Consistent123 и другие, которые добавляют дополнительные слои к фреймворку Zero123 для получения более согласованных результатов при генерации 3D-изображений. Другие фреймворки, такие как ProlificDreamer, DreamFusion, DreamGaussian и другие, используют оптимизационный подход для получения 3D-изображений путем дистилляции 3D-изображения из различных несогласованных моделей. Хотя эти методы эффективны и генерируют удовлетворительные 3D-изображения, результаты можно улучшить с помощью реализации базовой модели диффузии, способной генерировать многоракурсные изображения последовательно. Следовательно, фреймворк Zero123++ использует фреймворк Zero-1-to-3 и дообучает новую многоракурсную базовую модель диффузии из Stable Diffusion.
В фреймворке Zero-1-to-3 каждое новое изображение генерируется независимо, и этот подход приводит к несоответствиям между сгенерированными изображениями, поскольку диффузионные модели используют стохастическое сэмплирование. Чтобы решить эту проблему, фреймворк Zero123++ использует подход с расположением плиток, когда объект окружен шестью изображениями в одном изображении, и обеспечивает правильное моделирование совместного распределения многоракурсных изображений объекта.
Другой значительной проблемой, с которой сталкиваются разработчики, работающие над фреймворком Zero-1-to-3, является то, что он недостаточно использует возможности Stable Diffusion, что в конечном итоге приводит к неэффективности и дополнительным затратам. Есть две основные причины, по которым фреймворк Zero-1-to-3 не может максимально использовать возможности, предлагаемые Stable Diffusion
- Когда обучение проводится с условиями изображения, фреймворк Zero-1-to-3 не включает локальные или глобальные механизмы условирования, предлагаемые Stable Diffusion, эффективно.
- Во время обучения фреймворк Zero-1-to-3 использует пониженное разрешение, подход, при котором разрешение вывода уменьшается ниже разрешения обучения, что может снизить качество генерации изображений для моделей диффузии Stable Diffusion.
Чтобы решить эти проблемы, фреймворк Zero123++ реализует ряд методов условирования, которые максимизируют использование ресурсов, предлагаемых Stable Diffusion, и сохраняют качество генерации изображений для моделей диффузии Stable Diffusion.
Улучшение условирования и согласованности
В попытке улучшить условирование изображения и согласованность многоракурсных изображений фреймворк Zero123++ реализовал различные методы, с основной целью повторного использования предыдущих методов из предварительно обученной модели диффузии Stable Diffusion.
Генерация многоракурсных изображений
Необходимым качеством генерации согласованных многоракурсных изображений является правильное моделирование совместного распределения нескольких изображений. В фреймворке Zero-1-to-3 корреляция между многоракурсными изображениями игнорируется, поскольку для каждого изображения фреймворк моделирует условное маргинальное распределение вероятностей независимо и отдельно. Однако в фреймворке Zero123++ разработчики выбрали подход с расположением плиток, когда шесть изображений укладываются в одно изображение для согласованной генерации многоракурсных изображений, и процесс демонстрируется на следующем изображении.
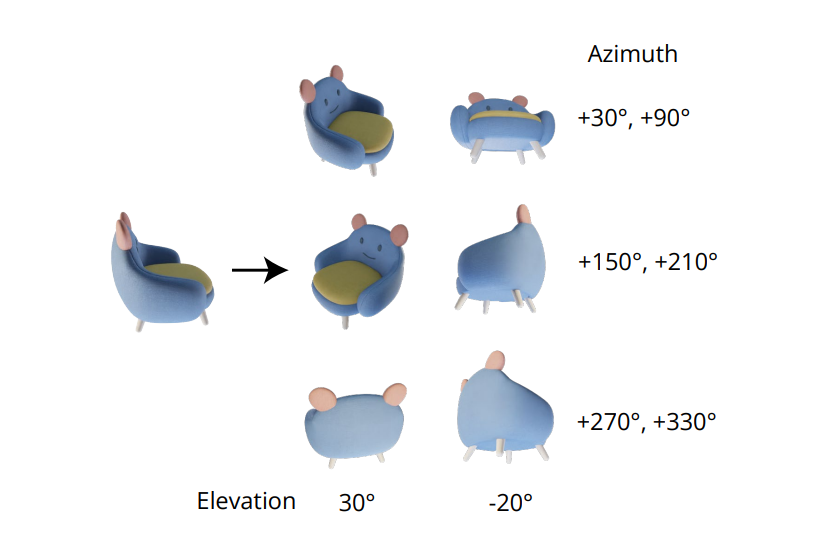

Более того, было замечено, что ориентации объектов склонны к неоднозначности при обучении модели на позах камеры, и чтобы предотвратить эту неоднозначность, фреймворк Zero-1-to-3 обучается на позах камеры с углами возвышения и относительным азимутом к входному изображению. Чтобы реализовать этот подход, необходимо знать угол возвышения вида входного изображения, который затем используется для определения относительной позы между новыми входными изображениями. В попытке узнать этот угол возвышения фреймворки часто добавляют модуль оценки возвышения, и этот подход часто приводит к дополнительным ошибкам в конвейере обработки.
График шума
Масштабированный линейный график, исходный график шума для Stable Diffusion, фокусируется в основном на локальных деталях, но, как можно увидеть на следующем изображении, он имеет очень мало шагов с более низким соотношением сигнала и шума.


Эти шаги с низким соотношением сигнала и шума происходят на ранней стадии денойзинга, стадии, которая имеет решающее значение для определения глобальной низкочастотной структуры. Уменьшение количества шагов на стадии денойзинга, либо во время инференса, либо во время обучения, часто приводит к большей структурной вариации. Хотя этот подход идеален для генерации одного изображения, он ограничивает способность фреймворка обеспечить глобальную согласованность между различными изображениями. Чтобы преодолеть это препятствие, фреймворк Zero123++ дообучает модель LoRA на фреймворке Stable Diffusion 2 v-prediction для выполнения упрощенной экспериментальной задачи, и результаты демонстрируются ниже.

С масштабированным линейным графиком шума модель LoRA не переобучается, но только немного осветляет изображение. Напротив, при работе с линейным графиком шума фреймворк LoRA генерирует пустое изображение успешно, независимо от входного запроса, что указывает на влияние графика шума на способность фреймворка адаптироваться к новым требованиям глобально.
Масштабированное ссылочное внимание для локальных условий
Входное изображение с одного ракурса или условные изображения в фреймворке Zero-1-to-3 конкатенируются с шумными входными данными по измерению признаков для шумных условий изображения.
Эта конкатенация приводит к неправильному пиксельному соответствию между целевым изображением и входным изображением. Чтобы обеспечить правильное локальное условное входное изображение, фреймворк Zero123++ использует масштабированное ссылочное внимание, подход, при котором запускается денойзинговая модель UNet на дополнительном ссылочном изображении, а затем добавляются матрицы значений и матрицы ключей механизма самовнимания из ссылочного изображения к соответствующим слоям внимания, когда входные данные модели денойзятся, и это демонстрируется на следующем рисунке.

Подход ссылочного внимания способен направлять модель диффузии на генерацию изображений, которые имеют схожую текстуру с ссылочным изображением, и семантическое содержание без дообучения. С дообучением подход ссылочного внимания обеспечивает лучшие результаты с масштабированным латентом.

Глобальное условирование: FlexDiffuse
В исходном подходе Stable Diffusion текстовые эмбеддинги являются единственным источником глобальных эмбеддингов, и подход использует фреймворк CLIP в качестве текстового кодировщика для применения перекрестного внимания (оригинал ошибочно называет это cross-examinations) между текстовыми эмбеддингами и латентными переменными модели. В результате разработчики могут использовать соответствие между текстовыми пространствами и результирующими изображениями CLIP для глобального условирования изображений.
Фреймворк Zero123++ предлагает использовать обучаемую версию линейного механизма управления для включения глобального условирования изображения в фреймворк с минимальным дообучением, и результаты демонстрируются на следующем изображении. Как можно увидеть, без глобального условирования изображения качество содержания, сгенерированного фреймворком, удовлетворительно для видимых областей, соответствующих входному изображению. Однако качество изображения, сгенерированного фреймворком для невидимых областей, значительно ухудшается, что в основном связано с неспособностью модели выводить глобальную семантику объекта.

Архитектура модели
Фреймворк Zero123++ обучается на модели Stable Diffusion 2v с использованием различных подходов и методов, упомянутых в статье. Фреймворк Zero123++ предварительно обучен на наборе данных Objaverse, отрендеренном с случайным освещением HDRI. Фреймворк также использует подход фазового расписания обучения, используемого в фреймворке Stable Diffusion Image Variations, для дальнейшего минимизации количества дообучения и сохранения как можно большей части предварительно обученной модели Stable Diffusion.
Работа или архитектура фреймворка Zero123++ может быть разделена на последовательные шаги или фазы. Первая фаза включает дообучение матриц ключей и значений (KV) слоев перекрестного внимания и слоев само-внимания модели Stable Diffusion с оптимизатором AdamW, 1000 шагов разогрева и косинусным графиком скорости обучения, максимизирующимся при 7×10⁻⁵. На второй фазе фреймворк использует очень консервативную постоянную скорость обучения с 2000 шагами разогрева и использует подход Min-SNR для максимизации эффективности во время обучения.
Zero123++: Результаты и сравнение производительности
Качественная производительность
Чтобы оценить производительность фреймворка Zero123++ на основе качества сгенерированных изображений, его сравнивают с SyncDreamer и Zero-1-to-3-XL, двумя из лучших фреймворков для генерации контента. Фреймворки сравниваются на четырех входных изображениях с разным объемом. Первое изображение – это электрическая игрушечная кошка, взятая напрямую из набора данных Objaverse, и имеет большую неопределенность на заднем конце объекта. Второе изображение – это изображение огнетушителя, а третье – изображение собаки, сидящей на ракете, сгенерированное моделью SDXL. Последнее изображение – это иллюстрация аниме. Необходимые углы возвышения для фреймворков достигаются с помощью метода оценки возвышения фреймворка One-2-3-4-5, и удаление фона выполняется с помощью фреймворка SAM. Как можно увидеть, фреймворк Zero123++ генерирует высококачественные многоракурсные изображения последовательно и способен обобщать на двумерные иллюстрации вне обучающего распределения, а также на изображения, созданные ИИ.


Количественный анализ
Чтобы количественно сравнить фреймворк Zero123++ с фреймворками Zero-1-to-3 и Zero-1-to-3-XL, разработчики оценивают метрику обученного перцептивного сходства патчей изображений (LPIPS) этих моделей на наборе данных валидации, подмножестве набора данных Objaverse. Чтобы оценить производительность модели на генерацию многоракурсных изображений, разработчики укладывают изображения-эталоны и шесть сгенерированных изображений соответственно, а затем вычисляют коэффициент LPIPS. Результаты демонстрируются ниже, и как можно увидеть, фреймворк Zero123++ достигает лучшей производительности на наборе данных валидации.

Оценка текста в многоракурсные изображения
Чтобы оценить способность фреймворка Zero123++ генерировать многоракурсные изображения из текста, разработчики сначала используют фреймворк SDXL с текстовыми запросами для генерации изображения, а затем применяют фреймворк Zero123++ к сгенерированному изображению. Результаты демонстрируются на следующем изображении, и как можно увидеть, по сравнению с фреймворком Zero-1-to-3, который не может гарантировать согласованную генерацию многоракурсных изображений, фреймворк Zero123++ возвращает согласованные, реалистичные и высокодетализированные многоракурсные изображения, реализуя подход текст→изображение→многоракурсные изображения.

Zero123++ Depth ControlNet
Помимо базового фреймворка Zero123++, разработчики также выпустили фреймворк Depth ControlNet Zero123++, версию фреймворка с контролем глубины, построенную на основе архитектуры ControlNet. Нормализованные линейные изображения рендерятся с учетом последующих RGB-изображений, и фреймворк ControlNet обучается для управления геометрией фреймворка Zero123++ с помощью глубинного восприятия.


Заключение
В этой статье мы говорили о фреймворке Zero123++, модели генеративного AI, которая использует диффузию для генерации 3D-согласованных многоракурсных изображений из одного входного изображения. Чтобы максимально использовать преимущества предварительно обученных моделей, фреймворк Zero123++ реализует различные методы обучения и условирования для минимизации усилий, необходимых для дообучения моделей диффузии изображений. Мы также обсудили различные подходы и улучшения, реализованные фреймворком Zero123++, которые позволяют ему достигать результатов, сравнимых с, и даже превышающих результаты, достигнутые текущими фреймворками.
Однако, несмотря на его эффективность и способность генерировать высококачественные многоракурсные изображения последовательно, фреймворк Zero123++ все еще имеет некоторое место для улучшения, с потенциальными областями исследований, такими как двухэтапная модель уточнения, которая может решить неспособность фреймворка Zero123++ удовлетворять глобальным требованиям согласованности. Дополнительные масштабирования для дальнейшего улучшения способности фреймворка Zero123++ генерировать изображения еще более высокого качества.
- Двухэтапная модель уточнения которая может решить неспособность фреймворка Zero123++ удовлетворять глобальным требованиям согласованности.
- Дополнительные масштабирования для дальнейшего улучшения способности фреймворка Zero123++ генерировать изображения еще более высокого качества.


