
Взгляд Anderson
Как Stable Diffusion может стать массовым потребительским продуктом

 Добавьте Unite.AI в избранные источники в Google
Ключевые моментыОсновному приложению Stable Diffusion необходимо решить сложные проблемы установки…
Показать больше
- Основному приложению Stable Diffusion необходимо решить сложные проблемы установки через командную строку и зависимости.
- Коммерческие разработчики сталкиваются с юридическими рисками из-за создания дипфейков и фильтров NSFW-контента.
- Продвинутые функции, такие как временная согласованность и текстуальная инверсия, требуют облачной обработки для потребительского использования.
Иронично, что Stable Diffusion, новый фреймворк синтеза изображений на основе ИИ, который взял мир штурмом, не является ни стабильным, ни действительно “распространенным” – по крайней мере, пока.
Полный диапазон возможностей системы распределен по различным постоянно меняющимся предложениям от небольшой группы разработчиков, которые активно обмениваются последней информацией и теориями в различных обсуждениях на Discord – и большинство процедур установки пакетов, которые они создают или изменяют, очень далеки от «установил и пользуйся».
Вместо этого они обычно требуют установки через командную строку или BAT-файлы через GIT, Conda, Python, Miniconda и другие передовые фреймворки разработки – программные пакеты, которые очень редки среди обычных пользователей, поэтому их установка часто определяется антивирусными и поставщиками средств защиты от вредоносного ПО как доказательство компрометации системы.

Лишь небольшая часть этапов, которые требует стандартная установка Stable Diffusion. Многие из этих дистрибутивов также требуют конкретных версий Python, которые могут конфликтовать с существующими версиями, установленными на компьютере пользователя – хотя это можно обойти с помощью установок на основе Docker и, в определенной степени, с помощью использования сред Conda.
Темы сообщений в обоих SFW- и NSFW-сообществах Stable Diffusion переполнены советами и трюками, связанными с взломом скриптов Python и стандартных установок, чтобы улучшить функциональность или решить частые ошибки зависимостей и другие проблемы.
Это оставляет среднего потребителя, заинтересованного в создании удивительных изображений из текстовых подсказок, практически на милость растущего числа монетизированных веб-интерфейсов API, большинство из которых предлагает минимальное количество бесплатных генераций изображений перед покупкой токенов.
Кроме того, почти все эти веб-ориентированные предложения отказываются выводить NSFW-контент (многое из которого может относиться к непорнографическим предметам общего интереса, таким как “война”), который отличает Stable Diffusion от цензурированных услуг OpenAI DALL-E 2.
‘Photoshop для Stable Diffusion’
Глядя на фантастические, провокационные или потусторонние изображения, ежедневно появляющиеся в Twitter под хэштегом #stablediffusion, широкая публика ждет ‘Photoshop для Stable Diffusion’ – кроссплатформенное устанавливаемое приложение, которое включает в себя лучшую и наиболее мощную функциональность архитектуры Stability.ai, а также различные изобретательные инновации, возникающие в сообществе разработчиков SD, без всплывающих окон командной строки, неясных и постоянно меняющихся процедур установки и обновления, или отсутствующих функций.
Что мы сейчас имеем, в большинстве более способных установок, – это различные элегантные веб-страницы, расположенные рядом с окном командной строки, и чей URL – это localhost-порт:

Похожим образом на CLI-ориентированные приложения синтеза, такие как FaceSwap и BAT-ориентированный DeepFaceLab, ‘prepack’-установка Stable Diffusion демонстрирует свои корни командной строки, с интерфейсом, доступным через localhost-порт (см. верхнюю часть изображения выше), который общается с функциональностью Stable Diffusion на основе CLI.
Без сомнения, более удобное приложение уже на подходе. Уже есть несколько приложений на основе Patreon, которые можно скачать, такие как GRisk и NMKD (см. изображение ниже) – но ни одно из них пока не интегрирует полный диапазон функций, который некоторые из более продвинутых и менее доступных реализаций Stable Diffusion могут предложить.

Ранние, основанные на Patreon пакеты Stable Diffusion, лишь отчасти оформленные как полноценные приложения. NMKD – первое, которое интегрирует вывод CLI напрямую в GUI.
Давайте посмотрим, как может выглядеть более отполированная и интегрированная реализация этого замечательного продукта с открытым кодом – и с какими проблемами она может столкнуться.
Правовые вопросы для хорошо финансируемого коммерческого приложения Stable Diffusion
Фактор NSFW
Исходный код Stable Diffusion был выпущен под очень либеральной лицензией, которая не запрещает коммерческие реализации и производные работы, которые строятся на основе исходного кода.
Помимо вышеупомянутых и растущего числа приложений на основе Patreon, а также обширного количества плагинов для приложений, разрабатываемых для Figma, Krita, Photoshop, GIMP и Blender (среди других), нет практической причины, почему хорошо финансируемый разработчик программного обеспечения не мог бы разработать гораздо более сложное и способное приложение Stable Diffusion. С точки зрения рынка, есть все основания полагать, что несколько таких инициатив уже хорошо продвинуты.
Здесь такие усилия сразу же сталкиваются с дилеммой о том, разрешит ли приложение отключить встроенный NSFW-фильтр Stable Diffusion (фрагмент кода), как большинство веб-API для Stable Diffusion.
‘Закопать’ Переключатель NSFW
Хотя открытая лицензия Stability.ai на Stable Diffusion включает в себя довольно широкий и интерпретируемый список применений, для которых его нельзя использовать (вероятно, включая порнографический контент и дипфейки), единственный способ, которым поставщик может эффективно запретить такое использование, – это скомпилировать NSFW-фильтр в непрозрачный исполняемый файл вместо параметра в файле Python, или же обеспечить сравнение контрольной суммы на файле Python или DLL, содержащем NSFW-директиву, так что рендеринг не может произойти, если пользователи изменяют эту настройку.
Это оставит предполагаемое приложение “кастрированным” таким же образом, как DALL-E 2 в настоящее время, уменьшая его коммерческую привлекательность. Кроме того, неизбежно, декомпилированные “подделанные” версии этих компонентов (или исходных элементов среды выполнения Python, или скомпилированных DLL-файлов, как в линии инструментов Topaz AI) появятся в сообществе торрентов/хакинга, чтобы обойти такие ограничения, просто заменив препятствующие элементы и отменив любые требования к контрольной сумме.
В конце концов, поставщик может просто повторить предупреждение Stability.ai против злоупотребления, которое характеризует первый запуск многих текущих распределений Stable Diffusion.
Однако небольшие разработчики открытого ПО, которые в настоящее время используют неформальные оговорки об ответственности такого рода, имеют мало что терять по сравнению с компанией программного обеспечения, которая вложила значительное количество времени и денег в то, чтобы сделать Stable Diffusion полнофункциональным и доступным – что требует более глубокого рассмотрения.
Ответственность за Дипфейки
Как мы недавно отметили, база данных LAION-эстетики, часть 4,2 миллиарда изображений, на которых были обучены текущие модели Stable Diffusion, содержит большое количество изображений знаменитостей, что позволяет пользователям эффективно создавать дипфейки, включая дипфейк-порнографию знаменитостей.

Из нашей недавней статьи, четыре этапа Дженнифер Коннелли за четыре десятилетия ее карьеры, выведенные из Stable Diffusion.
Это отдельный и более спорный вопрос, чем создание (обычно) законной “абстрактной” порнографии, которая не изображает “реальных” людей (хотя такие изображения выводятся из нескольких реальных фотографий в обучающем материале).
Поскольку все больше штатов США и стран разрабатывают или ввели законы против дипфейк-порнографии, способность Stable Diffusion создавать дипфейки знаменитостей может означать, что коммерческое приложение, которое не полностью цензурировано (т.е. которое может создавать порнографический материал), все равно может потребовать некоторой способности фильтровать воспринимаемые лица знаменитостей.
Одним из методов может быть предоставление встроенного “черного списка” терминов, которые не будут приняты в пользовательской подсказке, связанных с именами знаменитостей и вымышленными персонажами, с которыми они могут быть связаны. Предположительно, такие настройки потребуется реализовать на нескольких языках, поскольку исходные данные содержат другие языки. Другой подход может заключаться в включении систем распознавания знаменитостей, таких как те, которые разработаны Clarifai.
Возможно, что производителям программного обеспечения придется включать такие методы, возможно, изначально отключенные, что может помочь предотвратить полноценное автономное приложение Stable Diffusion от генерации лиц знаменитостей, в ожидании нового законодательства, которое может сделать такую функциональность незаконной.
Опять же, однако, такая функциональность могла бы неизбежно быть декомпилирована и обращена интересованными сторонами; однако производитель программного обеспечения мог бы, в таком случае, заявить, что это фактически несанкционированный вандализм – пока такая обратная инженерия не делается чрезмерно легкой.
Функции, которые Могут быть Включены
Основная функциональность в любой реализации Stable Diffusion будет ожидаться от любой хорошо финансируемого коммерческого приложения. Это включает в себя возможность использовать текстовые подсказки для генерации подходящих изображений (текст-изображение); возможность использовать эскизы или другие изображения в качестве ориентиров для новых сгенерированных изображений (изображение-изображение); средства для регулирования того, насколько творчески система должна интерпретировать подсказку; возможность повышать качество за счет увеличения времени рендеринга; и другие “базовые” функции, такие как опциональное автоматическое архивирование изображений/подсказок и рутинное опциональное масштабирование через RealESRGAN, и, по крайней мере, базовое “исправление лица” с помощью GFPGAN или CodeFormer.
Это довольно “ванильная” установка. Давайте посмотрим на некоторые из более продвинутых функций, которые в настоящее время разрабатываются или расширяются, которые могли бы быть включены в полноценное “традиционное” приложение Stable Diffusion.
Стохастическое Замораживание
Даже если вы повторно используете начальное значение генератора (seed) из предыдущего успешного рендеринга, это ужасно трудно заставить Stable Diffusion точно повторить преобразование, если любая часть подсказки или исходного изображения (или обоих) изменяется для последующего рендеринга.
Это проблема, если вы хотите использовать EbSynth, чтобы навязать преобразования Stable Diffusion на реальное видео в временно согласованном виде – хотя этот метод может быть очень эффективным для простых кадров с головой и плечами:
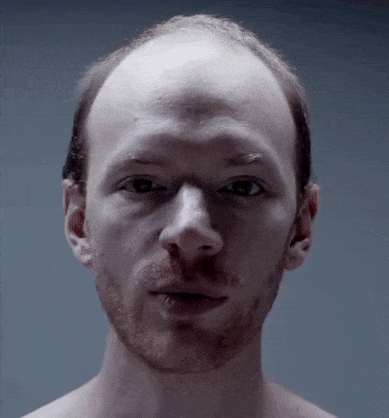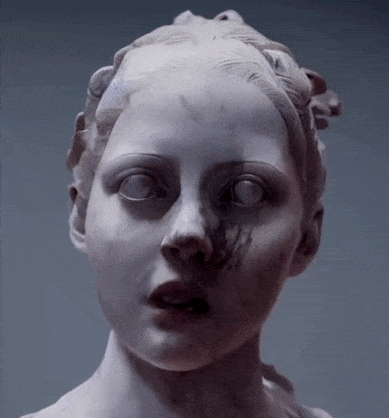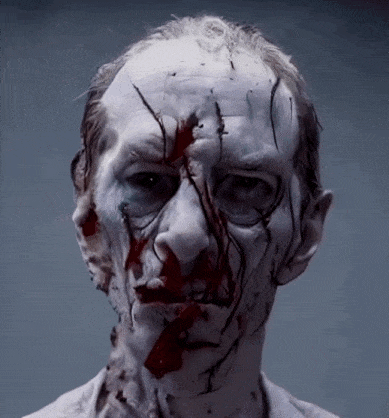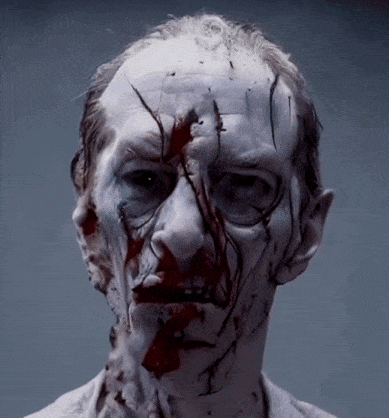
Ограниченное движение может сделать EbSynth эффективным средством для превращения преобразований Stable Diffusion в реалистичное видео. Источник: https://streamable.com/u0pgzd
ЭбСинт работает путем экстраполяции небольшого выбора “измененных” ключевых кадров в видео, которое было отрендерено в серию файлов изображений (и которое может быть позже собрано обратно в видео).

В этом примере с сайта EbSynth небольшая горсть кадров из видео была нарисована в художественной манере. ЭбСинт использует эти кадры в качестве ориентиров для аналогичного изменения всего видео, чтобы оно соответствовало нарисованному стилю. Источник: https://www.youtube.com/embed/eghGQtQhY38
В примере ниже, который включает почти никакого движения от (реальной) блондинки-йогини слева, Stable Diffusion все равно имеет трудности с поддержанием последовательного лица, потому что три изображения, которые преобразуются в качестве “ключевых кадров”, не являются полностью идентичными, даже если они все имеют одинаковый числовой seed.

Здесь, даже с одинаковой подсказкой и значением seed для всех трех преобразований, и очень немногими изменениями между исходными кадрами, мышцы тела варьируются в размере и форме, но более важно, что лицо меняется от кадра к кадру, препятствуя временной согласованности в потенциальном рендере EbSynth.
Хотя SD/ЭбСинт-видео ниже очень изобретательно, где пальцы пользователя превращаются в (соответственно) ходячую пару брюк и утку, несогласованность брюк типифицирует проблему, с которой Stable Diffusion сталкивается в поддержании согласованности между разными ключевыми кадрами, даже когда исходные кадры похожи друг на друга, а начальное значение генератора (seed) неизменно.
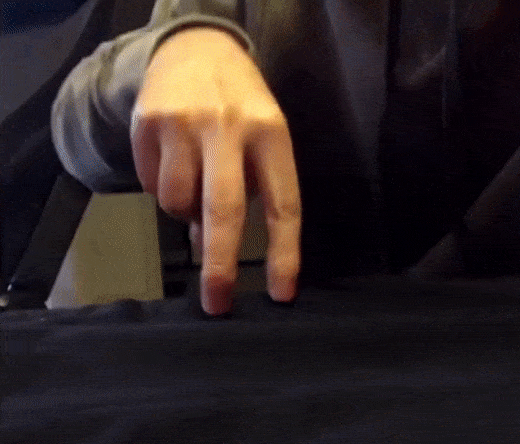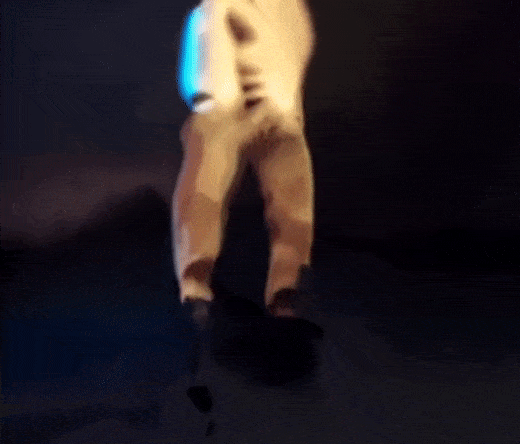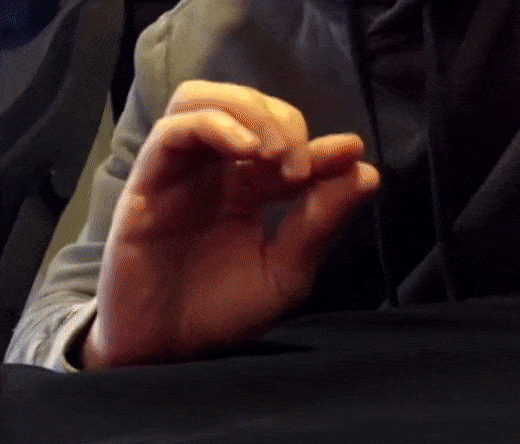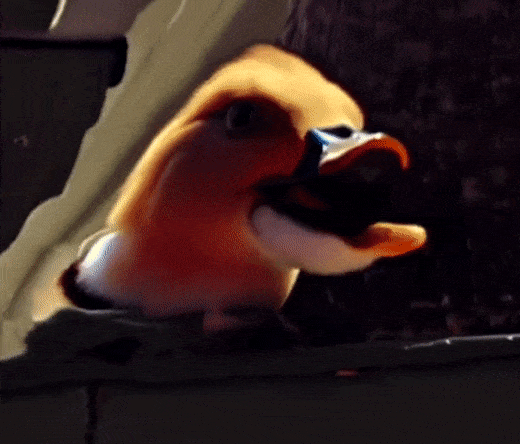
Пальцы человека превращаются в ходячего человека и утку, с помощью Stable Diffusion и EbSynth. Источник: https://old.reddit.com/r/StableDiffusion/comments/x92itm/proof_of_concept_using_img2img_ebsynth_to_animate/
Пользователь, который создал это видео комментировал, что преобразование в утку, пожалуй, более удачное, хотя и менее впечатляющее и оригинальное, потребовало лишь одного преобразованного ключевого кадра, в то время как для создания ходячих брюк потребовалось отрендерить 50 изображений Stable Diffusion, которые демонстрируют большую временную несогласованность. Пользователь также отметил, что потребовалось пять попыток, чтобы достичь согласованности для каждого из 50 ключевых кадров.
Следовательно, было бы большим преимуществом для действительно всестороннего приложения Stable Diffusion предоставить функциональность, которая сохраняет характеристики до максимальной степени между ключевыми кадрами.
Одной из возможностей является то, что приложение позволяет пользователю “заморозить” стохастическое кодирование для преобразования на каждом кадре, что в настоящее время можно достичь только путем изменения исходного кода вручную. Как показывает пример ниже, это помогает временной согласованности, хотя оно определенно не решает ее:
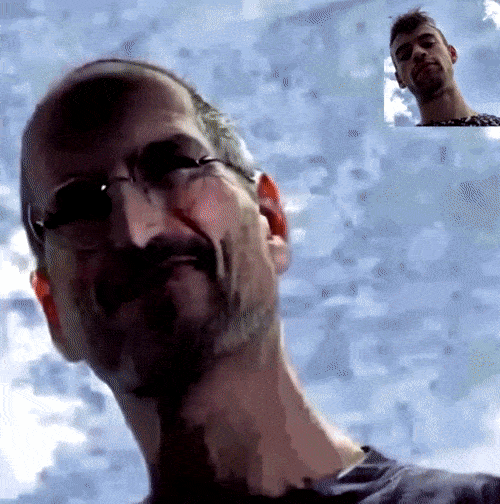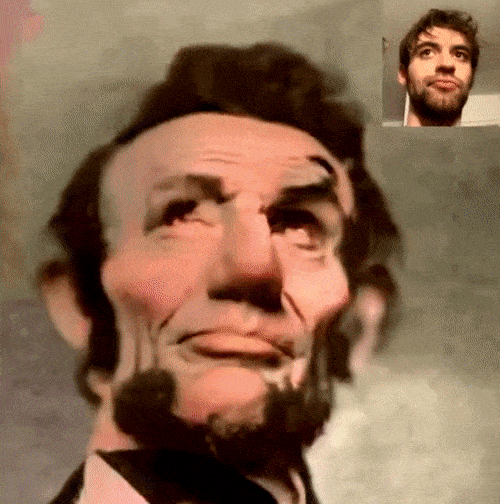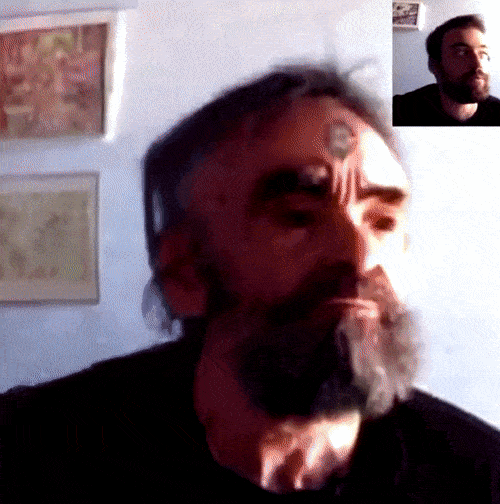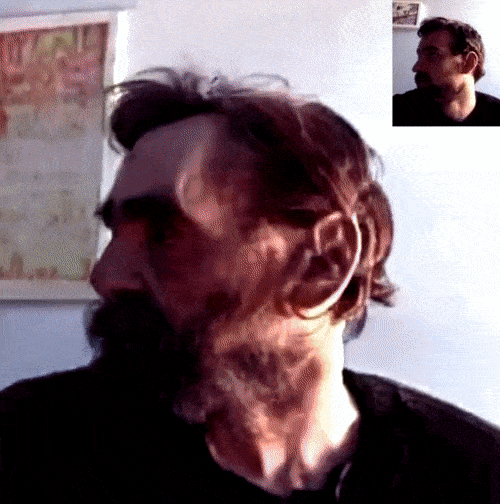
Один пользователь Reddit преобразовал кадры веб-камеры себя в разных знаменитых людей, не только сохраняя начальное значение генератора (seed) (что может сделать любая реализация Stable Diffusion), но и обеспечивая, чтобы параметр stochastic_encode() был идентичен в каждом преобразовании. Это было достигнуто путем изменения кода, но могло бы легко стать доступным переключателем для пользователя. Ясно, однако, что это не решает все проблемы согласованности во времени. Источник: https://old.reddit.com/r/StableDiffusion/comments/wyeoqq/turning_img2img_into_vid2vid/
Облачная текстовая инверсия
Лучшее решение для получения согласованных во времени персонажей и объектов – это “запечатать” их в текстовую инверсию – файл размером 5 КБ, который можно обучить за несколько часов на основе только пяти аннотированных изображений, который затем может быть вызван специальной ‘*’ подсказкой, позволяя, например, постоянному появлению новых персонажей для включения в повествование.

Изображения, связанные с подходящими тегами, могут быть преобразованы в отдельные сущности через текстовую инверсию, и вызваны без двусмысленности, и в правильном контексте и стиле, с помощью специальных токен-слов. Источник: https://huggingface.co/docs/diffusers/training/text_inversion
Текстовые инверсии – это дополнительные файлы к очень большой и полностью обученной модели, которую использует Stable Diffusion, и эффективно “запускаются” в процессе вызова/подсказки, так что они могут участвовать в сценах, полученных из модели, и извлекать пользу из огромной базы знаний модели о объектах, стилях, средах и взаимодействиях.
Однако, хотя обучение текстовой инверсии не занимает много времени, она требует большого количества видеопамяти; согласно различным текущим учебным пособиям, 12, 20 и даже 40 ГБ.
Поскольку большинство обычных пользователей вряд ли имеют такой объем видеопамяти, облачные услуги уже появляются, которые будут обрабатывать операцию, включая версию Hugging Face. Хотя есть реализации Google Colab, которые могут создавать текстовые инверсии для Stable Diffusion, необходимые требования к видеопамяти и времени могут сделать их сложными для пользователей бесплатного тарифа Colab.
Для потенциального полноценного и хорошо инвестированного приложения Stable Diffusion передача этого тяжелого задания на облачные серверы компании кажется очевидной стратегией монетизации (предполагая, что низкозатратное или бесплатное приложение Stable Diffusion содержит такие платные функции, что, вероятно, в многих приложениях, которые возникнут из этой технологии в течение следующих 6-9 месяцев).
Кроме того, довольно сложный процесс аннотирования и форматирования представленных изображений и текста мог бы выиграть от автоматизации в интегрированной среде. Потенциальный “аддиктивный фактор” создания уникальных элементов, которые могут исследовать и взаимодействовать с огромными мирами Stable Diffusion, мог бы быть потенциально компульсивным, как для общих энтузиастов, так и для более молодых пользователей.
Гибкое управление весами подсказок
Существует много текущих реализаций, которые позволяют пользователю присвоить большее значение разделу длинной текстовой подсказки, но инструментарий варьируется довольно сильно между ними и часто бывает неуклюжим или неинтуитивным.
Очень популярный форк Stable Diffusion от AUTOMATIC1111, например, может уменьшить или повысить значение слова подсказки, заключив его в одну или несколько пар круглых скобок (для снижения значения) или квадратные скобки для дополнительного акцента.

Квадратные скобки и/или круглые скобки могут преобразовать ваш завтрак в этой версии весовых промптов Stable Diffusion, но это кошмар холестерина в любом случае.
Другие итерации Stable Diffusion используют восклицательные знаки для акцента, в то время как наиболее универсальные позволяют пользователям присваивать веса каждому слову в подсказке через GUI.
Система также должна позволять отрицательные веса промптов – не только для фанатов ужасов, но и потому, что могут быть менее тревожные и более просвещающие тайны в латентном пространстве Stable Diffusion, чем наше ограниченное использование языка может вызвать.
Расширение Изображения
Вскоре после того, как Stable Diffusion был открыт, OpenAI попытался – в основном безуспешно – вернуть DALL-E 2 часть утраченного внимания, объявив “расширение изображения”, которое позволяет пользователю расширить изображение за его границы с сохранением семантической логики и визуальной согласованности.
Естественно, это было реализовано в различных формах для Stable Diffusion, а также в Krita, и должно быть включено в всестороннюю, “фотошопоподобную” версию Stable Diffusion.
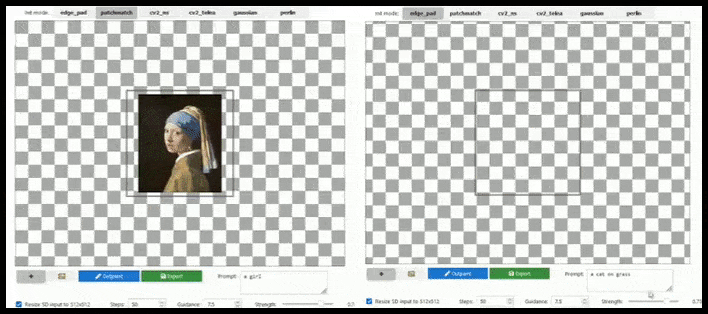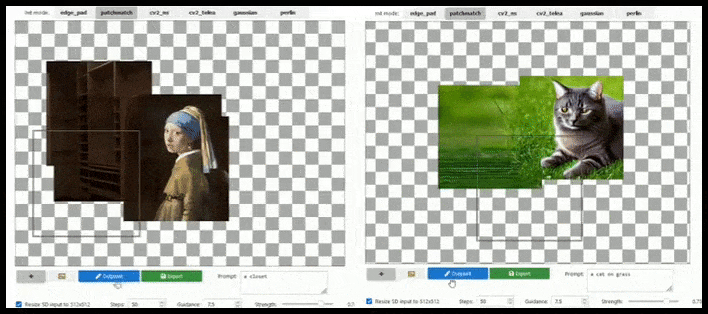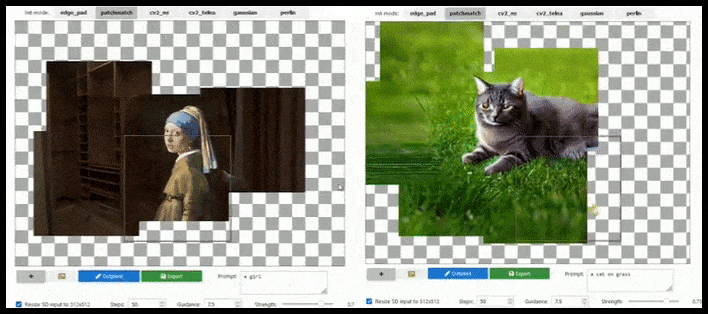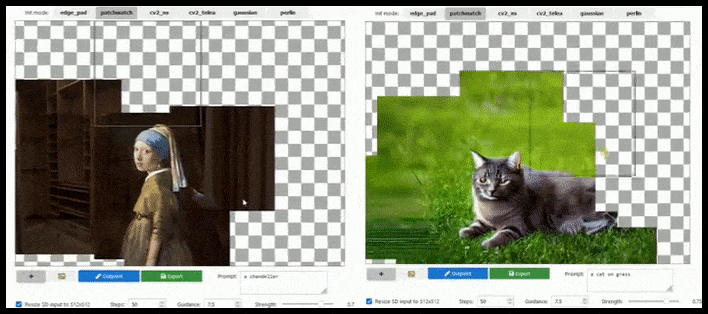
Расширение на основе блоков может расширить стандартный рендер 512×512 пикселей почти бесконечно, пока подсказки, существующее изображение и семантическая логика позволяют это. Источник: https://github.com/lkwq007/stablediffusion-infinity
Поскольку Stable Diffusion обучен на изображениях 512×512 пикселей (и по ряду других причин), он часто отрезает головы (или другие важные части тела) людей, даже когда подсказка явно указывает “акцент на голове” и т. д..

Типичные примеры “обезглавливания” Stable Diffusion; но расширение изображения могло бы вернуть Джорджа обратно в картину.
Любая реализация расширения изображения такого типа, как показано на анимированном изображении выше (которое основано исключительно на библиотеках Unix, но должно быть способно быть воспроизведенным на Windows), также должна быть инструментом с одним кликом/подсказкой для устранения этой проблемы.
В настоящее время многие пользователи расширяют холст “обезглавленных” изображений вверх, примерно заполняют область головы и используют img2img, чтобы завершить испорченный рендер.
Эффективное Маскирование, Понимающее Контекст
Маскирование может быть очень непредсказуемым делом в Stable Diffusion, в зависимости от форка или используемой версии. Часто, когда это возможно нарисовать связную маску, указанная область заканчивается тем, что заполнена контентом, который не учитывает весь контекст изображения.
В один раз я замаскировал роговицы глаз на изображении лица и предоставил подсказку ‘голубые глаза’ в качестве маски inpaint – только чтобы обнаружить, что я, кажется, смотрю через два вырезанные человеческие глаза на отдаленное изображение потустороннего волка. Я думаю, я счастлив, что это не был Фрэнк Синатра.
Семантическое редактирование также возможно путем определения шума, который первоначально создал изображение, что позволяет пользователю обратиться к конкретным структурным элементам в рендере без вмешательства в остальную часть изображения:

Изменение одного элемента в изображении без традиционного маскирования и без изменения соседнего контента, путем определения шума, который первоначально создал изображение, и обращения к частям, которые внесли свой вклад в целевую область. Источник: https://old.reddit.com/r/StableDiffusion/comments/xboy90/a_better_way_of_doing_img2img_by_finding_the/
Этот метод основан на K-Diffusion-сэмплере.
Семантические Фильтры для Физиологических Ошибок
Как мы упоминали ранее, Stable Diffusion может часто добавлять или удалять конечности, в основном из-за проблем с данными и недостатков в аннотациях, которые сопровождают изображения, которые обучили его.

Как тот непослушный ребенок, который высунул язык на групповом фото в школе, биологические ужасы Stable Diffusion не всегда сразу очевидны, и вы можете опубликовать в Instagram свой последний ИИ-шедевр, прежде чем вы заметите лишние руки или расплавленные конечности.
Это так трудно исправить эти виды ошибок, что было бы полезно, если бы полноценное приложение Stable Diffusion содержало некоторую систему анатомического распознавания, которая использовала бы семантическую сегментацию для расчета того, содержит ли входящее изображение серьезные анатомические дефекты (как на изображении выше), и отклоняет его в пользу нового рендеринга, прежде чем представить его пользователю.

Конечно, вы можете захотеть отрендерить богиню Кали, или Доктора Октопуса, или даже спасти неповрежденную часть изображения с ошибками в конечностях – поэтому эта функция должна быть опциональным переключателем.
Если пользователи могут терпеть аспект телеметрии, такие промахи даже могут быть переданы анонимно в коллективное усилие федеративного обучения, которое может помочь будущим моделям улучшить их понимание анатомической логики.
Автоматическое улучшение лиц на основе LAION
Как я отметил в своем предыдущем взгляде на три вещи, которые Stable Diffusion мог бы решить в будущем, не должно быть оставлено исключительно на усмотрение GFPGAN попытаться “улучшить” отрендеренные лица в первичных рендерингах.
“Улучшения” GFPGAN крайне шаблонны, часто подрывают идентичность изображенного человека и работают исключительно на лице, которое обычно изначально сгенерировано плохо, поскольку получило не больше времени обработки или внимания, чем любая другая часть изображения.
Следовательно, профессиональная программа для Stable Diffusion должна быть в состоянии распознать лицо (с помощью стандартной и относительно легкой библиотеки, такой как YOLO), применить полный вес доступной мощности GPU к пере-рендерингу его и либо смешать улучшенное лицо с исходным рендерингом в полном контексте, либо сохранить его отдельно для ручной рекомпозиции. В настоящее время это довольно “ручная” операция.
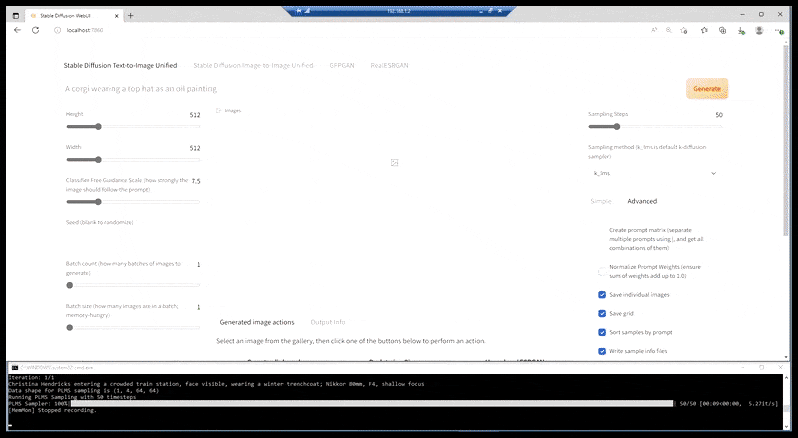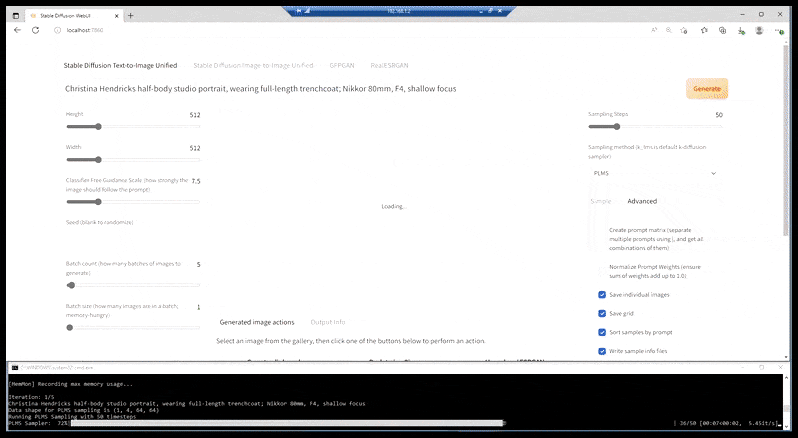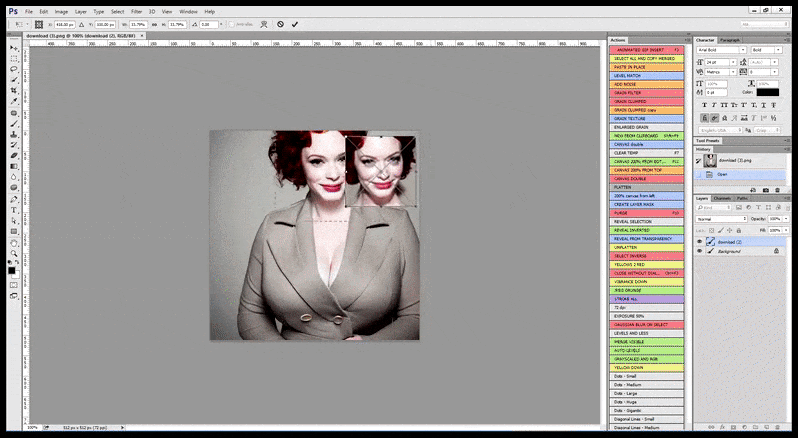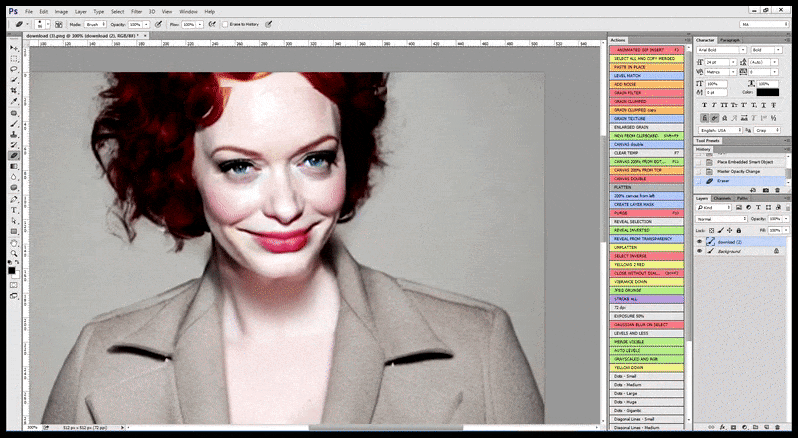
В случаях, когда Stable Diffusion был обучен на достаточном количестве изображений знаменитости, возможно сосредоточить всю мощность GPU на последующем рендеринге только лица отрендеренного изображения, что обычно является заметным улучшением – и, в отличие от GFPGAN, опирается на информацию из данных LAION, а не просто корректирует отрендеренные пиксели.
Поиск по LAION внутри приложения
Поскольку пользователи начали понимать, что поиск базы данных LAION для концепций, людей и тем может помочь в лучшем использовании Stable Diffusion, были созданы несколько онлайн-обозревателей LAION, включая haveibeentrained.com.

Функция поиска на haveibeentrained.com позволяет пользователям исследовать изображения, которые управляют Stable Diffusion, и обнаружить, были ли объекты, люди или идеи, которые они могут захотеть вызвать из системы, вероятно, присутствовали в обучающих данных. Такие системы также помогают находить смежные сущности: например, группы знаменитостей или «следующую идею», вытекающую из текущей. Источник: https://haveibeentrained.com/?search_text=bowl%20of%20fruit
Хотя такие веб-ориентированные базы данных часто раскрывают некоторые теги, которые сопровождают изображения, процесс генерализации, который происходит во время обучения модели, означает, что вряд ли какое-либо конкретное изображение может быть вызвано, используя его тег в качестве подсказки.
Кроме того, удаление ‘стоп-слов’ и практика стемминга и лемматизации в обработке естественного языка означает, что многие из фраз, отображаемых на дисплее, были разбиты или опущены перед обучением в Stable Diffusion.
Тем не менее, то, как эстетические группировки связаны в этих интерфейсах, может научить конечного пользователя многое о логике (или, аргументируемо, “личности”) Stable Diffusion и помочь в лучшем производстве изображений.
Заключение
Существует много других функций, которые я бы хотел видеть в полноценной нативной настольной реализации Stable Diffusion, таких как встроенный анализ изображений на основе CLIP, который обращает стандартный процесс Stable Diffusion и позволяет пользователю вызвать фразы и слова, которые система естественным образом ассоциирует с исходным изображением, или рендерингом.
Кроме того, настоящее масштабирование на основе плиток было бы желательным дополнением, поскольку ESRGAN почти так же груб, как и GFPGAN. К счастью, планы по интеграции txt2imghd реализации GOBIG быстро делают это реальностью во всех распределениях, и кажется очевидным выбором для настольной итерации.
Некоторые другие популярные запросы из сообществ Discord интересуют меня меньше, такие как интегрированные словари подсказок и применимые списки художников и стилей, хотя встроенная тетрадь или настраиваемый лексикон фраз казался бы логическим дополнением.
Текущие ограничения человеческой анимации в Stable Diffusion, хотя и были запущены CogVideo и другими проектами, остаются невероятно незрелыми и находятся на милости исследований в области априорных закономерностей реального движения человека во времени.
На данный момент видео Stable Diffusion строго психоделическое, хотя оно может иметь более светлое ближайшее будущее в дипфейк-кукловодстве через EbSynth и другие относительно новые текст-видео-инициативы (и стоит отметить отсутствие синтезированных или “измененных” людей в последнем промо-видео Runway).
Другая ценная функциональность была бы беспрепятственным обменом изображениями с Photoshop, давно установленным в редакторе текстур Cinema4D, среди других аналогичных реализаций. С этим можно легко переключаться между приложениями и использовать каждое приложение для выполнения преобразований, которые оно выполняет лучше всего.
Наконец, и, возможно, наиболее важно, полноценная программа Stable Diffusion должна быть в состоянии не только легко переключаться между контрольными точками (т.е. версиями базовой модели, которая управляет системой), но также должна быть в состоянии обновлять пользовательские текстовые инверсии, которые работали с предыдущими официальными выпусками модели, но могут быть сломаны более поздними версиями модели (как указали разработчики на официальном Discord).
Иронично, что организация, которая находится в лучшей позиции для создания такого мощного и интегрированного набора инструментов для Stable Diffusion, Adobe, так сильно связала себя с Content Authenticity Initiative, что может показаться шагом назад в плане PR для компании – если только она не собирается ограничить генеративные силы Stable Diffusion так же, как OpenAI сделал с DALL-E 2, и позиционировать его вместо этого как естественную эволюцию своих обширной коллекции стоковых фотографий.
Опубликовано впервые 15 сентября 2022 года.


