
Взгляд Anderson
Машина обучения для переписывания статьи во время чтения

 Добавьте Unite.AI в избранные источники в Google
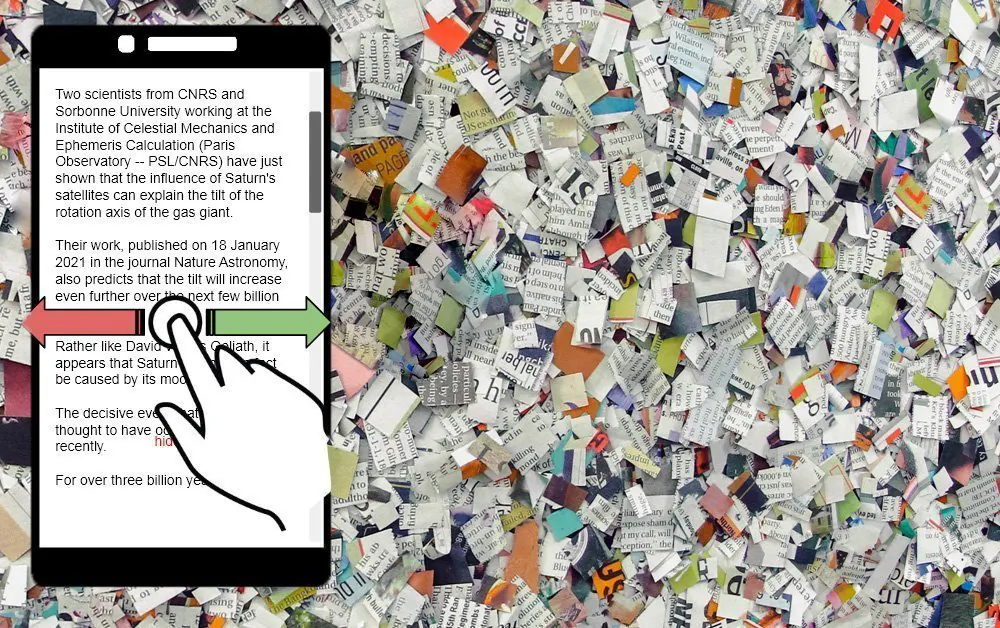
Новые исследования из Канады предлагают метод автоматического переписывания статьи во время чтения, основанный на принципе “swiping” в стиле Tinder или на пассивном наблюдении за взаимодействием читателя с различными типами контента, содержащимися в статье.
Система, получившая название Hone As You Read (HARE), представлена в статье Западного университета в Онтарио, Канада, с соответствующим кодом на Python на GitHub.
Центральная идея проекта заключается в том, что статья может содержать различные типы контента, эволюционирующие (как и эта) от заголовка до дальнейших деталей. Поздние части статьи могут содержать различные виды поддерживающего материала, примеры использования, гипотезы или предположения о последствиях новости.
Под HARE, если вам не нравится такой материал, вы можете проголосовать против него на основе каждого абзаца, пока система учит ваши предпочтения, так что к моменту прокрутки вниз контент, подобный материалу, который вы “проголосовали против”, уже был удален или переписан. Если вы не хотите активно участвовать в обучении системы, HARE может сделать вывод о ваших выборах, наблюдая за вашими пассивными взаимодействиями с документом.
Голосование в стиле Tinder для неприятных предложений
На изображении ниже мы видим три возможных типа выводимой категоризации для HARE, основанной на явном или неявном поведении пользователя. В первом случае (слева) пользователь активно “проводит влево” (или вправо), в жесте голосования в стиле Tinder, выражающем одобрение или неодобрение контента абзаца или предложения, или его стиля, сложности или тона.

Источник: https://arxiv.org/pdf/2105.02923.pdf
Во втором случае (центр) система использует время задержки как метрику интереса пользователя, основанную на позиционировании и продолжительности паузы прокрутки.
В третьем случае (справа) HARE использует камеру смартфона для оценки пути и времени задержки положения взгляда пользователя на абзацы видимых документов.
Исследователи утверждают, что увеличение времени задержки на любом абзаце может указывать на повышенный интерес пользователя, хотя логически это может не быть так, когда читатель пытается усвоить текст, который может быть сложным или просто плохо написанным.

Обратная связь пользователя эффективно редактирует, переписывает или полностью удаляет еще не видимые части статьи.
Предварительная обработка контента в соответствии с предпочтениями пользователя
Статья рассматривает опыт пользователя HARE на основе каждой статьи, но rõчно, что историческое взаимодействие пользователя с документами позволяет настраивать будущий опыт чтения, последовательно распознавая типы контента и применяя шаблонные предпочтения пользователя к новым статьям, так что необходимость взаимодействия уменьшается, когда пользователь видит меньше и меньше “нежелательного” контента.
HARE характеризуется как алгоритм суммирования, позволяющий не видимому контенту ниже страницы быть переписанным в плане стиля или краткости до того, как пользователь доберется до него; но статья делает ясно, что он также может предварительно удалить контент на основе обратной связи пользователя.
Для целей тестирования система использовала корпус из 11 222 статей из британской газеты Daily Mail и была оценена через тестовую установку на приложении Telegram. Статьи с менее чем десятью абзацами были исключены для целей испытаний.

Приложение Telegram HARE в тестовой фазе с пользователями.
Методология исследователей использует K-Means clustering на SBERT sentence embeddings в статьях, с изначально случайными весами для концепций.
Среди широкой группы алгоритмов и подходов HARE включает три сравнительные модели, первая из которых (ORACLEGREEDY) имеет доступ к предыдущим предпочтениям пользователя, указывающим на то, что алгоритм может предварительно обработать статьи при загрузке, а не интерактивно.
Остальные модели, ORACLESORTED и ORACLEUNIFORM, выбирают предложения на основе уровня интереса или случайным образом на протяжении всей статьи.
Удаление и переписывание контента
Удивительно, что ORACLEUNIFORM превосходит контрольную установку, даже хотя он не имеет доступа к предыдущим интересам пользователя. Исследователи утверждают, что это потому, что он занимается всей статьей за один раз, “выбирая только наиболее интересные предложения”. Исследователи признают, что это может ограничить доступный контент до тех предложений, которые занимаются только наиболее важной концепцией, логически удаляя другой текст, который может заниматься последствиями или оценкой концепции.
Используемые в HARE extractive суммирователи – LexRank, SumBasic и TextRank.
HARE был протестирован на 13 волонтерах в течение 70 испытаний и различных алгоритмических подходов и смог обновлять суммирования (переписанные/удаленные тексты) за время от 1,3 миллисекунд до 100 мс на ноутбуке потребительского класса, в зависимости от модели, проходящей испытания. Результаты показали, что модели, удаляющие наиболее текст, не работают хорошо, в основном потому, что это может повлиять на связность оставшегося текста.
Этические последствия динамического переписывания статей
Исследователи признают этические проблемы, связанные с технологиями этого типа:
‘Задача HARE предназначена для разработки будущих приложений, ориентированных на пользователя. По конструкции эти приложения имеют возможность контролировать то, что пользователь читает из данной статьи. Возможно, что при развертывании без достаточного ухода эти инструменты могут усугубить эффект “эхо-камеры”, уже производимый автоматизированными новостными лентами, результатами поиска и онлайн-сообществами.’
Однако они также отмечают, что такая система может быть использована в будущих приложениях для смягчения эффекта “эхо-камеры”, вводя текст, предлагающий альтернативные точки зрения, которые могут не быть изначально присутствующими в статье. Они замечают: ‘Вес этого фактора может быть настроен для обеспечения увлекательного опыта чтения и воздействия на разнообразие идей.’
Те, кто, вероятно, выиграет от такой системы, согласно исследователям, – это читатели, которые хотят сэкономить время на восприятие информации, и издатели контента.


